Intelligenza artificiale locale: cos'è, come funziona e quando conviene alle aziende
L'intelligenza artificiale locale è un modello che gira su server o PC dell'azienda invece che sui sistemi di un fornitore. Vediamo come funziona, quanto costa rispetto alle API, quali dati restano in casa e quando il cloud resta la scelta migliore.
Pubblicato il
L'intelligenza artificiale locale è un modello linguistico che gira su server, workstation o PC dell'azienda invece che sui sistemi di un fornitore esterno. Se l'installazione è configurata bene, prompt, documenti e risposte restano nell'infrastruttura aziendale. Conviene quando i dati sono riservati, quando i volumi sono alti e stabili o quando serve lavorare senza connessione. Con volumi bassi o variabili, o quando serve la qualità massima dei modelli di frontiera, il cloud resta spesso la scelta più sensata.
Cos'è l'intelligenza artificiale locale, e cosa la distingue da un servizio cloud?
Un'intelligenza artificiale locale è un LLM open-weight, cioè un modello di cui il produttore pubblica i pesi, eseguito su hardware dell'azienda. Domande, documenti consultati e risposte non passano dai sistemi di un fornitore. Con un servizio cloud (API o abbonamenti di chat) il calcolo avviene presso il fornitore: si paga a token o a postazione e i dati transitano dai suoi server.
| Termine | Dove gira il modello | Connessione a Internet |
|---|---|---|
| Locale | Su hardware controllato dall'azienda, anche un singolo PC | Non serve per rispondere |
| On-premise | Su server aziendali o in un'infrastruttura gestita dall'azienda | Di solito presente, ma il modello non dipende da servizi esterni |
| Offline | Su hardware isolato dalla rete esterna | Assente durante l'uso |
Un'AI locale non è un modello addestrato da zero sui dati aziendali. Si usano modelli già pronti, collegati ai documenti con il RAG: il sistema cerca i passaggi pertinenti e li passa al modello insieme alla domanda. È quello che chiamo cervello aziendale. Per le varianti ci sono la pagina sull'AI on-premise e la guida all'intelligenza artificiale offline.
Come funziona un'intelligenza artificiale locale, dal modello all'interfaccia?
Servono quattro elementi:
- I pesi del modello, scaricati dal produttore.
- Un motore di inferenza, il programma che carica il modello e genera le risposte.
- L'hardware: GPU con memoria sufficiente oppure macchine a memoria unificata.
- Un'interfaccia: una chat interna o un'integrazione con posta, ERP e CRM.
Tra i motori di inferenza ci sono Ollama e SGLang, quest'ultimo usato da Cloudflare per servire i modelli su Workers AI (fonte). Le novità arrivano di continuo: secondo le release di Ollama, la versione 0.40.5 ha aggiunto Nemotron 3.5 Super, un modello MoE da 120 miliardi di parametri con 12 miliardi attivi, e Nemotron 3.5 Bolt da 74 miliardi (9 attivi), descritto come ottimizzato per una GPU NVIDIA da 24 GB.
Nei modelli MoE (mixture of experts) per ogni token lavora solo una parte dei parametri, quelli attivi, quindi il calcolo è più leggero di quanto suggerisca la dimensione totale. Flint di Recursive, per esempio, ha 40 miliardi di parametri totali, circa 2,5 attivi, e licenza Apache 2.0 (release di Ollama).
Anche i modelli piccoli contano. LFM3 di Liquid AI ha un modello di testo da 1,7 miliardi di parametri che occupa circa 1 GB a 4 bit. Nei benchmark del fornitore supera Qwen3.5-9B sull'uso di strumenti (BFCL V4: 71,39 contro 62,83), ma perde su GPQA Diamond (63,37 contro 80,40). Liquid AI stessa riconosce che i modelli più grandi restano davanti nella programmazione con agenti e nella conoscenza. La licenza è indicata solo come "open-weight": va verificata prima di un uso commerciale. Quando si dimensiona un server conta anche la memoria per il contesto (KV cache), non solo la dimensione del modello.
Per cosa usano l'AI le aziende italiane, e cosa le frena?
Secondo l'Istat, nel 2025 usa l'intelligenza artificiale il 16,4% delle imprese con almeno 10 addetti, contro l'8,2% del 2024; le PMI sono al 15,7%, le grandi imprese al 53,1%. La media europea calcolata da Eurostat per il 2025 è del 19,95%.
Tra le imprese italiane che usano l'IA, il 70,8% la impiega per estrarre informazioni da documenti di testo (Istat). È proprio il caso d'uso di un assistente sui documenti interni, in cloud o in locale.
Tra chi non la usa, gli ostacoli più citati nel comunicato Istat sono la mancanza di competenze (58,6%), la scarsa chiarezza delle norme (47,3%), dati assenti o di scarsa qualità (45,2%), privacy e protezione dei dati (43,2%) e costi elevati (43,0%). L'AI locale interviene sulla privacy e, in alcuni casi, sui costi. Non risolve competenze né qualità dei dati: anzi, richiede qualcuno che la gestisca, internamente o tramite un fornitore.
Quali dati escono con un servizio cloud, e cosa resta in casa con l'AI locale?
Con il cloud, prompt e documenti arrivano al fornitore e restano lì per un tempo che dipende da piano e impostazioni. In locale restano nell'infrastruttura aziendale, se l'installazione è configurata bene.
Le impostazioni predefinite cambiano. Il changelog delle API Gemini indica che dal 26 ottobre 2026 i nuovi progetti a pagamento conservano le richieste di default (store=true); si disattiva con store=false o dalla dashboard Logs. Secondo la documentazione sui log, i log scadono dopo 55 giorni, finestra riducibile a 7, 14 o 28 giorni, mentre quelli salvati in un dataset non scadono. Sulla pagina prezzi, il livello gratuito dei modelli Flash riporta "Used to improve our products: Yes", quello a pagamento "No".
Esistono anche incidenti documentati. Cloudflare ha ricostruito che su Workers AI, tra il 27 agosto e il 9 settembre 2026, 155 risposte hanno contenuto dati di altri clienti: ne parlo nell'articolo sull'isolamento dei dati nelle API AI. E il rischio non riguarda solo i modelli: il preprint Penny for Your Prompts, che la pagina non indica come sottoposto a revisione, ha trovato che 9 piattaforme di chat AI su 42 inviano i prompt parola per parola a terze parti.
I piani aziendali danno garanzie più solide degli account personali: Anthropic dichiara che con Claude Enterprise i dati non vengono usati per l'addestramento "by default". Scegliere dove vengono elaborati i dati, però, si paga: OpenAI applica un aumento del 10% sugli endpoint regionali per i modelli rilasciati dal 5 marzo 2026, Anthropic un moltiplicatore di 1,1x per l'inferenza limitata agli Stati Uniti.
Anche il locale va mantenuto: Cloudflare raccomanda a chiunque usi SGLang di aggiornarlo almeno alla versione 0.5.22 (fonte), e questo vale anche sui propri server.
Quanto costa l'AI in cloud rispetto a un'intelligenza artificiale locale?
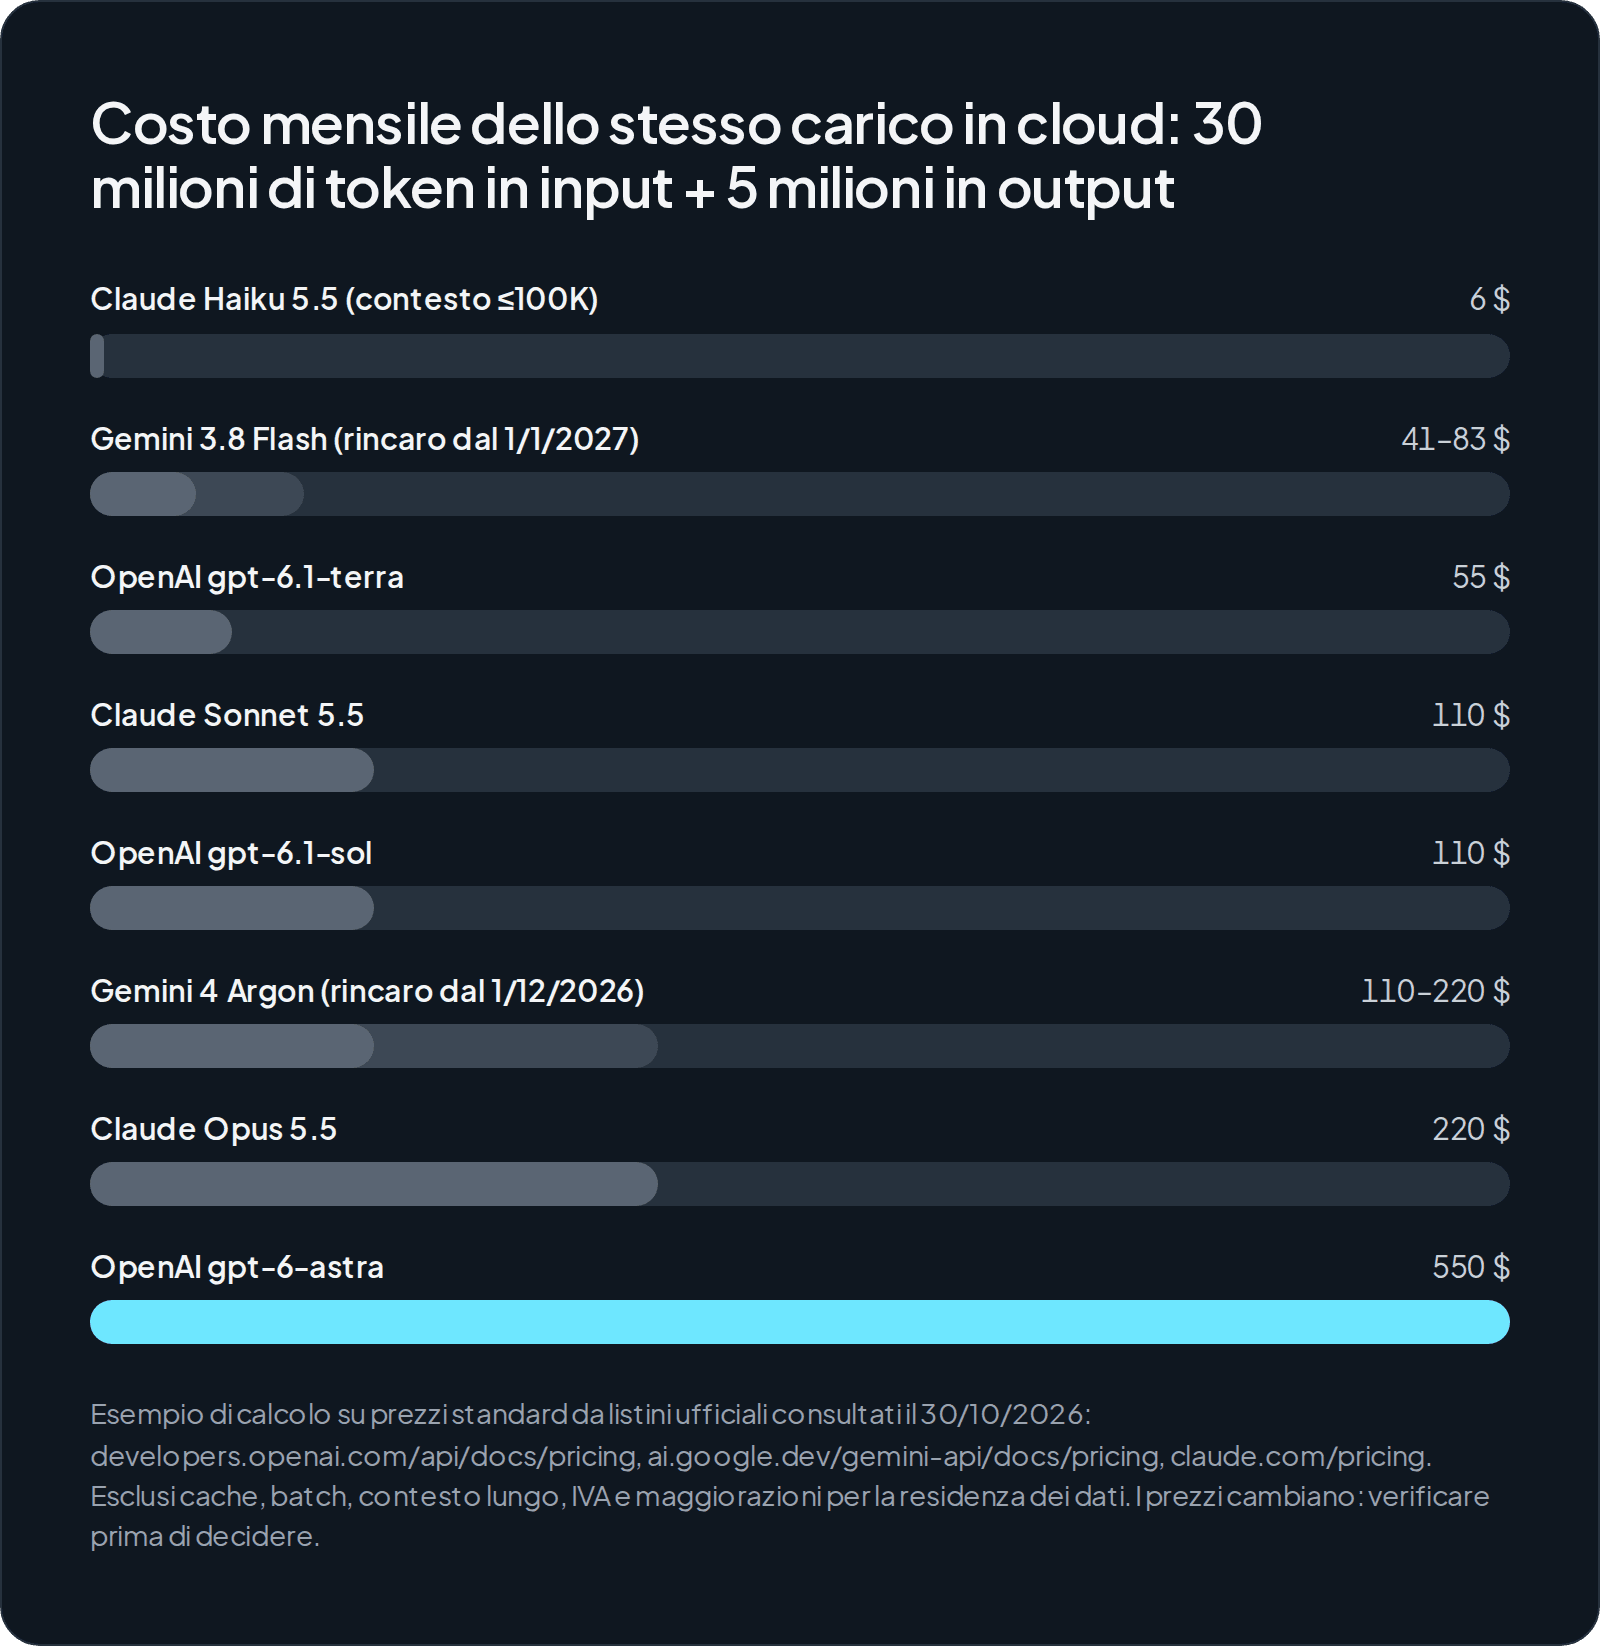
In cloud il costo cresce con l'uso e con il numero di persone. In locale è soprattutto fisso: hardware, installazione, assistenza ed energia. Il locale può convenire con volumi alti e stabili, oppure quando i dati non devono uscire.
Gli abbonamenti per utente seguono un'altra logica. Sulla pagina prezzi di Claude il piano Team costa 20 $ per postazione al mese con fatturazione annuale (25 $ mensile); Enterprise parte da 20 $ per postazione con un minimo di 20 postazioni, più l'uso a tariffe API.
Il confronto va fatto onestamente: per volumi come quelli dell'esempio, anche il modello cloud più caro costa molto meno dell'ipotesi locale. Il locale si giustifica con volumi molto più alti, molti utenti o vincoli sui dati che escludono il cloud. Il metodo è spiegato nella pagina sui costi dell'AI in locale e nell'articolo su quando conviene un server AI invece delle API.
Quando il cloud conviene più dell'intelligenza artificiale locale?
Il cloud conviene con volumi bassi o variabili, quando serve la qualità massima su compiti complessi, quando nessuno in azienda può gestire un server o quando si vuole una prova in poche settimane. I piani aziendali offrono anche controlli maturi: Claude Enterprise prevede SSO, accessi per ruolo e tetti di spesa per organizzazione, gruppo e singolo membro (fonte). Come usarli bene è spiegato nella pagina sui modelli di frontiera in azienda.
| Criterio | Va verso il cloud | Va verso il locale |
|---|---|---|
| Volumi | Bassi o molto variabili | Alti e prevedibili |
| Dati | Non sensibili o già coperti da contratto | Riservati, regolati, da non far uscire |
| Qualità richiesta | Massima su compiti complessi | Compiti mirati (classificare, estrarre, cercare nei documenti) |
| Competenze interne | Nessuno che gestisca un server | Personale o fornitore che lo mantenga |
| Connessione | Sempre disponibile | Ambienti isolati o senza rete |
Spesso la risposta è ibrida: il modello locale gestisce dati riservati e passaggi ripetitivi, quello di frontiera i passaggi difficili su dati che possono uscire. Progettare questa divisione processo per processo è il lavoro della consulenza AI per i processi aziendali. Per un confronto più ampio c'è l'articolo AI locale vs cloud.
Quali regole servono anche con un'intelligenza artificiale locale?
Il locale riduce i dati che escono, ma non rende l'azienda conforme in automatico. Servono permessi su chi vede quali documenti, registri d'uso, una policy scritta e formazione. Gli obblighi sui dati personali restano anche se il modello gira in casa: ne parlo nella pagina su AI e GDPR. Sugli aspetti di protezione dei dati legati ai modelli di AI l'EDPB ha pubblicato il parere 28/2024.
I registri servono a capire come viene usato lo strumento, non a valutare le persone. Lo scrive anche Anthropic, secondo cui i suoi report "aren't for evaluating individual performance or making employment decisions" (fonte). Prima di attivare registri dettagliati conviene coinvolgere chi si occupa di lavoro e privacy in azienda.
E uno strumento interno funziona solo se è utile. Altrimenti le persone tornano agli account personali, con i rischi descritti nell'articolo su cosa fare se un dipendente carica dati su un'AI non autorizzata.
Da dove partire con l'intelligenza artificiale locale in azienda?
Nel mio lavoro il percorso che funziona meglio è graduale:
- Scegliere un solo processo con dati sensibili e volumi misurabili: domande sui documenti interni, classificazione delle email, estrazione di dati da ordini o DDT.
- Stimare i token consumati o attesi e confrontarli con i listini aggiornati (annotando la data) e con il costo su tre anni di un'installazione locale.
- Provare due o tre modelli open-weight sui propri dati, con domande di prova di cui si conosce la risposta, prima di comprare hardware.
- Leggere le licenze dei modelli candidati.
- Decidere chi gestisce aggiornamenti, sicurezza, permessi e registri.
Se vuoi capire se nel tuo caso l'intelligenza artificiale locale ha senso, puoi chiedere una valutazione. Se il locale conviene, server e software si possono fornire già configurati. Se invece conviene il cloud o un approccio ibrido, te lo dico con i numeri.
Domande frequenti
Serve una connessione Internet per usare un'intelligenza artificiale locale?
No. Una volta scaricati i pesi del modello e installato il motore di inferenza, il modello può rispondere anche senza connessione. Serve però controllare che interfacce, plugin e strumenti di monitoraggio non contattino comunque servizi esterni. La connessione torna utile solo per scaricare aggiornamenti e nuovi modelli, operazione che si può pianificare.
Basta un normale PC aziendale per far girare un modello in locale?
Per i modelli piccoli spesso sì. Il modello di testo LFM3 di Liquid AI, per esempio, occupa circa 1 GB a 4 bit. Questi modelli vanno bene per compiti mirati come classificare, estrarre dati o riassumere. Per un assistente usato da molte persone o per compiti complessi servono GPU dedicate o un server. Il dimensionamento dipende dal modello, dalla lunghezza dei testi e da quanti utenti lo usano insieme.
I modelli open-weight si possono usare liberamente per scopi commerciali?
Dipende dalla licenza di ciascun modello. Alcuni, come Flint di Recursive, sono rilasciati con licenza Apache 2.0, che permette l'uso commerciale. Altri sono descritti solo come 'open-weight' senza indicare la licenza, oppure hanno licenze con limiti specifici. Prima di metterli in produzione bisogna leggere la licenza: non basta che i pesi siano scaricabili.
Si possono usare insieme un modello locale e un modello di frontiera in cloud?
Sì, ed è spesso la scelta più sensata. Il modello locale gestisce i passaggi su dati riservati o molto ripetitivi, quello in cloud i compiti più difficili su dati che possono uscire. Servono regole chiare su quali dati vanno a quale modello e un registro che lo renda verificabile.
Ogni quanto va aggiornato un modello installato in locale?
Non c'è una scadenza imposta dal fornitore, ed è uno dei vantaggi rispetto al cloud, dove i modelli vengono ritirati. I motori di inferenza invece vanno aggiornati con regolarità per correggere bug e problemi di sicurezza. Il modello si cambia quando ne esce uno migliore per i propri casi d'uso, dopo averlo provato sui propri dati.
Chi scrive
Lilium AI
AI nei processi aziendali: in locale per i dati sensibili, con i modelli di frontiera per il resto
Da leggere dopo
AI locale vs cloud: differenze, vantaggi, svantaggi e quale scegliere nel 2026
Locale o cloud? Le differenze reali per un'azienda: listini a token e per utente, rincari e ritiri programmati dei modelli, dove finiscono i dati, quanto sono maturi gli open-weight e in quali casi il cloud resta la scelta migliore.
AI in locale e on-premise12 min
AI on-premise: guida completa per installare l'intelligenza artificiale sui server aziendali
Cosa significa installare l'intelligenza artificiale sui server aziendali: differenze con il cloud, componenti dello stack, fasi del progetto, limiti reali e per chi ha senso.
AI in locale e on-premise9 min
Intelligenza artificiale offline: come utilizzare un LLM senza connessione Internet
Un LLM può funzionare senza connessione Internet, su server o PC aziendali. Spieghiamo cosa serve, come evitare che un'installazione "locale" contatti comunque servizi esterni, quanto costa rispetto alle API e quando conviene restare in cloud.
AI offline e industria8 min