Quando conviene acquistare un server AI invece di pagare le API?
Comprare un server AI conviene quando i volumi sono alti e stabili, i dati sono sensibili e c'è chi lo gestisce. Partendo dai rincari dei listini e da un preprint sul punto di pareggio vediamo come fare i conti, e quando le API restano la scelta migliore.
Pubblicato il
Nella scelta tra server AI o API, comprare l'hardware di solito conviene solo con tre condizioni insieme: volumi di token alti e stabili, dati che non devono uscire dall'azienda e qualcuno in grado di gestire il sistema. Se ne manca anche una, le API dei grandi fornitori restano spesso la scelta più semplice. I rincari annunciati spostano il punto di pareggio, ma non allo stesso modo per tutti: Gemini 4 Argon, per esempio, raddoppia il prezzo dal 1° dicembre 2026 secondo la pagina prezzi di Google.
Server AI o API: quale criterio decide davvero?
Decide la combinazione di volume, sensibilità dei dati e capacità di gestione, non un singolo numero. Un server costa soprattutto all'inizio, mentre le API crescono con l'uso. La domanda utile è: con i miei volumi e i miei vincoli, cosa costa meno su tre anni?
| Criterio | Spinge verso le API | Spinge verso il server |
|---|---|---|
| Volume mensile di token | Basso o ancora da misurare | Alto e misurato |
| Variabilità | Picchi stagionali, progetti a termine | Carico regolare, processi ripetitivi |
| Sensibilità dei dati | Dati pubblici o poco riservati | Dati personali, contratti, know-how |
| Qualità richiesta | Serve il modello più potente | Un modello open-weight medio basta |
| Competenze interne | Nessuno può seguire un server | Reparto IT o partner di assistenza |
| Orizzonte | Meno di un anno | Almeno tre anni |
Un preprint su arXiv dedicato al punto di pareggio la descrive come "a continuous optimization problem rather than a one-time decision": una scelta da rivedere nel tempo, non da prendere una volta per tutte. Le voci di costo del locale sono nella pagina sui costi dell'AI in locale, mentre casi d'uso e limiti sono nella pagina sull'AI on-premise.
Quanto costano oggi le API dei modelli di frontiera, e quanto possono salire?
Vanno da 0,10 $ a 50 $ per milione di token, a seconda del modello e del tipo di token, e alcuni listini sono già in aumento. Qui sotto i prezzi Standard consultati il 29 ottobre 2026 sulle pagine ufficiali di OpenAI, Anthropic e Google. I listini cambiano: vanno ricontrollati prima di ogni decisione.
| Fornitore | Modello | Input ($/M token) | Output ($/M token) |
|---|---|---|---|
| OpenAI | gpt-6-astra (fino a 272K token) | 10,00 | 50,00 |
| OpenAI | gpt-6.1-sol | 2,00 | 10,00 |
| OpenAI | gpt-6-luna | 0,10 | 0,50 |
| Anthropic | Opus 5.5 | 4,00 | 20,00 |
| Anthropic | Sonnet 5.5 | 2,00 | 10,00 |
| Anthropic | Haiku 5.5 (fino a 100K token) | 0,10 | 0,50 |
| Gemini 4 Argon | 2,00 → 4,00 dal 1/12/2026 | 10,00 → 20,00 dal 1/12/2026 | |
| Gemini 3.8 e 3.6 Flash | 0,75 → 1,50 dal 1/1/2027 | 3,75 → 7,50 dal 1/1/2027 |
Su Gemini raddoppiano anche Batch, Flex e Priority (Google). I dettagli sono nell'articolo sui prezzi delle API di Gemini. Al listino base si aggiungono i sovrapprezzi:
- Contesti lunghi: oltre i 272K token gpt-6-astra sale a 20 $ in input e 75 $ in output (OpenAI).
- Elaborazione regionale: gli endpoint regionali OpenAI costano il 10% in più per i modelli usciti dal 5 marzo 2026 (OpenAI). Su Claude l'elaborazione solo negli USA costa 1,1 volte il prezzo base (Anthropic).
- Velocità: il Fast mode porta gpt-6.1-sol a 4/20 $ (OpenAI), la modalità veloce di Opus costa 2 volte il prezzo base (Anthropic).
I prezzi possono anche scendere. Il Batch costa la metà sia da OpenAI, che a metà prezzo offre anche il Flex, sia da Anthropic. Per i lavori che possono aspettare, la soglia oltre cui conviene un server si sposta più in là.
Perché gli abbonamenti per utente non sono un costo fisso?
Perché il prezzo del posto è fisso, ma l'uso, i limiti e le condizioni no. Sulla pagina prezzi di Claude il piano Team costa 20 $ al mese per utente con fatturazione annuale (25 $ mensile) per il posto Standard, e 100 $ o 125 $ per il Premium. L'Enterprise costa 20 $ per utente con un minimo di 20 posti, più l'uso pagato alle tariffe API. I limiti seguono una finestra di 5 ore più limiti settimanali non pubblicati, e "Price and plans are subject to change at Anthropic's discretion".
Il 28 ottobre 2026 Anthropic ha introdotto su Enterprise i budget comuni per gruppo, con avvisi al 50, 75, 95 e 100%. Lo strumento è utile, e conferma che la spesa va tenuta sotto controllo. Lo stesso annuncio spiega che i nuovi report analizzano "a sample of the team's transcripts": un aspetto da valutare anche per la privacy dei dipendenti.
Un server, al contrario, ha un costo in gran parte fisso che non cresce con le persone. Ha però una capacità massima: oltre una certa soglia di richieste contemporanee serve altro hardware, oppure i tempi di risposta si allungano.
Cosa dice la ricerca sul punto di pareggio di un server AI?
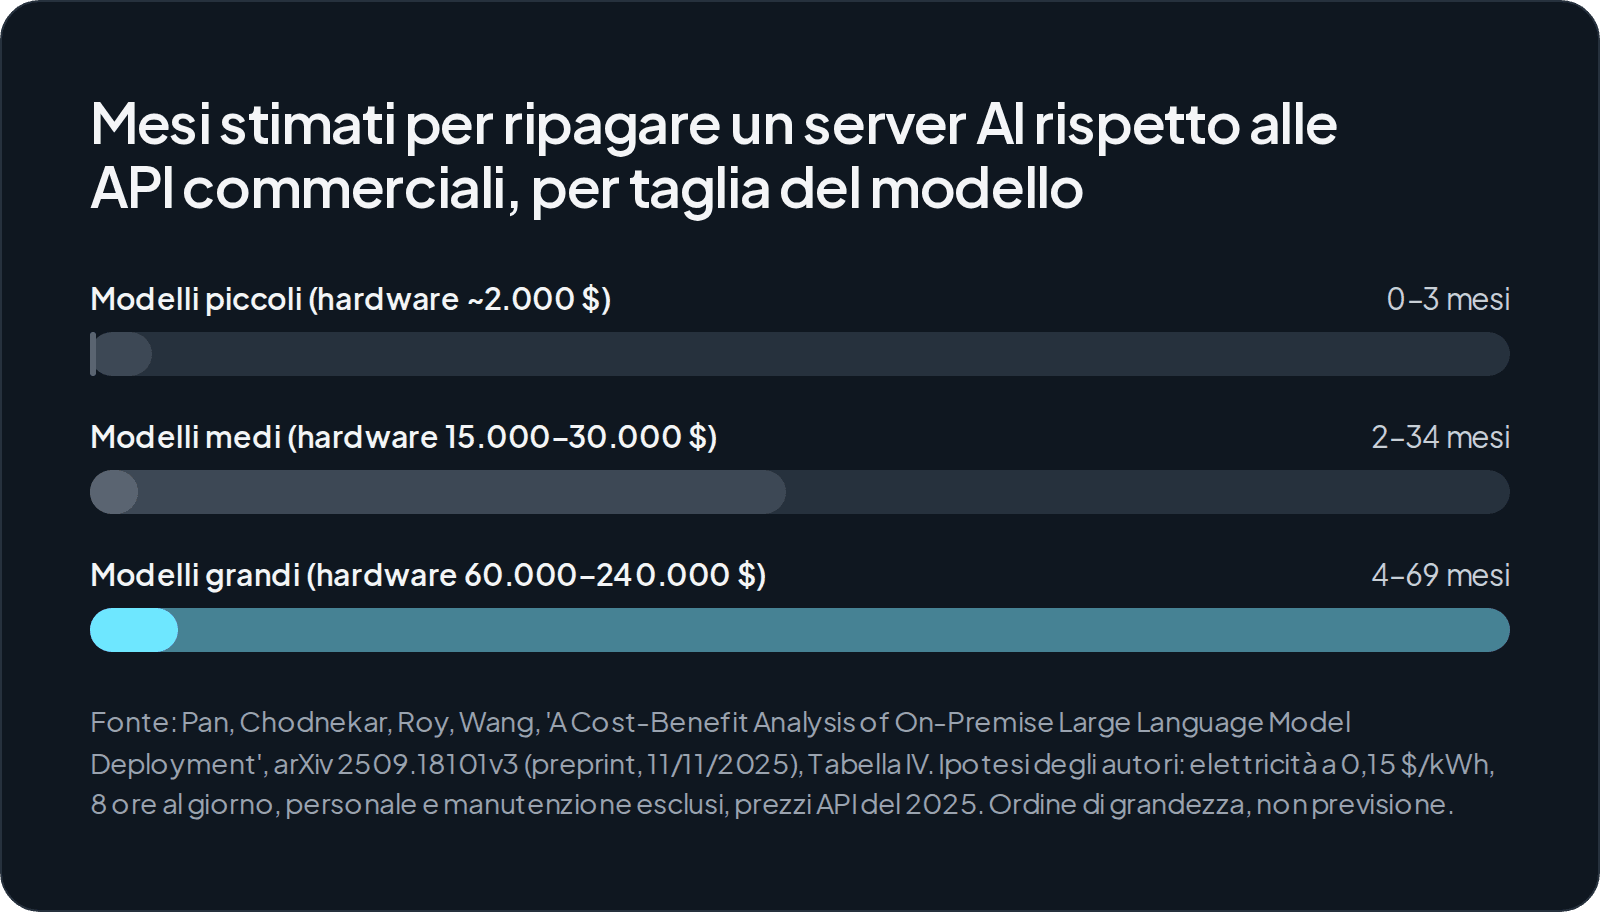
Secondo il preprint di Pan, Chodnekar, Roy e Wang, un server si ripaga in pochi mesi con i modelli piccoli e in quasi sei anni con quelli grandi, in un calcolo che esclude personale e manutenzione. La Tabella IV riporta:
- Modelli piccoli (hardware da 2.000 $, per esempio Qwen3-30B): da 0,3 a 3,0 mesi.
- Modelli medi (da 15.000 a 30.000 $, per esempio gpt-oss-120B e Llama-3.3-70B): da 2,3 a 34,0 mesi.
- Modelli grandi (da 60.000 a 240.000 $, per esempio Kimi-K2 e Qwen3-235B): da 4,3 a 69,3 mesi.
Lo studio ha dei limiti, tutti ricavabili dal testo:
- è un preprint (versione 3 dell'11 novembre 2025);
- ipotizza 0,15 $/kWh e 8 ore di uso al giorno;
- usa prezzi API del 2025, oggi superati;
- contiene incongruenze interne, per esempio sul rapporto tra input e output;
- la soglia di "≥50M tokens/month", indicata come favorevole al locale, non deriva dal suo modello di calcolo.
È utile come ordine di grandezza, ma non dice quanto ci mette a ripagarsi il server di una singola azienda.
Quali costi del server AI non compaiono nel prezzo dell'hardware?
Personale, assistenza, energia e aggiornamenti si aggiungono all'acquisto, e l'hardware stesso può rincarare. Secondo un annuncio sul forum NVIDIA, dal 23 febbraio 2026 la DGX Spark Founders Edition è passata da 3.999 a 4.699 $ per "worldwide constraints in memory supply". La fonte è semi-ufficiale, perché il ruolo dell'autore non è chiarito. La situazione aggiornata è nell'articolo sulla DGX Spark in azienda.
Per l'energia, Eurostat indica una media UE di 18,37 € per 100 kWh per le utenze non domestiche nel secondo semestre 2025, nella fascia da 500 a 2.000 MWh l'anno, IVA esclusa. Il dato più affidabile resta la propria bolletta. A queste voci si sommano installazione, monitoraggio, aggiornamenti di sicurezza del software di inferenza e prove dei nuovi modelli.
Cosa cambia per i dati aziendali tra un server proprio e le API?
Con le API i dati passano dai sistemi del fornitore e ci restano per il periodo previsto dalle sue condizioni. Con un server proprio i dati restano in azienda, che però si assume il compito di proteggerli e di aggiornare il software.
| Servizio | Uso per addestrare o migliorare i prodotti | Conservazione |
|---|---|---|
| API OpenAI | No, salvo consenso esplicito | Log anti-abuso fino a 30 giorni, salvo obblighi di legge |
| API Anthropic | Non trattato nella pagina sulla conservazione | Entro 30 giorni; fino a 2 anni in caso di violazioni |
| Gemini Flash a pagamento | No | Non indicata nella pagina prezzi |
| Server aziendale | Decide l'azienda | Decide l'azienda |
Secondo la guida di OpenAI, i log restano "up to 30 days" e la conservazione zero richiede "prior approval by OpenAI". La residenza dei dati in Europa richiede un emendamento al contratto e costa il 10% in più. Il Privacy Center di Anthropic indica che, in caso di violazione delle policy, i punteggi di classificazione restano fino a 7 anni. Su Gemini il livello gratuito prevede l'uso dei dati per migliorare i prodotti, quello a pagamento no (Google).
Gli incidenti capitano anche presso i grandi fornitori. Cloudflare ha documentato un problema sul modello GLM-5.3 di Workers AI, dal 27 agosto al 9 settembre 2026: "155 responses were affected", per un bug del software di inferenza SGLang, corretto dalla versione 0.5.22. Cloudflare scrive di non aver trovato prove di sfruttamento intenzionale. Con un server proprio l'infrastruttura non è condivisa con altri clienti, ma i bug restano possibili e seguire gli aggiornamenti tocca all'azienda. Gli obblighi che valgono in ogni caso sono nella pagina su AI e GDPR.
Quando le API restano la scelta migliore?
Le API convengono quando:
- i volumi sono bassi, stagionali o ancora da misurare;
- il compito richiede la qualità dei modelli di frontiera;
- mancano competenze interne o un partner di assistenza;
- bisogna partire subito;
- i lavori non sono urgenti e possono girare in Batch a metà prezzo.
Il rischio da mettere a bilancio è il ritiro dei modelli. Secondo la pagina delle deprecazioni di OpenAI, gpt-5 e o3 vengono spenti l'11 dicembre 2026, gpt-4o e gpt-4.1 il 14 gennaio 2027. Ogni ritiro comporta test, adattamenti e a volte un prezzo diverso. Il tema è trattato nell'articolo sul vendor lock-in nell'AI e nella pagina sulla migrazione dalle API.
Spesso la scelta più sensata è un sistema ibrido: il server per i dati sensibili e i carichi ripetitivi, le API per i casi difficili, con regole scritte su quali dati possono uscire e su chi può usare cosa.
Da dove partire per decidere tra server AI e API?
Si parte dai propri numeri, non da quelli di uno studio:
- Misurare per 30 giorni i token reali di ogni processo, separando input e output: nei listini citati l'output costa cinque volte l'input.
- Provare in pilota un modello open-weight. Due esempi recenti su Ollama: Recursive Flint (Apache 2.0, 40B parametri, circa 2,5B attivi) e Nemotron 3.5 Super (120B totali, 12B attivi). I benchmark delle note di rilascio sono dichiarati da chi pubblica il modello: vanno verificati sui propri documenti.
- Calcolare il costo su 3 anni con tre scenari di volume, includendo i rincari annunciati e i sovrapprezzi che si usano davvero.
- Decidere processo per processo, lasciando sulle API ciò che non giustifica un investimento.
Il metodo completo è nell'articolo su quanto costa un'AI privata in azienda. Se vuoi fare questi conti sui tuoi volumi, puoi richiedere una valutazione indipendente: ti aiuto a capire se il server ha senso o se per ora conviene restare sulle API.
Domande frequenti
Cosa succede ai modelli con fine-tuning sulle API OpenAI quando il modello base viene ritirato?
Secondo la pagina ufficiale sulle deprecazioni, i modelli personalizzati seguono il calendario del modello base: quando questo viene spento, anche il modello addestrato smette di essere disponibile. Inoltre dal 6 gennaio 2027 i clienti esistenti non possono creare nuovi job di fine-tuning. Su un server proprio i pesi del modello restano all'azienda.
Un server AI acquistato oggi diventa obsoleto in fretta?
L'hardware continua a funzionare anche quando escono modelli nuovi, ma può non bastare per quelli più grandi. Per questo conviene dimensionarlo sui casi d'uso misurati e ragionare su un orizzonte di circa tre anni, senza dare per scontato che regga qualunque modello futuro.
I punteggi dei benchmark dichiarati per i modelli open-weight bastano per scegliere?
No. I punteggi riportati nelle note di rilascio, come quelli di Recursive Flint su Ollama, li dichiara chi pubblica il modello e danno solo un'indicazione di massima. La scelta va fatta con un test sui propri documenti e processi, confrontando le risposte con quelle del modello cloud usato oggi.
Si può partire con un server piccolo e crescere dopo?
Sì, è un approccio ragionevole: si parte con un modello piccolo o medio su un processo circoscritto, si misura l'uso reale e poi si decide se ampliare. Il preprint su arXiv indica tempi di pareggio molto più brevi per i modelli piccoli, ma le sue ipotesi vanno verificate caso per caso.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
NVIDIA DGX Spark in azienda: quanto costa davvero, quali modelli regge e quando conviene rispetto alle API
La DGX Spark da 128 GB è salita a 6.950 $ e quella da 64 GB parte da 4.999 $. Vediamo quali modelli regge, cosa NVIDIA non dichiara, quanto costa rispetto ad API e abbonamenti e quando il cloud resta la scelta più sensata.
Costi e TCO10 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min