AI locale vs cloud: differenze, vantaggi, svantaggi e quale scegliere nel 2026
Locale o cloud? Le differenze reali per un'azienda: listini a token e per utente, rincari e ritiri programmati dei modelli, dove finiscono i dati, quanto sono maturi gli open-weight e in quali casi il cloud resta la scelta migliore.
Pubblicato il
La scelta tra AI locale vs cloud dipende da tre fattori: quante persone la usano e con quali volumi, quanto sono riservati i dati, quanto controllo serve sui tempi di aggiornamento del modello. Il cloud dà accesso immediato ai modelli di frontiera, ma i prezzi crescono con l'uso e con gli utenti, e il fornitore decide rincari e date di ritiro. Il locale, con modelli open-weight su hardware controllato dall'azienda, ha costi soprattutto fissi e tiene i dati nel perimetro, ma richiede competenze e manutenzione. Per molti team piccoli il cloud resta la scelta più sensata.
AI locale vs cloud: cosa cambia davvero tra le due opzioni?
Con il cloud il modello gira sui server del fornitore e si paga a token o per utente. In locale un modello open-weight gira su hardware controllato dall'azienda, cioè server interni o un'infrastruttura dedicata. Il costo è soprattutto fisso e i dati non escono dal perimetro, se l'installazione è configurata bene.
Le differenze si concentrano su quattro assi:
- chi decide quando cambia il modello: il fornitore oppure l'azienda;
- come si forma il costo: variabile con l'uso oppure fisso su più anni;
- dove passano i dati: infrastruttura esterna oppure interna;
- chi gestisce la manutenzione: il fornitore oppure l'azienda, direttamente o tramite chi la assiste.
| Aspetto | Cloud | Locale |
|---|---|---|
| Modello di costo | A token o per utente, cresce con l'uso e con le persone | Soprattutto fisso: hardware, installazione, assistenza, energia |
| Aggiornamenti e ritiri | Decisi dal fornitore, con un preavviso | Decisi dall'azienda |
| Residenza dei dati | Infrastruttura del fornitore, alle condizioni del contratto | Perimetro aziendale, se la configurazione è corretta |
| Competenze richieste | Integrazione, regole d'uso, gestione del contratto | Le stesse, più infrastruttura, test e sicurezza (interni o affidati a terzi) |
| Tempi di avvio | Brevi: un account e una chiave API | Più lunghi: progettazione, acquisto, installazione, pilota |
"Locale" non significa per forza un server nella sala macchine. Può essere anche un'infrastruttura dedicata in un data center scelto dall'azienda. Componenti e fasi sono descritti nella pagina su AI on-premise e nella guida completa all'AI on-premise: qui mi concentro sul confronto.
Questi quattro assi rispondono ai dubbi più diffusi tra le imprese europee. Secondo Eurostat (dati estratti a dicembre 2025), tra le imprese UE che avevano valutato l'AI senza adottarla il 70,89% indica la mancanza di competenze. Il 52,52% cita la poca chiarezza sulle conseguenze legali e il 48,83% i timori su protezione dei dati e privacy. Competenze, regole e dati sono proprio gli ambiti in cui locale e cloud si distinguono.
Quanto costa l'AI in cloud nel 2026, tra listini a token e abbonamenti per utente?
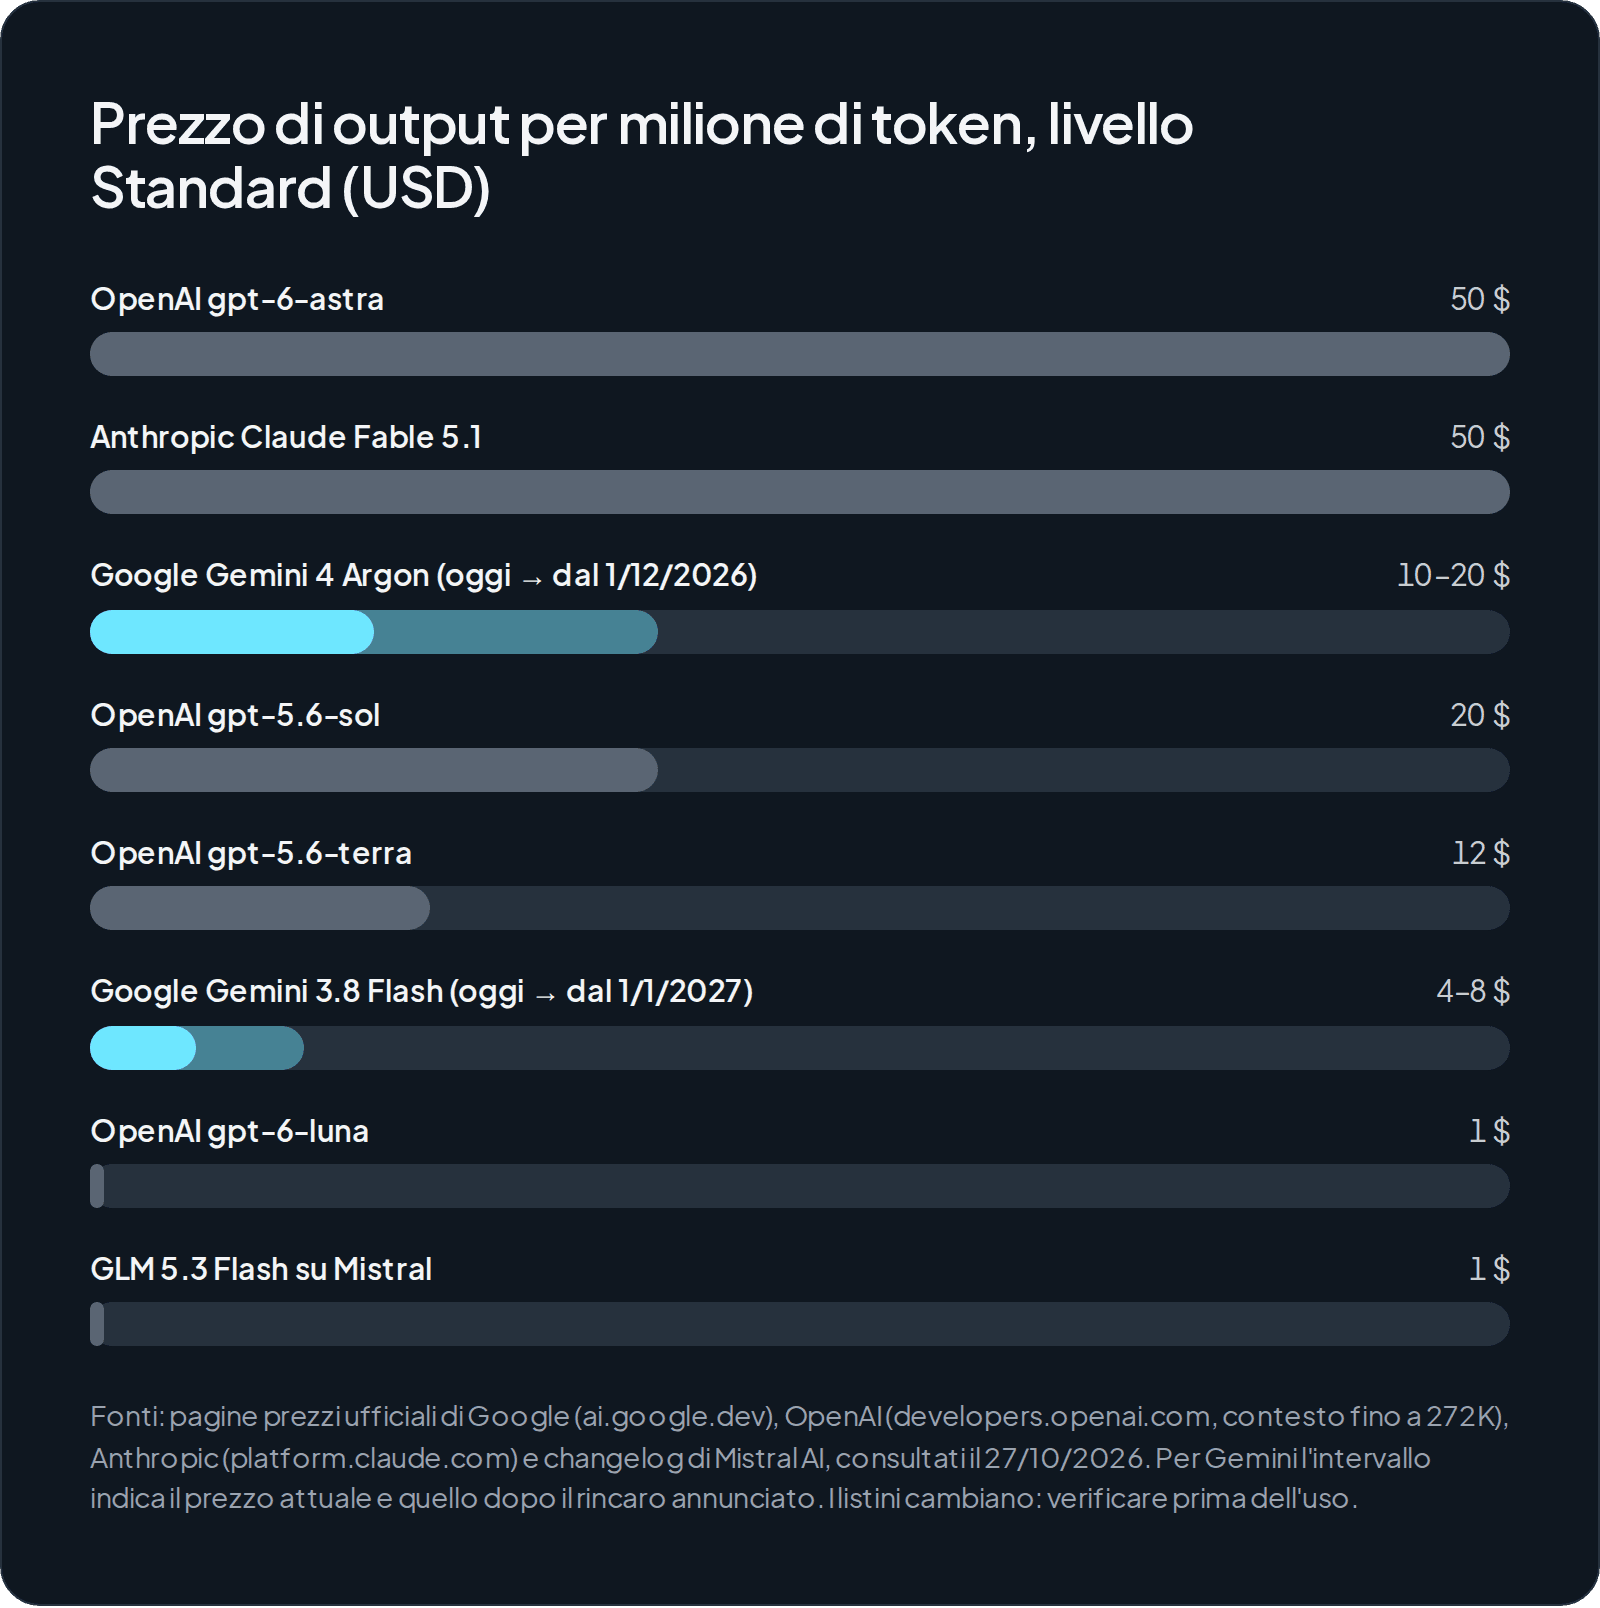
Dipende molto dal modello. Per l'output si va da 0,50 $ a 50 $ per milione di token (OpenAI, Anthropic), a cui si aggiungono gli abbonamenti per utente con limiti di utilizzo. Le cifre che seguono vengono dalle pagine prezzi ufficiali dei fornitori e, per GLM 5.3 Flash, dal changelog di Mistral, consultati il 27/10/2026. Sono in dollari e possono cambiare in qualsiasi momento.
| Modello | Input ($/M token) | Output ($/M token) | Fonte |
|---|---|---|---|
| gpt-6-astra | 10,00 | 50,00 | OpenAI |
| gpt-5.6-sol | 4,00 | 20,00 | OpenAI |
| gpt-5.6-terra | 2,00 | 12,00 | OpenAI |
| gpt-6-luna | 0,10 | 0,50 | OpenAI |
| Claude Fable 5.1 | 10,00 | 50,00 | Anthropic |
| Gemini 4 Argon | 2,00 → 4,00 dal 1/12/2026 | 10,00 → 20,00 dal 1/12/2026 | |
| Gemini 3.8 Flash e 3.6 Flash | 0,75 → 1,50 dal 1/1/2027 | 3,75 → 7,50 dal 1/1/2027 | |
| GLM 5.3 Flash (su Mistral) | 0,15 | 0,50 | Mistral |
I prezzi OpenAI della tabella valgono per il livello Standard con contesto fino a 272K token. Oltre questa soglia i prezzi salgono, e gli endpoint con elaborazione regionale costano il 10% in più per i modelli usciti dal 5 marzo 2026 (pagina prezzi OpenAI). Per Claude Fable 5.1 la lettura della cache costa 0,25 $ per milione di token (pagina prezzi Anthropic). Per batch, priorità e cache di Gemini rimando all'articolo sui prezzi delle API di Gemini.
Gli abbonamenti per utente seguono un'altra logica, perché crescono con il numero di persone. Per Claude il posto Team Standard costa 20 $ al mese con pagamento annuale o 25 $ con pagamento mensile. Il posto Premium costa 100 $ o 125 $, per team da 2 a 150 persone (prezzi Claude). Il piano Enterprise costa 20 $ per posto al mese con fatturazione annuale e un minimo di 20 posti, e l'uso si paga in più alle tariffe API (prezzi Claude). Ogni piano ha limiti che si azzerano su finestre mobili di cinque ore, e i piani a pagamento aggiungono limiti settimanali (prezzi Claude).
Cosa succede quando il fornitore cloud ritira o modifica un modello?
Il modello viene spento alla data stabilita dal fornitore e l'azienda deve migrare. La migrazione costa tempo di sviluppo e di test, e questa voce non compare in nessun listino. I calendari pubblicati dai fornitori mostrano quanto spesso accada.
OpenAI. Il 23/10/2026 ha spento, tra gli altri, gpt-4.1-nano, gpt-4o-2024-05-13, o4-mini, o1 e o3-mini (pagina deprecazioni OpenAI). L'11/12/2026 toccherà a gpt-5, gpt-5-mini, gpt-5-nano, gpt-5-pro, o3 e o3-pro. Il 14/1/2027 sarà la volta di gpt-4o, gpt-4o-mini, gpt-4.1 e gpt-4.1-mini, con gpt-6-luna come sostituto indicato (pagina deprecazioni OpenAI). I modelli personalizzati con fine-tuning seguono la data del modello di base. Dal 6/1/2027 nemmeno i clienti attivi potranno creare nuovi job di fine-tuning. Evals (in sola lettura dal 31/10/2026), l'API dei prompt e Agent Builder chiudono il 30/11/2026 (pagina deprecazioni OpenAI).
Anthropic. Dalla versione API 2026-10-21 i parametri temperature, top_p e top_k sono stati rimossi e restituiscono un errore 400 (deprecazioni Anthropic). È una modifica che può rompere un'integrazione anche senza che il modello cambi. claude-sonnet-4-5 viene ritirato il 30/11/2026, con claude-sonnet-5-5 come sostituto. Per i modelli pubblici il preavviso è di almeno 60 giorni. Su Amazon Bedrock e Google Cloud le date le stabilisce ciascun provider (deprecazioni Anthropic).
Google Vertex AI. Gemini 2.5 Pro, 2.5 Flash e 2.5 Flash-Lite sono stati ritirati il 20/10/2026 (ciclo di vita dei modelli Vertex AI). Gemini 3.6 Flash esce dal catalogo Vertex il 19/11/2026 e 3.7 Flash il 28/1/2027. La stessa pagina precisa che le date possono essere posticipate ma non anticipate. Intanto la pagina prezzi della Gemini API annuncia per 3.6 Flash un rincaro dal 1/1/2027. Si tratta di due piattaforme dello stesso fornitore con calendari distinti: vanno controllate entrambe.
In locale i pesi del modello restano all'azienda, che lo aggiorna quando decide di farlo. In cambio, test, sicurezza e aggiornamenti diventano responsabilità interna o di chi fornisce l'assistenza. Se state già affrontando un ritiro, la pagina sulla migrazione dalle API spiega come valutare il passaggio.
Dove finiscono i dati aziendali con l'AI in cloud e con quella in locale?
In cloud i dati passano per l'infrastruttura del fornitore, alle condizioni del piano e del contratto. In locale restano nel perimetro dell'azienda, a patto che l'installazione sia configurata bene. In nessuno dei due casi la conformità è automatica.
Il livello del piano conta. Per i modelli Flash di Gemini, Google indica che sul livello gratuito i dati sono usati per migliorare i prodotti, mentre su quello a pagamento no (pagina prezzi Gemini API). La residenza dei dati può avere un costo esplicito: su OpenAI l'elaborazione regionale costa il 10% in più per i modelli usciti dal 5 marzo 2026 (pagina prezzi OpenAI). Altre volte manca semplicemente l'informazione. Il changelog di Mistral, consultato il 27/10/2026, non dice dove vengono elaborati i dati dei modelli ospitati come GLM 5.3 Flash. In questi casi va chiesto al fornitore e scritto nel contratto.
Un incidente recente mostra dove nasce spesso il rischio. Secondo HRD America (20/10/2026), la società Claroc ha individuato oltre 6.800 link condivisi dell'app Meta Muse, rintracciabili con una sola query nei registri commerciali di ricerca dei domini. Tra le pagine aperte c'erano il calendario annuale delle ferie di decine di dipendenti e gli appunti di un candidato per una selezione dirigenziale riservata. Meta ha dichiarato a The Verge di aver sospeso la funzione mentre valuta il caso. È una fonte secondaria: la ricerca originale di Claroc non l'ho letta direttamente.
Da quanto riportato, il problema non era il modello ma una funzione di condivisione, unita all'uso dell'app per contenuti di lavoro. Per l'azienda il tema riguarda account, funzioni attive e abitudini delle persone, oltre alla scelta del fornitore. Gli obblighi che restano comunque sono descritti nella pagina su AI e GDPR.
Per chi vuole un metodo, il documento di Isabel Barbera per il Support Pool of Experts dell'EDPB (10/4/2025) propone una metodologia di gestione del rischio per gli LLM (EDPB, Support Pool of Experts). È il lavoro di un'esperta esterna, preparato su richiesta del Garante croato, e non rappresenta la posizione ufficiale dell'EDPB.
Quanto sono maturi oggi i modelli open-weight da far girare in locale?
L'offerta si muove in fretta, ma le prestazioni dichiarate vengono dai produttori e vanno verificate sui propri casi d'uso.
Solo le note di rilascio di Ollama di ottobre riportano diversi esempi:
- Nemotron 3.5 Super: 120B parametri, di cui 12B attivi, con contesto fino a 1M token (v0.40.5).
- Bolt: secondo le note è ottimizzato per stare in una GPU NVIDIA da 24 GB. Le indicazioni sulle sue dimensioni però non sono coerenti tra una versione e l'altra delle note, e questo va tenuto presente.
- Recursive Flint: 40B parametri in architettura MoE con circa 2,5B attivi, licenza Apache 2.0, contesto 262K. Prima era disponibile solo su macOS, dalla v0.40.9 anche su Linux e Windows.
Per Flint il produttore dichiara il 74,2% su SWE-bench Verified e il 54,9% su Terminal-Bench 2.1 (note di rilascio Ollama). Sono dichiarazioni del produttore, non misure indipendenti.
Non tutto ciò che viene annunciato è già utilizzabile. Mistral Large 4 è in anteprima pubblica, e il changelog di Mistral indica che i pesi aperti arriveranno più avanti: alla data di consultazione non risultano installabili in locale.
C'è poi un segnale interessante. Tra i sostituti di Gemini 2.5 Flash-Lite, Google indica anche Gemma 4, che è un modello open-weight (ciclo di vita dei modelli Vertex AI). È lo stesso fornitore a proporre un modello open-weight come alternativa.
Open-weight non significa adatto a ogni uso. Licenza, requisiti hardware e qualità delle risposte in italiano vanno verificati in un progetto pilota prima di qualsiasi investimento.
Quando il cloud conviene più dell'AI locale, e quando succede il contrario?
Il cloud conviene per i team piccoli, per gli usi saltuari o esplorativi e quando servono i modelli di frontiera più capaci. Il locale ha senso con volumi alti e stabili, documenti riservati, la necessità di decidere da soli i tempi di aggiornamento o di lavorare senza connessione.
I criteri da mettere sul tavolo:
- Numero di utenti e volumi di token, oggi e tra due o tre anni.
- Tipo di dati: informazioni pubbliche, interne, riservate, personali o soggette a segreto professionale.
- Dipendenza da un singolo fornitore: quanto vi costerebbe una migrazione imposta da un ritiro o da un rincaro.
- Competenze interne: chi gestisce aggiornamenti, test e sicurezza.
- Latenza e uso offline: stabilimenti, cantieri, reti isolate.
Spesso la risposta più sensata è ibrida. Dati riservati e cervello aziendale restano in locale, mentre i compiti generici vanno su un modello cloud con contratto business. Per impostare i conti partite da costi dell'AI in locale e dall'articolo su quanto costa un'AI privata.
Quali regole d'uso servono, che si scelga il locale o il cloud?
Accessi, registri, una policy scritta e formazione servono in entrambi i casi. Il locale riduce l'esposizione verso l'esterno, ma non sostituisce queste regole.
Il primo problema è spesso lo shadow AI, cioè gli strumenti usati senza approvazione. HRD America riporta due sondaggi. Secondo Kiteworks 2026, il 65% delle organizzazioni ha trovato dipendenti che usavano strumenti AI non approvati con dati sensibili. Secondo CalypsoAI 2025, il 52% dei dipendenti statunitensi userebbe l'AI anche contro la policy aziendale. Sono dati di sondaggi riportati da una testata, non misure sull'Italia. Indicano comunque che vietare non basta: serve offrire un'alternativa approvata.
Anche il quadro italiano delle autorità si è precisato. Il D.Lgs. 7 ottobre 2026, n. 179, in vigore dal 23/10/2026, indica AgID e ACN come autorità nazionali per l'AI. Ad ACN spetta la vigilanza, comprese le attività ispettive e sanzionatorie. Restano fermi competenze, compiti e poteri del Garante per la protezione dei dati personali.
Il Garante è già intervenuto sull'AI. Con il provvedimento n. 755 del 2 novembre 2024 aveva sanzionato OpenAI per quindici milioni di euro (comunicato del Garante). Il Tribunale di Roma, con la sentenza n. 4153/2026 pubblicata il 18/03/2026, ha poi accolto l'opposizione, quindi la sanzione non va considerata definitiva. Le motivazioni della sentenza non le ho verificate.
Permessi per ruolo, registri e gestione degli account personali sono trattati nell'articolo sul ChatGPT aziendale privato.
Da dove partire per scegliere tra AI locale e cloud?
Nel mio lavoro suggerisco di procedere per passi brevi, ciascuno con un risultato concreto:
- Inventario. Elencate modelli, API e abbonamenti già in uso, con le date di ritiro e i rincari annunciati. La prima scadenza può essere più vicina di quanto si pensi.
- Classificazione dei dati in tre livelli. Cosa può andare in cloud con un contratto business, cosa deve restare interno, cosa non va inserito in nessuno strumento.
- Stima su 3 anni. Confrontate cloud e locale con il numero reale di utenti e i volumi attesi, partendo dalla pagina sui costi dell'AI in locale.
- Un pilota su un solo caso d'uso, con un modello open-weight. Un buon candidato è l'assistente sui documenti interni, descritto nella pagina sul cervello aziendale.
- Regole prima del lancio: accessi, registri, policy e una formazione mirata per chi lo userà.
Se volete un parere esterno su quale strada abbia senso nel vostro caso, potete richiedere una valutazione indipendente. Non vendo hardware né licenze, e se il cloud è la scelta migliore ve lo dico.
Domande frequenti
Serve per forza un server dedicato per provare un modello in locale?
No, per un primo test no. Strumenti come Ollama fanno girare modelli open-weight su macOS, Linux e Windows. Secondo le note di rilascio, alcuni modelli sono ottimizzati per una singola GPU da 24 GB. Un uso aziendale con molti utenti, permessi e registri richiede invece un'infrastruttura progettata e qualcuno che la mantenga.
Il livello gratuito delle API si può usare per i test aziendali?
Con cautela. Per i modelli Flash di Gemini, Google indica che sul livello gratuito i dati sono usati per migliorare i prodotti, mentre su quello a pagamento no. Per i test conviene usare dati fittizi, oppure passare subito a un piano a pagamento con condizioni contrattuali chiare.
Un modello open-weight installato in locale si aggiorna da solo?
No. Resta la versione installata finché l'azienda non decide di cambiarla. È un vantaggio, perché nessun ritiro viene imposto dall'esterno. È anche un impegno: bisogna seguire le nuove versioni, verificarne la licenza e ripetere i test prima di ogni aggiornamento.
Scegliere un fornitore con elaborazione regionale in Europa risolve la questione dei dati?
Riduce alcuni rischi ma non li elimina. Restano da verificare la conservazione dei dati, gli eventuali sub-responsabili, la giurisdizione del fornitore e le funzioni di condivisione. Inoltre l'elaborazione regionale può costare di più: su OpenAI, per i modelli recenti, il sovrapprezzo è del 10%.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
AI on-premise: guida completa per installare l'intelligenza artificiale sui server aziendali
Cosa significa installare l'intelligenza artificiale sui server aziendali: differenze con il cloud, componenti dello stack, fasi del progetto, limiti reali e per chi ha senso.
AI in locale e on-premise9 min
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min