Isolamento dei dati nelle API AI: le informazioni della tua azienda possono finire nelle risposte di altri clienti?
Su Workers AI di Cloudflare, per due settimane, 155 risposte hanno restituito dati di altri clienti. Vediamo come si isolano i clienti su una GPU condivisa, cosa promettono i fornitori, cosa dice il GDPR e quanto costa ridurre la condivisione.
Pubblicato il
Sì, può succedere. Su Workers AI di Cloudflare, tra il 27 agosto e il 9 settembre 2026, 155 risposte del modello GLM-5.3 hanno contenuto dati di richieste di altri clienti, per un difetto nel software che gestisce la memoria delle GPU condivise (Cloudflare). L'isolamento dati API AI dipende quindi anche dal motore di servizio e da come è configurato, non solo dal modello. Prima di inviare dati riservati conviene chiedere al fornitore cosa è condiviso e come verresti avvisato, e valutare un endpoint dedicato o un modello in azienda quando volumi e sensibilità dei dati lo giustificano.
Cosa è successo su Workers AI, e perché riguarda chiunque usi API AI condivise?
Per circa due settimane un modello ospitato da Cloudflare ha restituito ad alcuni clienti dati che venivano dalle richieste di altri clienti. Il difetto non era nel modello ma nell'infrastruttura condivisa che lo serviva, come ricostruisce l'analisi pubblicata da Cloudflare il 26 ottobre 2026.
I fatti principali, secondo la stessa analisi:
- il modello coinvolto è
@cf/zai-org/glm-5.3; - il problema è durato dal lancio del 27 agosto 2026 fino al 9 settembre 2026;
- 155 risposte contenevano dati di altri clienti, tutte su prompt più lunghi di 681.280 token;
- Cloudflare lo definisce "a tenant isolation issue", cioè un difetto di isolamento tra clienti.
La segnalazione è arrivata l'8 settembre 2026 tramite HackerOne. L'ha inviata Gadi Evron di Knostic, con uno script per riprodurre il problema. Il 9 settembre l'incidente è stato dichiarato alle 13:22 UTC e alle 14:00 il modello è stato reso privato (Cloudflare).
Cloudflare scrive di non avere prove di sfruttamento deliberato e afferma: "We have confirmed that no other model hosted on Workers AI was affected" (fonte). Il post non dice invece quanti account siano coinvolti, se i clienti siano stati avvisati, né cosa succeda ai dati finiti nelle risposte sbagliate (Cloudflare). Non è un'accusa, ma sono proprio le informazioni che servono a un'azienda per decidere cosa fare.
Il caso non riguarda solo Cloudflare. Il motore coinvolto, SGLang, è un progetto pubblicato su GitHub che si può installare anche in proprio. Secondo il team di SGLang, le configurazioni predefinite erano esposte dalla linea v0.4.x fino alla v0.5.21. Con il backend MORI l'esposizione arriva fino alla v0.5.22.
Come funziona l'isolamento dati API AI tra clienti che condividono la stessa GPU?
Su un'API condivisa, richieste di clienti diversi usano le stesse pagine di memoria della GPU, che vengono riassegnate da una richiesta all'altra (Cloudflare). La separazione regge solo se il software di servizio assegna, libera e riusa quella memoria nel modo giusto.
Questa memoria si chiama KV cache: è il blocco di appunti in cui il motore tiene i calcoli intermedi sul testo già letto. In alcune architetture il lavoro è diviso in due. Un nodo di prefill legge il prompt, uno di decode genera la risposta, e la KV cache passa dal primo al secondo con backend come Mooncake, NIXL o MORI (LMSYS). In questa modalità si sono rotti due meccanismi.
La richiesta troppo lunga. Sui nodi di prefill la memoria KV era di 681.280 token, a fronte di un contesto dichiarato di 1.048.576. Una richiesta più lunga veniva rifiutata e sostituita da un segnaposto di un token. Il nodo di decode però "assumed that prefill overwrote the KV cache from previous requests", e le pagine non venivano azzerate: "Pages are not currently zeroed between requests" (Cloudflare).
Le scritture tardive. Quando una richiesta viene annullata, alcune scritture possono essere ancora in corso: "the late writes can overwrite another request's KVCache and corrupt its output" (LMSYS). I due difetti sono stati corretti nella stessa operazione coordinata.
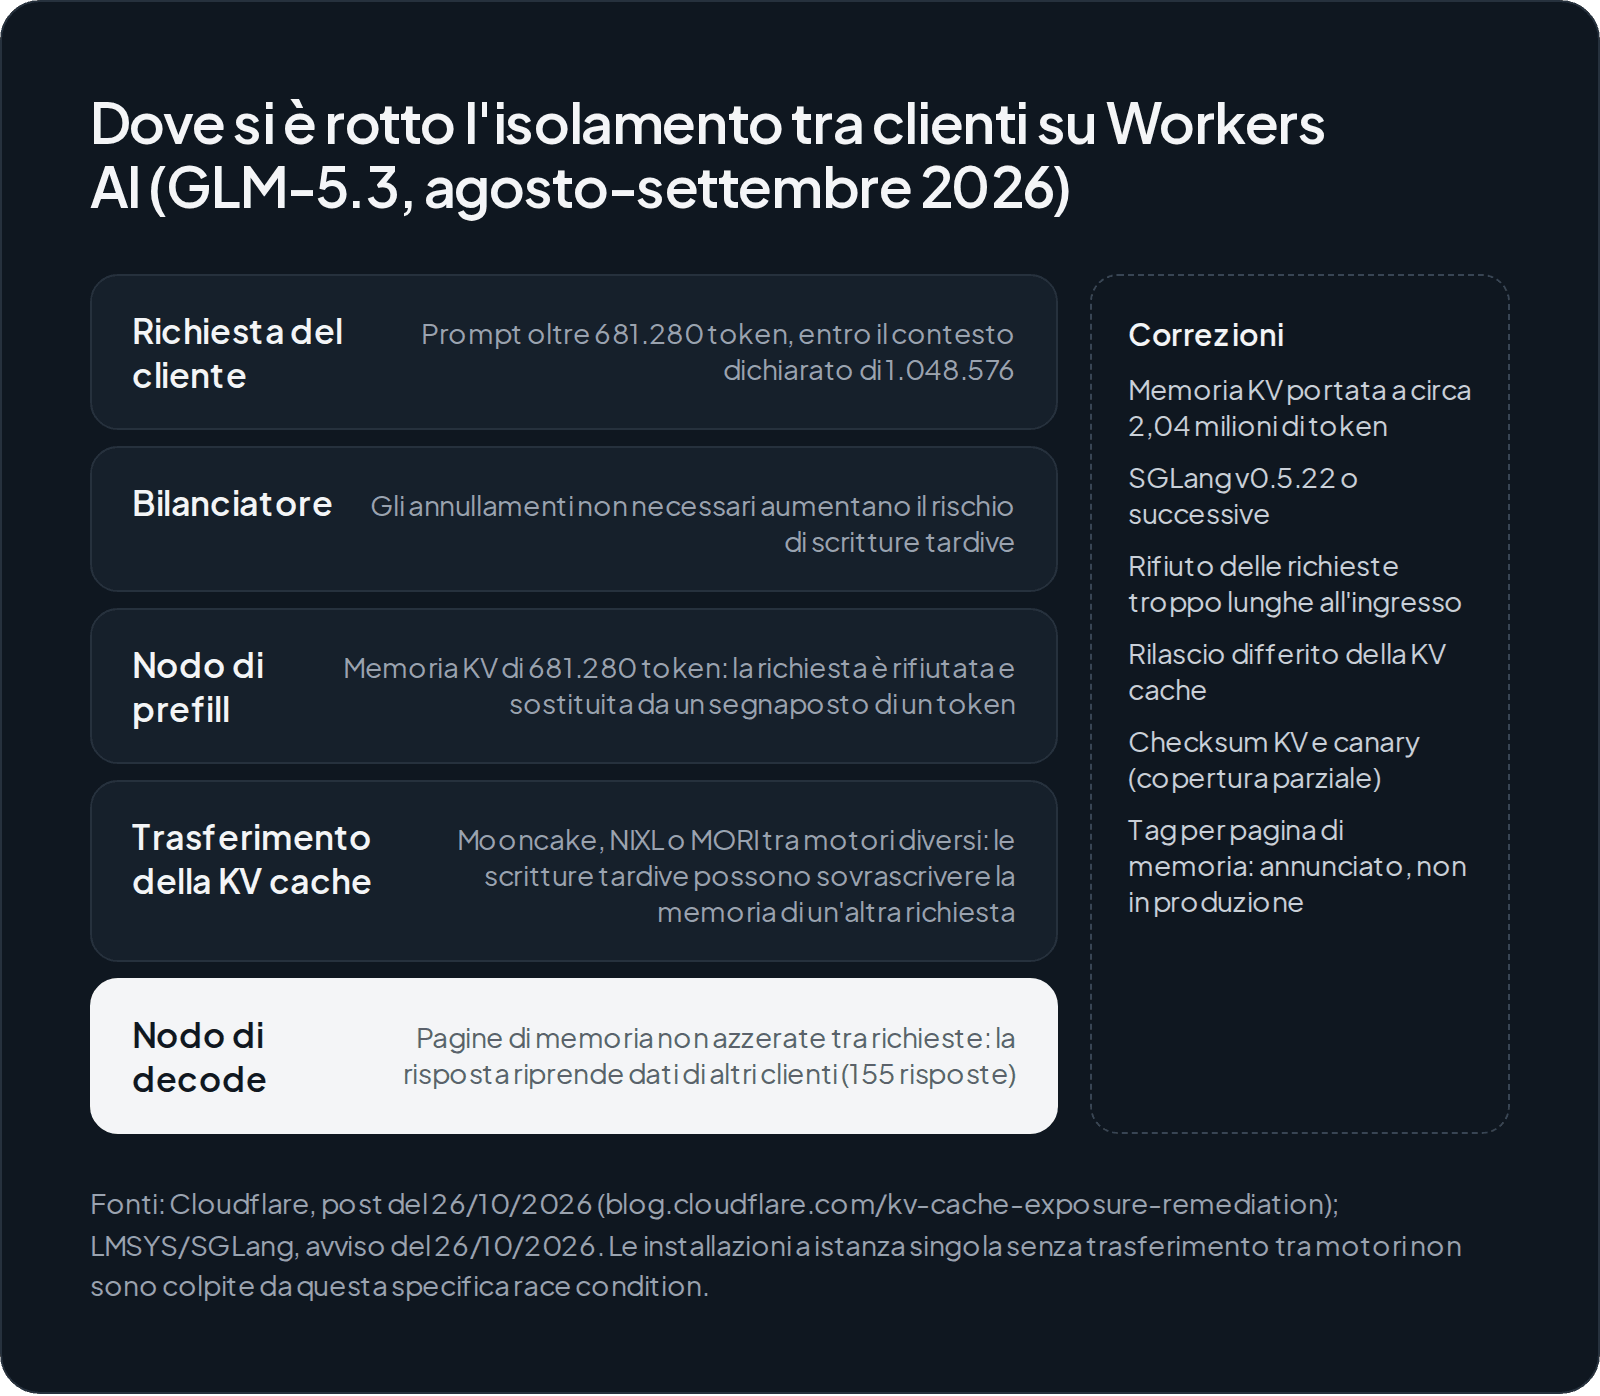
Cloudflare ha portato la memoria dei nodi di prefill a circa 2,04 milioni di token, circa il doppio del contesto, e ha applicato una patch al motore. Ha annunciato anche un'etichetta per ogni pagina di memoria, con un costo dichiarato inferiore all'1%, non ancora in produzione (Cloudflare).
Cosa promettono i fornitori sull'isolamento tra clienti, e cosa resta fuori dalle loro pagine?
Le pagine ufficiali dei fornitori considerati dichiarano che i tuoi contenuti non sono resi disponibili ad altri clienti, o che le cache sono separate per organizzazione. Descrivono come il servizio dovrebbe funzionare, ma non escludono che un bug rompa la separazione. Pagine consultate il 29/10/2026, possono cambiare.
| Fornitore | Altri clienti | Addestramento | Conservazione | Area di elaborazione | Cosa verificare |
|---|---|---|---|---|---|
| Cloudflare Workers AI | "does not make it available to other Cloudflare customers" | "does not use Customer Content processed by Workers AI to train AI models" | Input e output non conservati oltre il necessario, salvo funzioni con stato o logging di AI Gateway; restano metadati operativi | Non indicata | Area di elaborazione; ruolo di Z.ai, sviluppatore indicato nel nome del modello |
| Azure OpenAI / Microsoft Foundry | "are NOT available to other customers", né a OpenAI | Non indicato nei punti consultati; modelli dichiarati stateless | Campioni per il monitoraggio degli abusi, rivisti in automatico e, se serve, da persone | DataZone UE o Global (qualsiasi area) | Monitoraggio modificato e ContentLogging = false |
| Anthropic (prompt caching) | "Caches are isolated between organizations" | Non trattato nella pagina sul caching | Cache di 5 minuti di default, 1 ora a pagamento | Esiste un'opzione di inferenza solo negli USA | Su Bedrock e Google Cloud isolamento per organizzazione, non per workspace |
Anthropic isola le cache per workspace su Claude API, Claude Platform on AWS e Microsoft Foundry (Anthropic). Per lo Spazio economico europeo, Microsoft precisa che chi rivede i campioni sono dipendenti Microsoft nel SEE (Microsoft Learn). Per un'azienda il punto non è dare per scontato che un incidente non succeda mai. È sapere come verrebbe avvisata.
Se i tuoi dati finiscono nella risposta di un altro cliente, è un data breach da notificare?
Se tra quei dati ci sono dati personali, l'episodio può rientrare nella definizione di violazione del Garante Privacy: "una violazione di sicurezza che comporta – accidentalmente o in modo illecito – la distruzione, la perdita…" dei dati. La valutazione e l'eventuale notifica spettano al titolare. Il quadro generale è nella pagina su AI e GDPR.
I punti principali indicati dal Garante:
- il titolare notifica "senza ingiustificato ritardo e, ove possibile, entro 72 ore";
- il responsabile del trattamento "è tenuto a informare tempestivamente il titolare";
- se il rischio per le persone è elevato, vanno informati anche gli interessati;
- tutte le violazioni vanno documentate, anche quelle non notificate.
Il nodo pratico è la catena delle informazioni: il titolare può notificare solo ciò che sa. Il post di Cloudflare non dice se e quando i clienti coinvolti siano stati informati (Cloudflare). Per questo nel contratto contano tempi e contenuti della comunicazione del fornitore.
C'è anche il lato opposto: chi ha ricevuto dati altrui. La policy interna dovrebbe dire cosa fare se l'AI restituisce contenuti estranei: non usarli, segnalarli a un referente, conservare l'evidenza. Per le prime ore rimando a cosa fare quando i dati finiscono su un'AI non autorizzata. La valutazione va comunque fatta caso per caso, con il DPO o un legale.
Quanto costa ridurre la condivisione: API condivisa, endpoint dedicato o server in azienda?
L'API condivisa si paga a token. L'endpoint dedicato offre GPU riservate, ma si paga per tempo di hardware, qualunque sia il volume (documentazione Together). Il server interno ha costi di acquisto, gestione e manutenzione. Il confronto completo è nella pagina sui costi dell'AI in locale.
Listini consultati il 29/10/2026, soggetti a modifiche. Su Workers AI GLM-5.3 costa, per milione di token, 1,40 $ in input, 0,26 $ in input in cache e 4,40 $ in output (Cloudflare). Gli stessi prezzi valgono sull'API condivisa di Together AI. Gli endpoint dedicati di Together costano 5,49 $ l'ora per una H100 e 8,99 $ l'ora per una B200, descritti come "Single-tenant GPU instances" (Together AI). Cosa resta condiviso, come rete, bilanciatori e log, va chiesto al fornitore.
Per i modelli di frontiera, Anthropic indica 4 $ in input e 20 $ in output per milione di token per Opus 5.5, 2 $ e 10 $ per Sonnet 5.5. L'inferenza solo negli USA costa 1,1 volte il prezzo base. Il piano Team standard costa 20 $ per utente al mese con fatturazione annuale, con limiti d'uso su finestre di 5 ore e settimanali (Anthropic).
Con volumi bassi e dati non sensibili, l'API condivisa resta spesso la scelta più sensata. Il dedicato o il locale si giustificano con la natura dei dati e con i volumi, non con la paura di un incidente.
Con l'AI in locale il problema scompare, o cambia solo forma?
In locale non ci sono altri clienti sulla stessa GPU, quindi viene meno il rischio di una fuga verso un'altra azienda. Restano però gli stessi motori software, da aggiornare, e la condivisione tra utenti interni, da gestire con i permessi. Il quadro generale è nella pagina sull'AI on-premise.
Il difetto delle scritture tardive riguarda solo l'architettura che separa prefill e decode: "A single-instance deployment without this cross-engine transfer path is not affected by this specific race" (LMSYS). Per chi usa SGLang in modalità disaggregata le indicazioni sono queste (LMSYS):
- aggiornare almeno alla v0.5.22, rilasciata il 19 ottobre secondo le note di rilascio;
- per v0.5.19 e v0.5.20 impostare
SGLANG_DISAGGREGATION_DEFERRED_DECODE_KV_RELEASE=1; - controllare nel log di avvio la dimensione della memoria KV e ridurre il contesto se è più piccola;
- attivare
--disaggregation-enable-kv-checksume--kv-canary, che non coprono ancora tutte le architetture.
L'avviso di LMSYS non cita né un CVE né un advisory GHSA: chi gestisce il motore deve seguire gli avvisi del progetto, non solo i changelog. Lo stesso vale per vLLM. L'avviso GHSA-6cxc-2vcg-w5qc, di gravità bassa (CVSS 3.7), descrive una richiesta che poteva ereditare la lista di token consentiti di un'altra. Riguarda l'integrità delle risposte, non la riservatezza, e colpisce le versioni fino alla 0.30.0, corrette dalla 0.31.0.
Dentro l'azienda, poi, gli "altri clienti" sono i colleghi: cache, cronologie e knowledge base devono rispettare i permessi per reparto. Ne parlo nella pagina sul cervello aziendale e nell'articolo su come costruire un'AI sui documenti interni. Serve un processo di aggiornamento, e quel tempo è un costo da mettere a bilancio.
Cosa chiedere al fornitore di API AI prima di mandargli dati riservati?
Sei domande scritte, prima del contratto, aiutano a capire quanto è condivisa l'infrastruttura e come verresti avvisato. Fatti dare le risposte per iscritto, con il riferimento alla pagina ufficiale.
- Quali componenti sono condivisi tra clienti? GPU, memoria di lavoro, cache dei prompt, log.
- La cache dei prompt è isolata per organizzazione o per progetto? Anthropic distingue i due livelli a seconda della piattaforma (documentazione).
- In quale area si elaborano i dati? Microsoft distingue tra DataZone e Global; la pagina di Cloudflare non lo indica.
- Chi legge i campioni per il monitoraggio degli abusi, e si può ridurlo?
- Con quali tempi e contenuti il fornitore informa il titolare di un incidente? Ne dipende la notifica entro 72 ore indicata dal Garante.
- Esiste un'opzione dedicata, quanto costa e cosa resta comunque condiviso? (Together AI)
Conta anche se il fornitore pubblica analisi degli incidenti come quella di Cloudflare: la trasparenza dopo un problema è un criterio di scelta concreto. Le risposte servono a scrivere una policy che classifichi i dati e stabilisca cosa può andare su un'API condivisa, accompagnata dalla formazione di chi usa gli strumenti. Per i criteri GDPR c'è l'articolo su quando scegliere un modello on-premise, per le giurisdizioni extra UE quello sulla sovereign AI.
Da dove partire per valutare l'isolamento dei dati nei servizi AI che già usi?
Si parte da ciò che è già in uso. Il primo passo è anche il meno tecnico: sapere chi usa cosa, e con quali dati.
- Fai l'inventario di API e piani attivi, utenti e tipi di dati.
- Compila una scheda per fornitore con le risposte alle sei domande, i link alle pagine ufficiali e la data di consultazione.
- Separa i flussi. Dati poco sensibili su API condivisa; dati personali o riservati su opzioni dedicate o su un modello interno, se volumi e budget lo giustificano.
- Metti in calendario gli avvisi di sicurezza se gestisci un motore interno (LMSYS, vLLM).
- Tieni aggiornato il registro delle violazioni, come chiede il Garante, e valuta con il DPO se registrare anche le risposte con contenuti estranei.
Se vuoi un parere esterno su quali flussi tenere in cloud e quali portare su un'opzione dedicata o interna, puoi richiedere una valutazione. A volte la risposta è restare dove siete, con regole più chiare.
Domande frequenti
La crittografia della connessione protegge da una fuga come quella di Workers AI?
No. La crittografia protegge i dati mentre viaggiano verso il fornitore. Per essere elaborati dal modello, però, i dati vanno decifrati e caricati nella memoria della GPU, ed è lì che nel caso Cloudflare l'isolamento tra richieste non ha funzionato.
Un modello open-weight su API condivisa è più rischioso di un modello proprietario?
Il caso Cloudflare non dipendeva dai pesi del modello, ma dal motore che lo serviva e dalla sua configurazione. Qualunque servizio multi-tenant si regge sulla qualità del software di servizio. A cambiare il rischio è come e da chi viene gestita l'infrastruttura, non la licenza del modello.
Il prompt caching dei fornitori mette in comune i miei prompt con altre aziende?
Secondo la documentazione di Anthropic, le cache sono isolate tra organizzazioni e non vengono condivise nemmeno quando i prompt sono identici. Su alcune piattaforme l'isolamento arriva al singolo workspace. Per gli altri fornitori conviene chiedere per iscritto come funziona, perché le pagine non sempre lo spiegano.
Come faccio a sapere se i dati della mia azienda erano tra quelli esposti?
Dall'esterno non si può verificare. Il post di Cloudflare non dice quanti account siano coinvolti né se siano stati avvisati. L'unica strada è chiedere al fornitore tramite i canali contrattuali e conservare la sua risposta nel registro interno delle violazioni.
Un endpoint dedicato elimina ogni condivisione con altri clienti?
Rende dedicate le GPU, che i fornitori descrivono come istanze single-tenant. Altri componenti, come rete, bilanciatori, registri e strumenti di monitoraggio, possono restare condivisi. Bisogna chiedere al fornitore l'elenco preciso di cosa è dedicato e cosa no.
Chi scrive
Lilium AI
AI nei processi aziendali: in locale per i dati sensibili, con i modelli di frontiera per il resto
Da leggere dopo
Un dipendente ha caricato dati aziendali su un'AI non autorizzata: cosa fare subito
Un dipendente ha incollato dati aziendali in un chatbot non approvato: quali fatti raccogliere, cosa resta sui server del fornitore dopo la cancellazione, quando scatta la notifica al Garante e come evitare che si ripeta.
Privacy, GDPR e sovranità dei dati10 min
È sicuro utilizzare ChatGPT con i dati riservati della propria azienda?
Usare ChatGPT con dati riservati dipende dal piano, dal contratto e dalle regole interne. Una risposta onesta per chi guida un'azienda: account personali, piani business, GDPR e casi in cui conviene un'AI sui propri server.
Privacy, GDPR e sovranità dei dati8 min
Intelligenza artificiale e GDPR: quando scegliere un modello AI on-premise?
Il GDPR non vieta l'AI in cloud e non premia automaticamente quella in casa. Una guida agli obblighi reali (ruoli, DPIA, sicurezza, trasferimenti, AI Act) e ai criteri per capire quando l'on-premise riduce davvero il rischio.
Privacy, GDPR e sovranità dei dati10 min