Intelligenza artificiale offline: come utilizzare un LLM senza connessione Internet
Un LLM può funzionare senza connessione Internet, su server o PC aziendali. Spieghiamo cosa serve, come evitare che un'installazione "locale" contatti comunque servizi esterni, quanto costa rispetto alle API e quando conviene restare in cloud.
Pubblicato il
L'intelligenza artificiale offline è un modello linguistico (LLM) che gira su server o PC dell'azienda e risponde senza chiamare servizi esterni. Servono hardware adeguato, un runtime di inferenza, un modello open-weight scaricato in una fase controllata e impostazioni che spengano funzioni cloud e telemetria. Può convenire quando i dati non devono uscire dalla rete e l'uso è intenso. Per usi occasionali, o quando servono i modelli di frontiera più grandi, il cloud resta spesso la scelta più semplice.
Cosa significa intelligenza artificiale offline, e quanto deve essere "offline"?
Un LLM offline lavora su macchine controllate dall'azienda e, mentre risponde, non invia prompt né documenti all'esterno. Ci sono però gradi diversi di isolamento, e conviene scegliere quello che serve davvero.
| Livello | Cosa significa in pratica | Per chi può avere senso |
|---|---|---|
| AI locale | Il modello gira in casa, ma il software può collegarsi a Internet per aggiornamenti, telemetria o funzioni cloud | Prove iniziali, dati poco sensibili |
| Offline | Nessuna chiamata verso l'esterno durante il lavoro. La rete interna non ha uscite verso Internet | Molte aziende con dati riservati |
| Air gap | Nessun collegamento fisico con l'esterno. I dati passano solo a mano | Industria, difesa, ricerca e sviluppo |
Secondo il glossario del NIST, l'air gap è un'interfaccia tra sistemi non collegati fisicamente, in cui i dati si trasferiscono solo manualmente, sotto controllo umano. Per molte aziende il secondo livello è un punto di partenza ragionevole. Altri approfondimenti sono nella sezione AI offline e industria.
Cosa serve per far funzionare un LLM senza connessione Internet?
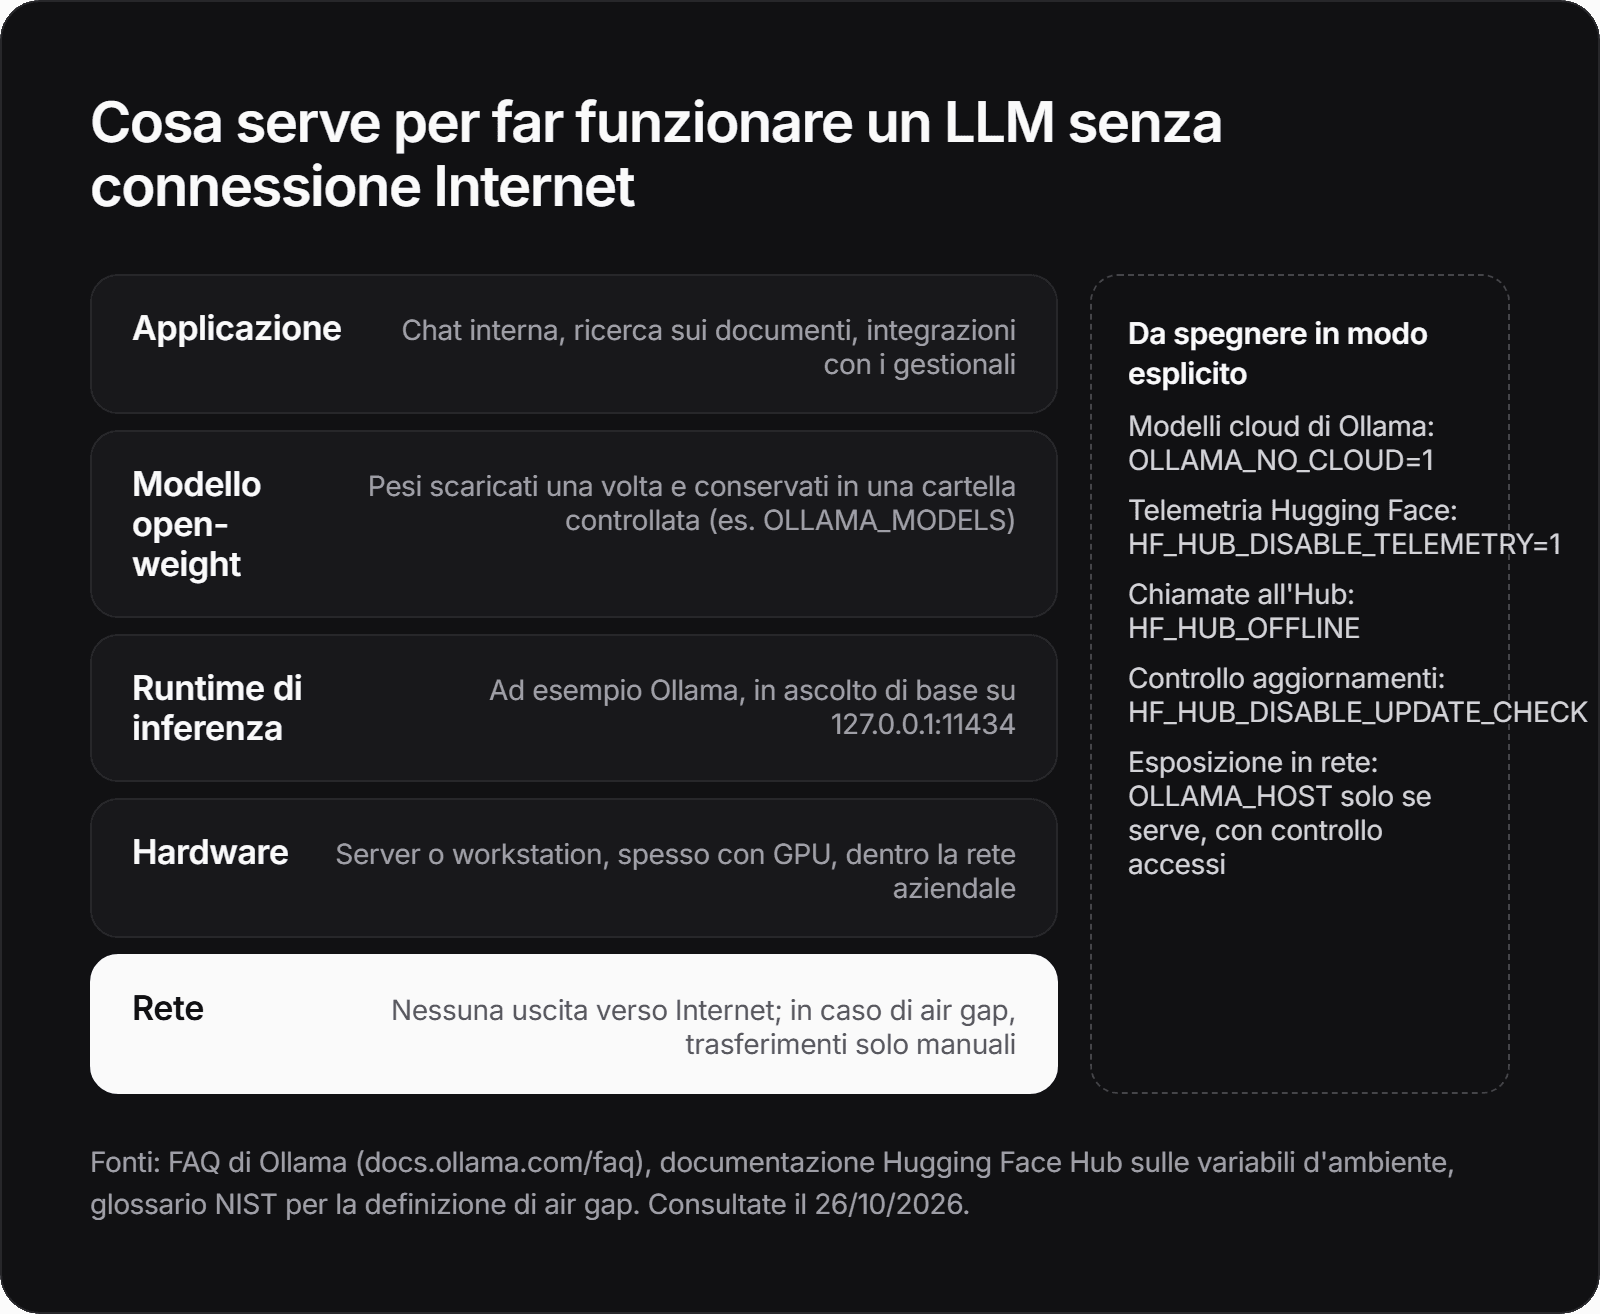
Servono hardware con memoria sufficiente (spesso una GPU), un runtime di inferenza, i pesi di un modello open-weight già presenti in locale e un'interfaccia di chat. La differenza sta nel separare la fase in cui i modelli vengono scaricati da quella in cui il sistema lavora.
- Ollama. La cartella dei modelli si sceglie con la variabile
OLLAMA_MODELS(FAQ di Ollama): sapere dove stanno i modelli permette di controllare cosa entra nella macchina. - Librerie Hugging Face. Con
HF_HUB_OFFLINEnon partono chiamate HTTP verso l'Hub e si usano solo i file in cache; se un file manca, il sistema dà errore invece di cercarlo in rete (documentazione di Hugging Face).
Non sono un sistemista: l'installazione la fa chi ha competenze infrastrutturali. Chi decide, però, deve sapere cosa chiedere: dove stanno i modelli, chi li ha scaricati, quali variabili sono impostate, quali porte sono aperte.
Per il quadro completo di componenti e fasi rimando alla guida all'AI on-premise e alla pagina sulla valutazione di un'AI on-premise.
Quali modelli open-weight si possono usare offline oggi?
L'offerta copre uso generale, programmazione, lettura di immagini e classificazione. Diversi modelli sono MoE (mixture of experts): molti parametri in totale, ma solo una parte attiva per ogni token. Tra il 14 e il 24 ottobre 2026 le note di rilascio di Ollama hanno aggiunto, tra gli altri:
| Modello | Versione Ollama | Caratteristiche dichiarate |
|---|---|---|
| Nemotron 3.5 Super | v0.40.5 (14/10/2026) | 120B MoE, 12B attivi, contesto da 1M token |
| Nemotron 3.5 Bolt | v0.40.5 (14/10/2026) | 74B, 9B attivi, indicato per GPU da 24 GB |
| Recursive Flint | v0.40.8 (21/10/2026) | Programmazione, 40B MoE con circa 2,5B attivi, Apache 2.0 |
| Famiglia d3 | v0.40.11 (24/10/2026) | Classificazione, da 2B a 27B |
Fonte: note di rilascio di Ollama, consultate il 26/10/2026. Per Flint le note riportano il 74,2% su SWE-bench Verified: è un risultato dichiarato, non una verifica indipendente. Il modello va scelto provandolo sui propri dati, e la licenza va letta modello per modello prima della produzione.
Come si evita che un'installazione "locale" parli comunque con l'esterno?
Bisogna disattivare in modo esplicito funzioni cloud, telemetria e controlli di aggiornamento: "installato sul PC" non vuol dire per forza "offline".
Le note di rilascio di Ollama elencano anche modelli cloud. La FAQ di Ollama spiega come bloccarli, insieme alla ricerca web: disable_ollama_cloud: true in ~/.ollama/server.json oppure OLLAMA_NO_CLOUD=1. Di base Ollama ascolta su 127.0.0.1, porta 11434; se lo si espone in rete con OLLAMA_HOST, servono controlli di accesso. Per le librerie Hugging Face, HF_HUB_DISABLE_TELEMETRY=1 spegne la raccolta di dati e HF_HUB_DISABLE_UPDATE_CHECK il controllo degli aggiornamenti (documentazione Hugging Face).
Una checklist da verificare con chi installa:
- Firewall in uscita che blocca Internet e registra i tentativi.
- Funzioni cloud spente e telemetria disattivata in tutte le librerie, non solo nel runtime.
- Proxy solo per il download dei modelli (
HTTPS_PROXY, secondo la FAQ), poi rimosso. - Esposizione in rete documentata: chi accede, da dove, con quali credenziali.
- Registri interni di utilizzo, conservati secondo le regole aziendali.
Perché un LLM offline riduce l'esposizione dei dati aziendali?
Se prompt e documenti non escono dalla rete, non finiscono nei registri, nei backup o nelle giurisdizioni di un fornitore esterno. Il rischio non sparisce: si sposta all'interno, dove va gestito con permessi, registri e regole d'uso.
Un caso recente: secondo Tech Times UK, fonte giornalistica secondaria, il servizio 302.ai, gestito da una società di Hong Kong, ha lasciato esposti 17,6 milioni di file, tra cui oltre 144.000 registri di chat e dati personali. L'esposizione, scoperta il 2 agosto 2026, risultava chiusa l'8 settembre; lo stesso articolo precisa che non ci sono prove di accessi malevoli. La lezione, senza allarmismo: i registri conservati da un servizio esterno sono dati che l'azienda non controlla, in questo caso fuori dall'UE.
Il timore è diffuso: secondo Eurostat, nel 2025 il 48,83% delle imprese UE che avevano considerato l'AI senza adottarla citava protezione dei dati e privacy. Un LLM offline, però, non rende conformi in automatico: titolarità, basi giuridiche e sicurezza restano. Ne parlo nella pagina su AI e GDPR.
Quanto costa un LLM offline rispetto ai modelli di frontiera a token?
Offline non si paga a token, ma ci sono costi fissi: hardware, installazione, manutenzione ed energia. Con volumi bassi le API possono costare meno.
Listini ufficiali consultati il 26/10/2026, soggetti a modifiche:
| Modello | Input ($/milione di token) | Output ($/milione di token) | Fonte |
|---|---|---|---|
| OpenAI gpt-5.5 | 5,00 | 30,00 | OpenAI |
| OpenAI gpt-5.4-mini | 0,75 | 4,50 | OpenAI |
| Anthropic Sonnet 5.5 | 2,00 | 10,00 | Anthropic |
Scegliere dove vengono elaborati i dati ha un costo esplicito: OpenAI applica un sovrapprezzo del 10% agli endpoint con elaborazione regionale per i modelli rilasciati dal 5 marzo 2026 (prezzi API OpenAI), Anthropic 1,1 volte la tariffa per l'inferenza solo negli Stati Uniti (prezzi di Claude). Il piano Enterprise di Claude costa 20 $ per posto al mese, fatturati annualmente, con almeno 20 posti, più l'uso a tariffa API (prezzi di Claude): il costo cresce con le persone, oltre che con l'uso.
Ai volumi dell'esempio, le API costano meno del progetto ipotizzato. L'offline può diventare interessante con volumi molto più alti, molti utenti o più processi sulla stessa infrastruttura, oppure quando certi dati non possono uscire. Il metodo completo è nella pagina sui costi dell'AI in locale e nell'articolo su quanto costa un'AI privata in azienda.
Quando l'intelligenza artificiale offline non conviene?
Non conviene quando servono le prestazioni dei modelli di frontiera più grandi, quando l'uso è basso o irregolare, o quando nessuno in azienda può seguire aggiornamenti e sicurezza. Lì un servizio cloud con contratto adeguato è spesso più semplice.
Esistono soluzioni intermedie: il 28 agosto 2025 Google ha annunciato Gemini su Google Distributed Cloud in versione air gap (Google Cloud). L'annuncio non riporta prezzi: condizioni e trattamento dei dati vanno chiariti nel contratto.
Lavorare offline non elimina nemmeno gli obblighi normativi. Il D.Lgs. 7 ottobre 2026, n. 179, in vigore dal 23 ottobre 2026, adegua la normativa italiana al regolamento (UE) 2024/1689 e indica AgID e ACN come autorità nazionali per l'AI. Il luogo in cui gira il modello non cambia il quadro delle autorità competenti.
Se l'obiettivo è un assistente in stile chat per i dipendenti, confronta le opzioni nella pagina sul ChatGPT aziendale privato.
Da dove partire con un LLM offline in azienda?
Conviene partire da un singolo processo, non da un'infrastruttura:
- Scegli un processo con dati sensibili e volume prevedibile: procedure, documentazione tecnica, codice.
- Decidi il livello di isolamento necessario: ogni livello in più aggiunge costi e procedure.
- Prova modelli open-weight su domande reali prima di parlare di hardware definitivo.
- Definisci accessi, registri e regole d'uso. Per interrogare gli archivi interni, guarda come funziona un cervello aziendale sui documenti.
- Confronta i costi con il cloud sullo stesso processo e sugli stessi volumi.
Se vuoi capire quale livello di isolamento serve alla tua azienda, e se ha senso economico, puoi chiedere una valutazione indipendente. Non vendo hardware né licenze: a volte la scelta più adatta è restare in cloud.
Domande frequenti
Come si aggiorna un modello AI su una rete senza Internet?
Si scarica il nuovo modello su una macchina collegata, lo si controlla e lo si trasferisce a mano nella cartella dei modelli. Con Ollama la cartella si sceglie con la variabile OLLAMA_MODELS. Nelle reti air gap questo passaggio va documentato, perché è l'unico punto di contatto con l'esterno.
Un LLM offline conosce le notizie e i dati più recenti?
No. Sa solo quello che ha imparato durante l'addestramento. Per farlo rispondere su informazioni aggiornate o sui documenti interni si usa di solito un sistema RAG, che recupera i testi da un archivio aziendale e li fornisce al modello insieme alla domanda.
Si può usare un'AI offline su un normale computer portatile?
I modelli più piccoli possono girare anche su computer di fascia alta. Per modelli più grandi e per più utenti contemporanei serve in genere una GPU con molta memoria o un server dedicato. La scelta va fatta dopo una prova sui compiti reali, non sulla scheda tecnica.
Le licenze open-weight permettono l'uso commerciale?
Dipende dal modello. Alcuni sono pubblicati con licenze permissive come Apache 2.0, altri hanno condizioni proprie con limiti d'uso. Prima di andare in produzione bisogna leggere la licenza di ogni modello scelto.
Un'AI offline serve ancora se l'azienda usa già un piano business cloud?
Può servire per singoli processi in cui contratti, segreto industriale o requisiti dei clienti escludono che i dati escano dall'azienda. Per tutto il resto, un piano business con contratto adeguato può essere la scelta più semplice ed economica.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
AI on-premise: guida completa per installare l'intelligenza artificiale sui server aziendali
Cosa significa installare l'intelligenza artificiale sui server aziendali: differenze con il cloud, componenti dello stack, fasi del progetto, limiti reali e per chi ha senso.
AI in locale e on-premise9 min
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
È sicuro utilizzare ChatGPT con i dati riservati della propria azienda?
Usare ChatGPT con dati riservati dipende dal piano, dal contratto e dalle regole interne. Una risposta onesta per chi guida un'azienda: account personali, piani business, GDPR e casi in cui conviene un'AI sui propri server.
Privacy, GDPR e sovranità dei dati8 min