AI on-premise: guida completa per installare l'intelligenza artificiale sui server aziendali
Cosa significa installare l'intelligenza artificiale sui server aziendali: differenze con il cloud, componenti dello stack, fasi del progetto, limiti reali e per chi ha senso.
Pubblicato il
L'AI on-premise è un'intelligenza artificiale, di solito un modello linguistico open-weight, installata ed eseguita sui server dell'azienda invece che sui sistemi di un fornitore cloud. Offre più controllo su dove passano i dati, sui costi ricorrenti e sui modelli usati, ma porta con sé hardware da acquistare, competenze tecniche e manutenzione continua. Ha senso quando ci sono dati riservati, volumi d'uso elevati o vincoli di connettività; negli altri casi un servizio cloud ben configurato resta spesso la scelta più semplice.
Cosa significa AI on-premise, e in cosa differisce dal cloud?
Significa che il modello di intelligenza artificiale gira su macchine che l'azienda possiede o controlla direttamente, nel proprio data center o in una sala server. Le richieste dei dipendenti e i documenti consultati restano dentro l'infrastruttura aziendale, invece di essere inviati alle API di un fornitore esterno.
Tra i due estremi esiste una terza via, il cloud privato dedicato: server riservati alla tua azienda, ma ospitati e gestiti da un provider. Nel mio lavoro vedo spesso confondere queste tre opzioni, quindi conviene metterle una accanto all'altra.
| Aspetto | Cloud pubblico / API | Cloud privato dedicato | On-premise |
|---|---|---|---|
| Dove gira il modello | Sui sistemi del fornitore, condivisi | Su risorse dedicate presso un provider | Sui server dell'azienda |
| Chi gestisce l'hardware | Il fornitore | Il provider | L'azienda o un partner incaricato |
| Scelta del modello | Quelli offerti dal fornitore | Ampia, spesso open-weight | Ampia, open-weight |
| Costo tipico | A consumo o per utente | Canone per le risorse riservate | Investimento iniziale + gestione |
| Tempo di avvio | Ore o giorni | Settimane | Settimane o mesi |
| Controllo sui dati | Regolato dal contratto | Contratto + isolamento delle risorse | Massimo, ma tutto a carico tuo |
Nessuna colonna è migliore in assoluto. Il cloud pubblico vince su rapidità e qualità dei modelli proprietari più avanzati; l'on-premise vince sul controllo; il cloud privato sta nel mezzo. Per una panoramica orientata alla decisione trovi anche la pagina dedicata all'AI on-premise.
Quali componenti servono per un'AI sui server aziendali?
Servono almeno sette elementi: un modello, un software che lo esegua, l'hardware, un sistema per collegarlo ai documenti, un'interfaccia, il controllo degli accessi e il monitoraggio. Vediamoli uno per uno, dal punto di vista di chi deve decidere.
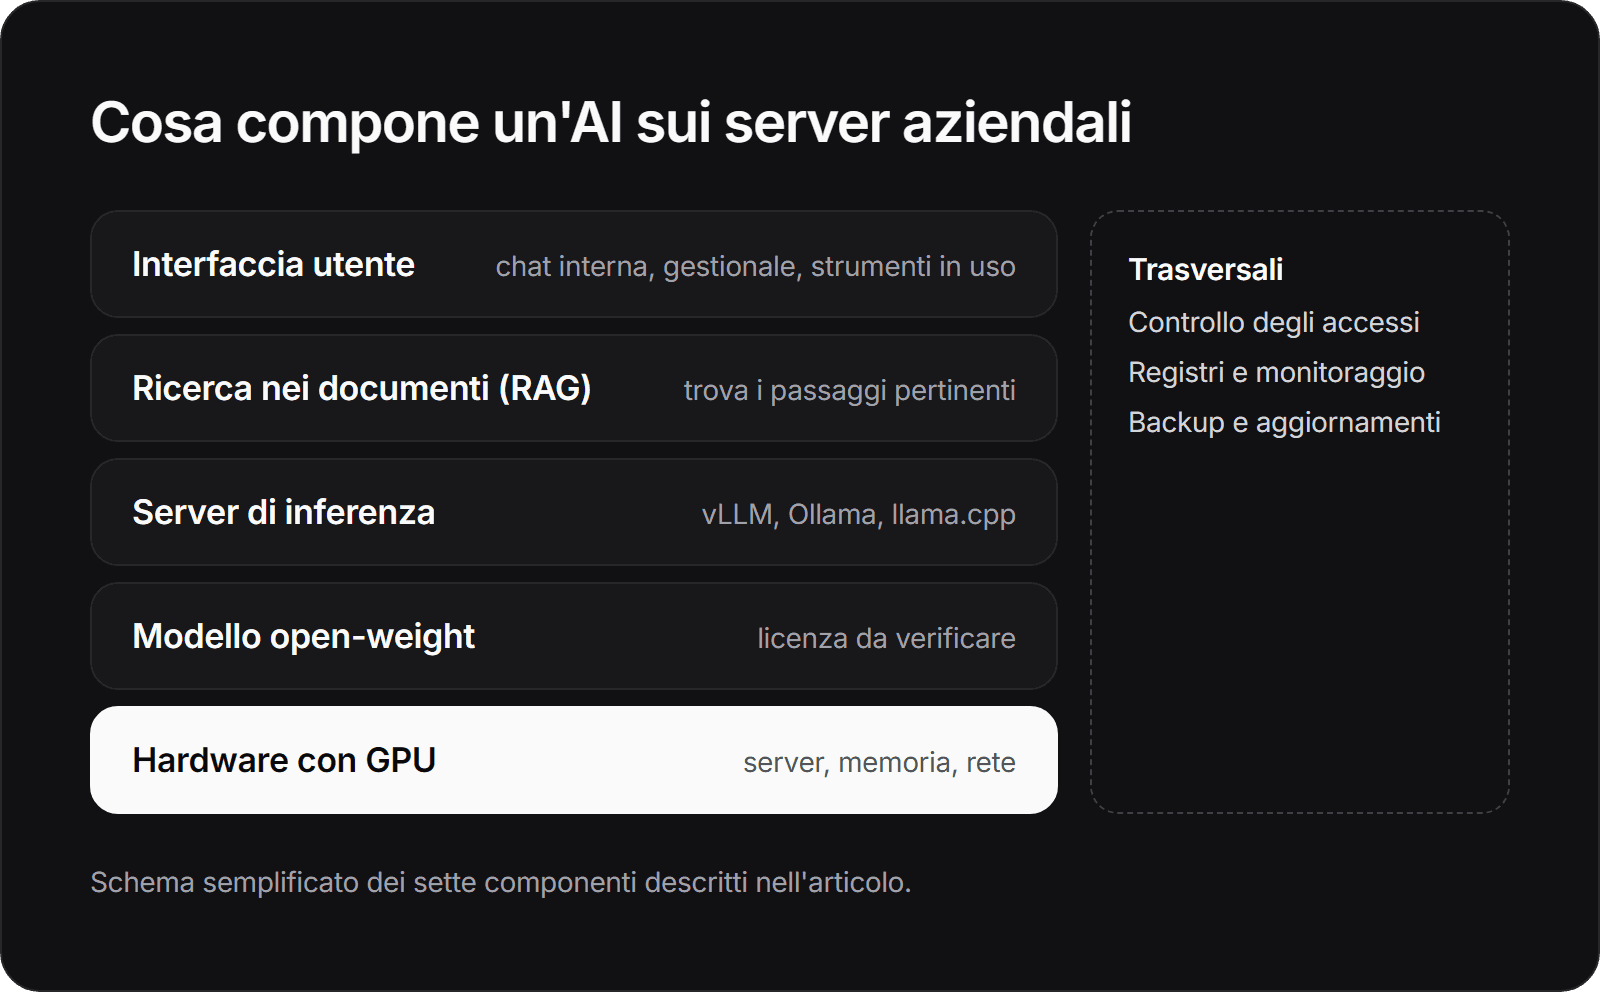
1. Il modello open-weight. È un modello di cui il produttore rende scaricabili i "pesi", cioè il file che contiene ciò che il modello ha imparato. Ogni modello ha una sua licenza, e le licenze non sono tutte uguali. Per esempio la model card di Mistral-7B-Instruct-v0.3 indica la licenza Apache 2.0, mentre i modelli Llama 3.1 usano una licenza propria di Meta che, tra le altre condizioni, richiede una licenza specifica alle organizzazioni con oltre 700 milioni di utenti attivi mensili, come si legge nella model card di Llama-3.1-8B-Instruct. La licenza va letta prima di scegliere, meglio con il supporto di un legale.
2. Il server di inferenza. È il software che carica il modello e risponde alle richieste. Tre nomi ricorrono spesso:
- vLLM offre un server HTTP compatibile con diverse API in stile OpenAI, tra cui quelle per completamenti e chat; è pensato per servire molti utenti.
- Ollama supporta un sottoinsieme delle API OpenAI ed è molto usato per prove e installazioni semplici.
- llama.cpp punta a eseguire i modelli con configurazione minima su un'ampia gamma di hardware e supporta la quantizzazione da 1,5 a 8 bit, una tecnica che riduce la memoria necessaria.
La compatibilità con le API in stile OpenAI conta per un motivo pratico: le applicazioni già scritte per un servizio cloud possono essere collegate al server interno con modifiche spesso contenute, da verificare caso per caso.
3. L'hardware con GPU. I modelli linguistici lavorano bene su schede grafiche con molta memoria dedicata (VRAM). Per dare un ordine di grandezza, una GPU da data center come la NVIDIA H100 SXM ha 80 GB di memoria. Quante GPU servono dipende da dimensione del modello, quantizzazione, numero di utenti contemporanei e lunghezza dei documenti: è un calcolo da fare con un partner tecnico, non a occhio.
4. Il livello di recupero dei documenti (RAG). Il modello da solo non conosce le tue procedure. Un sistema di retrieval-augmented generation cerca nei documenti aziendali i passaggi pertinenti e li fornisce al modello insieme alla domanda. Ne parlo più in dettaglio nella pagina sull'AI sui documenti aziendali.
5. L'interfaccia utente. Una chat web interna, un'integrazione nel gestionale o un assistente dentro gli strumenti già in uso.
6. Il controllo degli accessi. Chi può usare il sistema e, soprattutto, quali documenti può vedere ciascuno. Se il RAG pesca da cartelle a cui un utente non avrebbe accesso, il problema non è il modello ma la configurazione.
7. Logging e monitoraggio. Registri delle richieste, carico delle GPU, tempi di risposta, errori. Servono per la sicurezza, per capire l'uso reale e per dimensionare gli ampliamenti.
Come si svolge un progetto di AI on-premise, fase per fase?
Un progetto ordinato passa per otto fasi, e le prime due contano più dell'hardware. Saltarle è il modo più rapido per comprare server che poi restano sottoutilizzati.
- Valutazione dei casi d'uso. Quali attività, quanti utenti, che tipo di dati, quale beneficio atteso. È anche il momento di chiedersi se il cloud basterebbe.
- Scelta del modello con test su casi reali. Si provano due o tre modelli candidati su domande e documenti veri dell'azienda, non su esempi generici, e si confrontano le risposte con quelle di un servizio cloud di riferimento.
- Dimensionamento. Dai test e dal numero di utenti si ricava la configurazione hardware, con un margine per la crescita.
- Acquisto. Server, GPU, storage, eventuale potenziamento di rete, alimentazione e raffreddamento della sala server.
- Installazione. Sistema operativo, driver, server di inferenza, modello.
- Integrazione. Collegamento ai documenti, al sistema di autenticazione e ai software aziendali.
- Sicurezza. Accessi, segmentazione di rete, gestione dei registri, verifiche prima del rilascio.
- Esercizio. Aggiornamenti, monitoraggio, supporto agli utenti, valutazione periodica della qualità.
Il mio ruolo da consulente si concentra sulle fasi 1 e 2 e sul coordinamento delle successive. Installazione, sicurezza e gestione dell'infrastruttura vanno affidate a partner tecnici specializzati: è una scelta di prudenza, non un dettaglio. Per capire come si compongono le voci di spesa di queste fasi puoi leggere l'articolo su quanto costa un'AI privata aziendale.
Cosa non risolve automaticamente l'AI on-premise?
Non rende automaticamente conformi al GDPR, non eguaglia necessariamente i migliori modelli proprietari e non elimina il lavoro di gestione. Sono i tre equivoci che incontro più spesso.
La conformità GDPR resta da costruire. Tenere i dati in casa riduce alcuni passaggi verso terzi, ma gli obblighi restano: base giuridica, informative, misure di sicurezza, tempi di conservazione. Se il trattamento può presentare un rischio elevato per i diritti e le libertà delle persone, l'articolo 35 del GDPR richiede una valutazione d'impatto, come spiega il Garante Privacy nella pagina sulla DPIA. A questo si aggiunge l'AI Act, che classifica i sistemi in base al livello di rischio e prevede obblighi di alfabetizzazione sull'AI applicabili dal 2 febbraio 2025, secondo il quadro riassunto dalla Commissione europea. Il tema è approfondito nella pagina su AI aziendale e GDPR; per i casi specifici serve il parere del DPO o di un legale.
La qualità può essere inferiore. I modelli open-weight che si possono eseguire su un hardware ragionevole non sempre raggiungono i risultati dei migliori modelli proprietari in cloud, soprattutto su compiti complessi. Per molti usi aziendali bastano; per altri no. Lo si scopre solo con i test della fase 2.
La manutenzione è tua. Aggiornamenti di sicurezza, nuove versioni dei modelli, guasti hardware, utenti che chiedono nuove funzioni: qualcuno deve occuparsene, con un contratto di assistenza o con personale interno. È un costo ricorrente da mettere in conto fin dall'inizio, come spiego nella pagina sul costo dell'AI locale.
Per chi ha senso l'AI on-premise, e per chi no?
Ha senso per organizzazioni con dati che non vogliono o non possono inviare all'esterno, con un uso intenso e continuativo, o con ambienti dove la connessione non è garantita. Non ha senso, nella maggior parte dei casi, per chi è ancora all'inizio e spende poco in strumenti AI.
È un candidato ragionevole se:
- trattate documenti riservati (contratti, dati sanitari, progetti, informazioni finanziarie) e le policy interne o dei clienti limitano l'uso di servizi esterni;
- avete già casi d'uso chiari e un volume d'uso che rende pesanti i costi a consumo o per utente;
- avete reparti produttivi o sedi dove serve funzionare anche senza Internet;
- disponete di un reparto IT o di un partner tecnico in grado di gestire l'infrastruttura.
Probabilmente non fa per voi se:
- non avete ancora individuato casi d'uso concreti;
- la spesa attuale per strumenti AI è bassa e i dati trattati non sono particolarmente sensibili;
- vi servono le prestazioni dei modelli proprietari più avanzati su compiti complessi;
- non c'è nessuno che possa seguire l'infrastruttura nel tempo.
In questi casi un servizio cloud con un contratto adeguato è spesso la scelta più sensata. Se il vostro obiettivo principale è dare ai dipendenti un assistente in stile chat senza esporre i dati, può esservi utile anche la guida al ChatGPT aziendale privato sui propri server.
Da dove partire
Prima di parlare di GPU, conviene mettere in fila poche informazioni:
- Elencate tre o quattro attività in cui l'AI potrebbe aiutare, con il reparto coinvolto e il numero di persone.
- Classificate i dati che quelle attività toccano: pubblici, interni, riservati, personali, particolari.
- Raccogliete alcune decine di domande reali e i documenti di riferimento: serviranno per testare i modelli.
- Annotate la spesa attuale per strumenti AI e come cresce.
- Coinvolgete fin da subito IT, DPO e un partner tecnico, per capire vincoli di infrastruttura e di conformità.
Con questo materiale la valutazione diventa concreta e si può capire se l'on-premise è la strada giusta, se lo è un cloud privato o se basta un servizio esistente configurato bene. Se vuoi un confronto su questi punti, puoi richiedere una valutazione iniziale.
Domande frequenti
Un'AI on-premise può funzionare senza connessione a Internet?
In linea di principio sì: modello, server di inferenza e documenti risiedono nella rete aziendale, quindi l'uso quotidiano può avvenire anche in un ambiente isolato. Servono però procedure per portare dentro aggiornamenti del software, patch di sicurezza e nuove versioni dei modelli, da concordare con il partner tecnico.
Posso iniziare con un PC con una buona scheda grafica invece che con un server?
Per un prototipo o una prova su pochi casi può bastare una workstation, e strumenti come Ollama o llama.cpp nascono anche per l'uso locale. Per un servizio usato da molti colleghi in contemporanea, con requisiti di continuità e sicurezza, il dimensionamento va invece fatto su carichi reali insieme a chi gestisce l'infrastruttura.
L'AI on-premise sostituisce gli strumenti AI in cloud che già usiamo?
Non necessariamente. Molte aziende possono tenere in cloud gli usi generici e portare in casa solo i flussi con dati riservati o volumi elevati. Un approccio misto va valutato caso per caso su costi, rischi e qualità delle risposte.
Chi è responsabile se il modello installato in azienda sbaglia una risposta?
Il modello non si assume responsabilità: l'organizzazione resta responsabile di come usa le risposte. Per questo conviene definire quali attività richiedono una verifica umana, formare gli utenti e conservare i registri d'uso previsti dalle policy interne.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Intelligenza artificiale e GDPR: quando scegliere un modello AI on-premise?
Il GDPR non vieta l'AI in cloud e non premia automaticamente quella in casa. Una guida agli obblighi reali (ruoli, DPIA, sicurezza, trasferimenti, AI Act) e ai criteri per capire quando l'on-premise riduce davvero il rischio.
Privacy, GDPR e sovranità dei dati10 min
ChatGPT aziendale privato: come avere un assistente AI sui propri server
ChatGPT è un servizio cloud di OpenAI: per un assistente sui server aziendali servono modelli open-weight e un'interfaccia di chat. Confronto onesto tra piani business, soluzione interna e approccio ibrido.
AI in locale e on-premise10 min