Il caso Revolut: un modello open-weight su GPU dedicate come default e i modelli di frontiera solo per le eccezioni
Revolut ha spostato il coding assistito di 2.000 ingegneri su GLM, un modello open-weight su GPU dedicate a 0,30 $ per milione di token, e usa i modelli di frontiera solo per le eccezioni. Cosa è confermato, dove passavano i dati e cosa ne può trarre un'azienda italiana.
 Giulio PessioneAI in locale e on-premise10 min
Pubblicato il
Revolut ha spostato il coding assistito di circa 2.000 ingegneri su GLM, un modello open-weight di Z.ai che fa girare su GPU dedicate presso un servizio basato negli Stati Uniti. I modelli di frontiera restano per le eccezioni, come le richieste con immagini. Secondo il responsabile delle AI operations, il costo medio è di 0,30 $ per milione di token e la fattura è un decimo di quella pagata prima ad Anthropic e OpenAI (talk all'AI Engineer NYC). Il caso Revolut, così come lo racconta l'azienda, mostra che un modello open-weight come scelta predefinita può reggere un uso intenso, ma non dimostra che lo stesso risparmio si ottenga a qualsiasi scala.
Cosa ha fatto Revolut, e perché un modello open-weight è diventato la scelta predefinita?
Revolut ha tolto a Claude e GPT il ruolo di modello principale per il coding: ora usa GLM su GPU dedicate e manda ai modelli di frontiera solo i casi che GLM non copre. Lo ha raccontato David Abitbol, responsabile delle AI operations, nel talk del 13 ottobre 2026 all'AI Engineer NYC, ripreso da The Register il 3 novembre.
Il percorso è partito dalle API dei grandi fornitori, con limiti di budget rigidi e token limitati per gli ingegneri. Secondo Abitbol, Gemini aveva portato un miglioramento del 10% sul lead time e del 20% sul tempo di sviluppo, mentre alcuni ingegneri spendevano 1.000 o 10.000 al mese con un ritorno scarso (la valuta non è specificata).
Il self-hosting è iniziato intorno ad aprile 2026 (la trascrizione dice "around April 26", espressione ambigua), prima con GLM-5.1 e poi con GLM-5.3, come conferma anche The Register. Con GLM-5.1 Revolut riporta un miglioramento del 60% sul tempo di sviluppo e del 70% sul lead time.
Su questi numeri serve cautela: il talk non isola l'effetto del modello da quello degli altri cambiamenti. Secondo The Register, Abitbol ha detto "When you have unlimited tokens, you're free to do that", frase che non compare nella trascrizione di ai.engineer. Un'ipotesi plausibile, non dimostrata, è che la fine del razionamento dei token abbia pesato quanto la qualità del modello.
Quanto costa il modello open-weight di Revolut rispetto ai listini di Anthropic, OpenAI e Z.ai?
Secondo Abitbol, il costo medio è di 0,30 $ per milione di token, con una fattura pari a un decimo di quella di Anthropic e OpenAI; The Register precisa che vale per input e output. Il dimensionamento dichiarato è di circa 56 GPU B200 per 2.000 ingegneri, cioè, secondo The Register, sette sistemi DGX B200 da 8 GPU.
Per confronto, i listini a milione di token consultati il 4 novembre 2026. I prezzi cambiano spesso: prima di decidere va ricontrollata la pagina ufficiale.
| Modello | Input | Input in cache | Output | Fonte |
|---|---|---|---|---|
| GLM-5.3 (API Z.ai) | 1,4 $ | 0,26 $ | 4,4 $ | Z.ai |
| GLM-5.3-Flash (API Z.ai) | 0,15 $ | 0,03 $ | 0,50 $ | Z.ai |
| Claude Sonnet 5.5 | 2 $ | — | 10 $ | Anthropic |
| Claude Opus 5.5 | 4 $ | — | 20 $ | Anthropic |
| GPT-6.1 Terra | 1 $ | 0,05 $ | 5 $ | OpenAI |
| GPT-5.3-Codex | 1,75 $ | 0,175 $ | 14 $ | OpenAI |
| GPT-6 Astra | 10 $ | 1 $ | 50 $ | OpenAI |
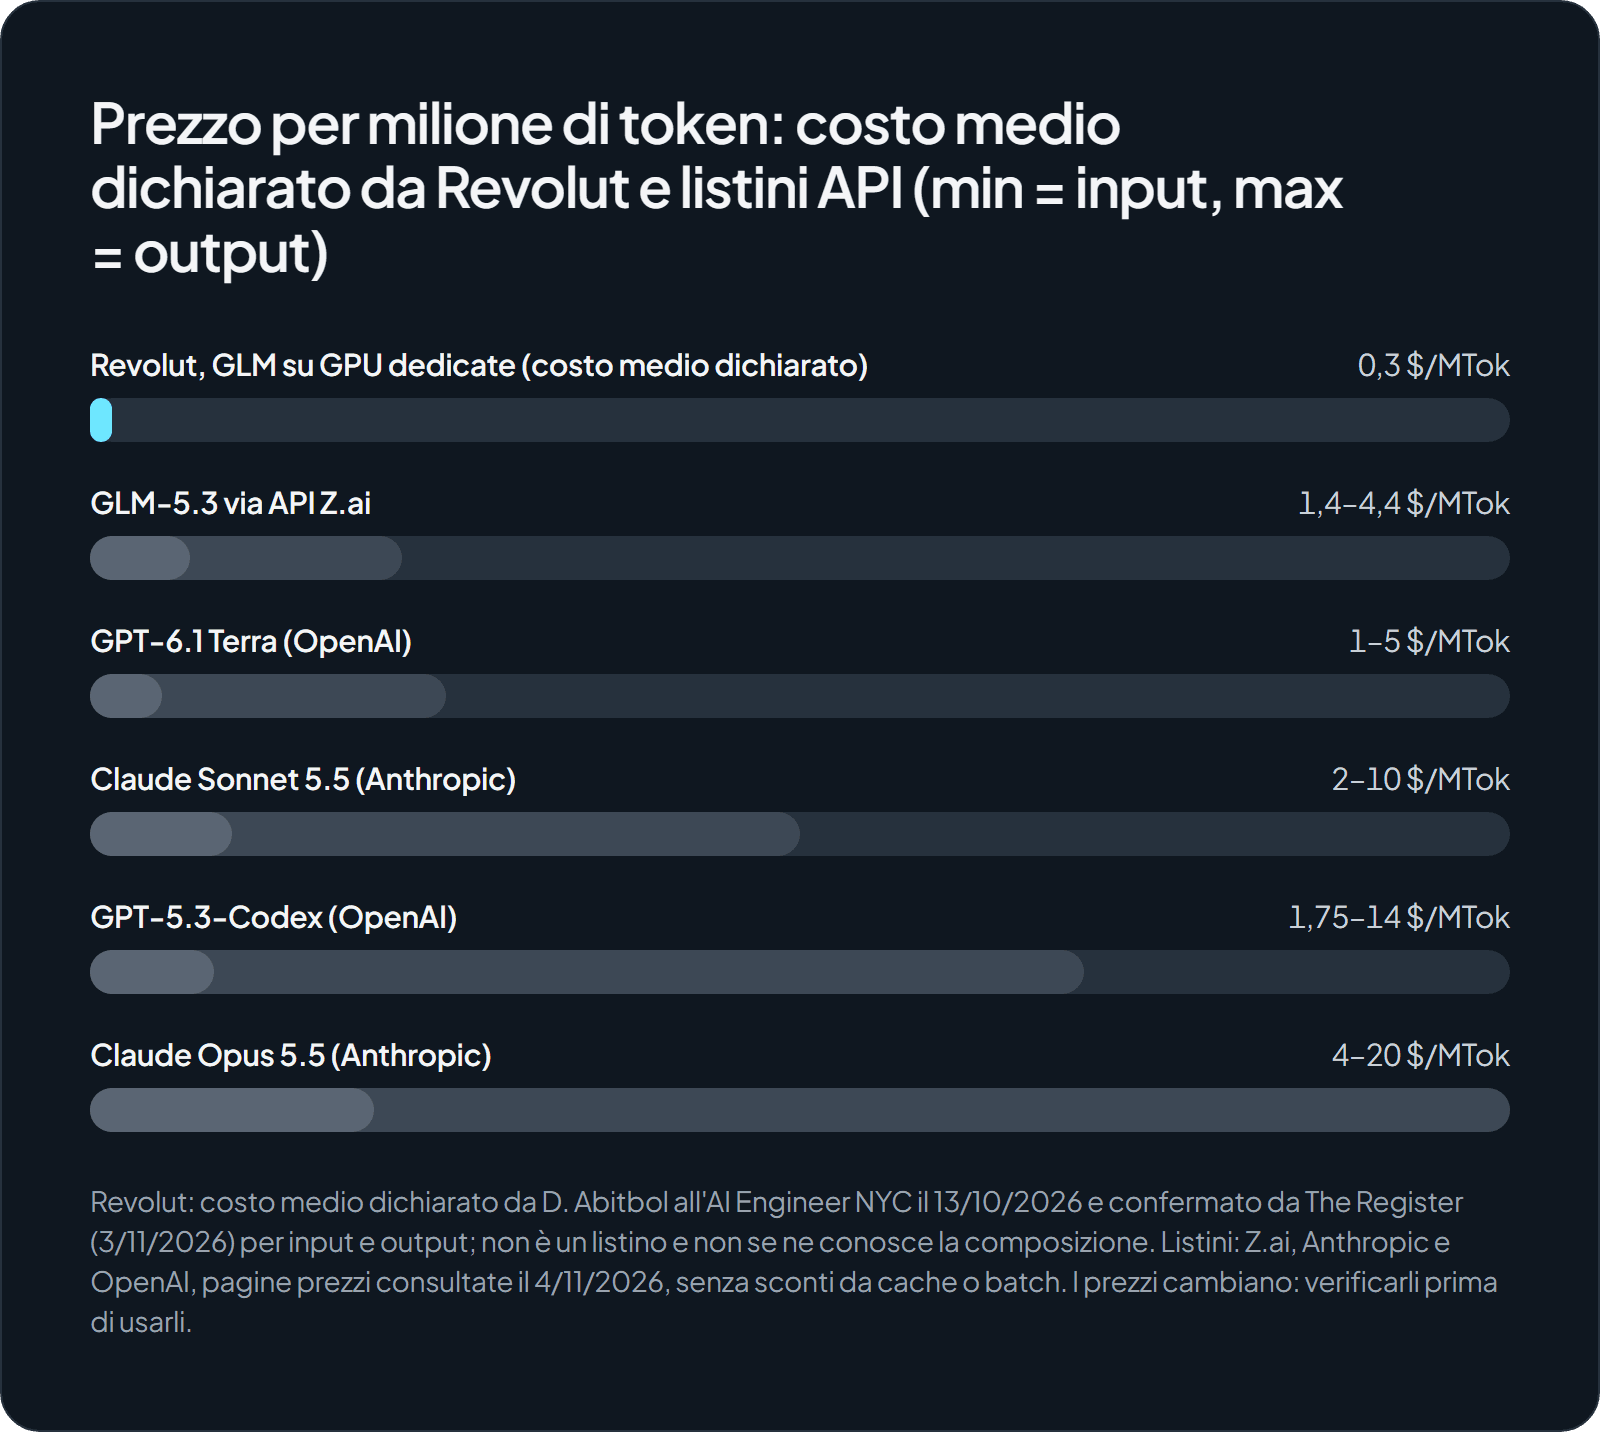
I 0,30 $ non sono un listino: sono un costo medio su un volume molto alto, di cui non si conosce la composizione (GPU, personale, rete). Le API si pagano a consumo, le GPU dedicate anche quando restano poco usate. C'è poi il terzo termine di confronto, gli abbonamenti: Anthropic indica Team Premium a 100 $ per posto con fatturazione annuale ed Enterprise a 20 $ per posto, minimo 20 posti, più il consumo API, con Claude Code incluso.
Per fare i conti sui propri numeri, la pagina sui costi dell'AI in locale e l'articolo su quando conviene un server AI invece delle API elencano le voci da considerare.
Dove girava davvero GLM, e quali dati passavano da chi?
Secondo il talk, GLM non girava su sistemi di Revolut ma presso terzi: Abitbol racconta di aver messo i pesi su un servizio basato negli Stati Uniti, precisando che non si trattava di un endpoint verso la Cina. Usare solo i pesi evita di mandare i dati al produttore del modello, ma la scelta dell'infrastruttura resta aperta. The Register parla di risorse "on-premises or regional cloud", ipotesi che la trascrizione smentisce almeno in parte.
Abitbol afferma che i fornitori di inferenza o di GPU hanno la conservazione zero dei dati come impostazione predefinita: è un'affermazione generale, da verificare nel contratto e nel DPA del proprio fornitore. Il suo criterio è che i dati restino in un paese coperto da un quadro di equivalenza. Per un'azienda dell'UE il riferimento è l'elenco delle decisioni di adeguatezza della Commissione, aggiornato al 23 luglio 2026: Regno Unito e Israele ci sono, gli Stati Uniti solo per le organizzazioni aderenti al Data Privacy Framework. Con un fornitore statunitense non certificato DPF, la base del trasferimento va valutata con il proprio DPO.
Le richieste instradate a Gemini o a GPT Luna portano invece i dati da Google o da OpenAI, alle loro condizioni. Per ricostruire eventuali incidenti, Abitbol indica un monitoraggio esteso con OpenTelemetry. Cosa controllare nelle API dei grandi fornitori è nella guida alle impostazioni privacy delle API AI; gli obblighi che restano all'azienda nella pagina su AI e GDPR.
Quali scelte tecniche hanno reso il modello open-weight abbastanza veloce per 2.000 ingegneri?
Abitbol indica nel talk quattro scelte: quantizzazione FP4 sulle GPU Blackwell, contesto limitato a 256.000 token, tasso di cache sopra il 90% e obiettivo di tempo al primo token sotto i 3 secondi. Dichiara un tempo al primo token sceso dell'88%, da 14,26 a 1,68 secondi, con una domanda cresciuta del 76% e oltre 7 richieste al secondo ad agosto. Sono numeri del relatore, non verificati da terzi.
- Quantizzazione. Il passaggio da FP8 a FP4 vale, secondo Abitbol, circa il 40% di risparmio, senza dire su quale voce. Ridurre la precisione va verificato sui propri compiti.
- Contesto. La scheda AWS indica 1 milione di token di contesto e fino a 128.000 in output, quella su Hugging Face 300.000 token con una strategia di gestione del contesto. Il talk non spiega il limite a 256.000; un'ipotesi è che richieste più corte permettano di servire più persone sulle stesse GPU.
- Cache. Gli strumenti di coding ripetono spesso lo stesso contesto, e i listini lo riflettono: Z.ai fa pagare l'input in cache di GLM-5.3 0,26 $ invece di 1,4 $.
Per una PMI il punto è che queste scelte richiedono competenze di gestione dell'inferenza, oppure un fornitore che porti il sistema già configurato. Un modello installato con le impostazioni predefinite non è detto che si avvicini a questi tempi.
Come funziona l'instradamento verso i modelli di frontiera per le eccezioni?
Un router manda a GLM il lavoro sul testo e le richieste con immagini a Gemini o a GPT Luna, perché GLM-5.3 accetta e restituisce solo testo. Gli endpoint sono compatibili con le API di OpenAI e si usano in OpenCode e Codex: cambiare il modello dietro il router tocca poco gli strumenti degli sviluppatori. È l'architettura che riduce il costo di un ritiro o di un rincaro, come spiegato nell'articolo sul vendor lock-in nell'AI.
La sintesi sulla pagina del talk cita anche un ambiente isolato con comandi approvati da una persona e Claude Code o Codex come eccezione. Non ho trovato le frasi nella trascrizione: sono indicazioni da confermare.
Lo schema è lo stesso che serve per assegnare il modello giusto a ogni passaggio di un processo. Come usare quelli di OpenAI, Anthropic e Google è nella pagina sui modelli di frontiera.
Cosa può replicare un'azienda italiana del caso Revolut, e cosa no?
Si può replicare lo schema, non la scala: un modello economico come default, i modelli di frontiera per le eccezioni, i consumi misurati.
GLM-5.3 ha 753 miliardi di parametri, MoE con circa 40 miliardi attivi per token, e la scheda su Hugging Face pubblica i pesi in BF16 e FP8. Anche in FP8, a circa un byte per parametro, i soli pesi occupano nell'ordine dei 750 GB: è un modello da data center, come altri della stessa taglia, ad esempio Kimi K3.1 Pro.
| Strada | Cosa serve | Dati |
|---|---|---|
| API di Z.ai | Nessun hardware; listino sopra | Le fonti consultate non dicono dove vengono trattati: va chiesto |
| Amazon Bedrock | Account AWS; GLM-5.3 dal 5 ottobre 2026 | Solo cross-region: dall'UE solo profilo globale, quindi anche fuori UE |
| GPU dedicate presso un fornitore | Contratto e competenze | In un paese adeguato, con DPA verificato |
| Open-weight più piccolo in locale | Server in azienda | Restano in azienda; adatto a compiti ripetitivi, da verificare |
La licenza non è la MIT, come scrivono alcuni aggregatori, ma la licenza "glm-5.3": permette l'uso commerciale, e solo chi vende il modello come servizio con oltre 10 miliardi di dollari di ricavi in 12 mesi deve superare una revisione di sicurezza di Z.ai. Una PMI non rientra nella clausola.
Quando i dati non devono uscire, un modello più piccolo sui server interni può coprire la parte ripetitiva: come si valuta è nella pagina sull'AI on-premise.
Quando conviene restare sui modelli di frontiera invece di seguire Revolut?
Conviene con volumi bassi o irregolari, compiti multimodali o molto complessi, nessuno che gestisca l'inferenza, o abbonamenti che già coprono l'uso. In questi casi un'infrastruttura dedicata aggiunge costi fissi senza un vantaggio chiaro.
Per un piccolo gruppo di sviluppatori, un posto con Claude Code incluso è un costo prevedibile. Anche sulle API ci sono margini: OpenAI applica uno sconto del 50% a Batch e Flex per i lavori non urgenti, mentre la residenza dei dati in una regione costa il 10% in più sui modelli usciti dal 5 marzo 2026. Il fattore 10 di Revolut riguarda la sua scala e il suo profilo d'uso, non è una previsione per altre aziende. Prima di cambiare modello serve sapere chi consuma cosa, come spiegato nell'articolo sul monitoraggio dei costi AI.
Da dove partire per valutare un modello open-weight come default con le eccezioni sui modelli di frontiera?
Si parte dai dati di consumo, non dal modello:
- Misurare i token per processo e per persona, e quale quota di richieste ha davvero bisogno di un modello di frontiera.
- Classificare le richieste: testo o immagini, lunghezza del contesto, sensibilità del dato.
- Provare un router compatibile con le API di OpenAI su un solo processo, con indicatori di qualità, latenza e costo decisi prima.
- Verificare il fornitore: contratto, DPA, conservazione, paese di trattamento e, se statunitense, certificazione DPF.
- Decidere l'infrastruttura solo alla fine: API, GPU dedicate o server in azienda.
Se usi già le API, la pagina sulla migrazione dalle API descrive il percorso. Con la valutazione iniziale guardiamo insieme volumi, processi e dati: se il quadro lo giustifica, server e software si possono fornire già configurati; se le API restano la scelta più sensata, te lo dico.
Domande frequenti
Chi sviluppa GLM, e con quale licenza si può usare?
GLM è sviluppato da Z.ai. GLM-5.3 ha 753 miliardi di parametri con architettura MoE e circa 40 miliardi attivi per token. Si distribuisce con la licenza 'glm-5.3', che non è la MIT come scrivono alcuni aggregatori. L'uso commerciale è permesso; solo chi vende il modello come servizio con ricavi oltre 10 miliardi di dollari l'anno deve superare una revisione di sicurezza di Z.ai.
I miglioramenti di produttività di Revolut dimostrano che GLM è migliore di Claude o GPT?
No. Revolut riporta miglioramenti del lead time e del tempo di sviluppo misurati nello stesso periodo del passaggio a GLM, ma il talk non isola l'effetto del modello da quello degli altri cambiamenti, a partire dalla fine dei limiti sui token. Sono indicatori interni utili, non un confronto controllato tra modelli.
Si può usare GLM-5.3 dall'Europa senza comprare GPU?
Sì, attraverso le API di Z.ai o Amazon Bedrock. Su Bedrock GLM-5.3 è disponibile solo con inferenza cross-region, e dall'Unione europea solo con il profilo globale: i dati possono quindi essere trattati fuori dall'UE. In entrambi i casi vanno verificati il contratto, la conservazione dei dati e il paese in cui avviene il trattamento.
Il costo di 0,30 $ per milione di token si può confrontare direttamente con i listini delle API?
Solo in parte. È un costo medio dichiarato da Revolut su un volume molto alto e non se ne conosce la composizione (GPU, personale, rete). I listini delle API invece sono prezzi pubblici a consumo. Per un confronto onesto bisogna stimare il proprio volume e il costo totale su più anni.
Cos'è il tempo al primo token e perché conta per chi programma con l'AI?
È il tempo che passa tra l'invio della richiesta e il primo pezzo di risposta. Negli strumenti di coding che fanno molte chiamate in sequenza, pochi secondi in più a ogni passaggio rallentano tutto il lavoro: per questo Revolut si era data l'obiettivo di stare sotto i 3 secondi.
Chi scrive
AI engineer
Sono un AI engineer: progetto e realizzo sistemi di intelligenza artificiale per le aziende, soprattutto nei processi commerciali come vendite, assistenza clienti, qualificazione dei contatti e automazione. Seguo la parte tecnica dall'inizio alla fine: configuro i server per l'AI in locale, sviluppo assistenti sui documenti e agenti, e li integro con i programmi già in uso in azienda.
Da leggere dopo
Quando conviene acquistare un server AI invece di pagare le API?
Comprare un server AI conviene quando i volumi sono alti e stabili, i dati sono sensibili e c'è chi lo gestisce. Partendo dai rincari dei listini e da un preprint sul punto di pareggio vediamo come fare i conti, e quando le API restano la scelta migliore.
Costi e TCO10 min
Modelli AI piccoli o di frontiera: quale usare per ogni passaggio dei processi aziendali
Non ogni passaggio di un processo ha bisogno di un modello di frontiera. Listini, benchmark indipendenti e licenze ci dicono dove bastano i modelli AI piccoli, anche in locale, e dove il modello grande vale quello che costa.
AI nei processi aziendali12 min
Kimi K3.1 Pro: il modello open-weight da 1 milione di token si può usare in azienda, anche in locale?
Kimi K3.1 Pro di Moonshot AI si avvicina a Claude Opus 5.5 nei benchmark e costa meno via API. I dati però passano da Singapore, e i pesi annunciati per il 4 novembre richiedono hardware da data center. Ecco cosa sapere prima di usarlo in azienda.
AI in locale e on-premise9 min