Modelli AI piccoli o di frontiera: quale usare per ogni passaggio dei processi aziendali
Non ogni passaggio di un processo ha bisogno di un modello di frontiera. Listini, benchmark indipendenti e licenze ci dicono dove bastano i modelli AI piccoli, anche in locale, e dove il modello grande vale quello che costa.
Pubblicato il
Tra modelli AI piccoli e modelli di frontiera non si sceglie una volta per tutto il processo: si sceglie passaggio per passaggio. Per classificare, smistare ed estrarre dati da un testo conviene provare per primo un modello piccolo, anche in locale. Il ragionamento in più passaggi, la programmazione complessa e le decisioni con effetti legali o economici restano in genere il terreno dei modelli più grandi. Tra il modello più economico e il più caro di OpenAI il prezzo dell'output cambia di 100 volte (pagina prezzi OpenAI). Per questo nei flussi ripetitivi la scelta va fatta con test sui propri casi, non sui benchmark dei fornitori.
Modelli AI piccoli o di frontiera: cosa cambia davvero in un processo aziendale?
Cambiano il costo e la qualità di ogni singolo passaggio, perché un processo non è un compito unico. Un flusso comune: arriva un'email di un cliente, la si classifica, se ne estraggono i dati, si prepara una risposta e si aggiorna il CRM. Sono passaggi con esigenze diverse, e ognuno può usare un modello diverso.
I modelli dei grandi fornitori si possono dividere in tre fasce (nomi e prezzi dalle pagine ufficiali di OpenAI, Anthropic e Google):
- Piccoli ed economici: gpt-6-luna e gpt-5.4-nano, Claude Haiku 5.5, Gemini 3.1 Flash-Lite. Tra gli open-weight c'è LFM3-1.7B di Liquid AI, che gira sui propri computer.
- Intermedi: GPT-6.1 Terra, Claude Sonnet 5.5, Gemini 3.8 Flash.
- Di frontiera: gpt-6-astra, gpt-6.1-sol, Claude Opus 5.5, Gemini 4 Argon.
Gli stessi fornitori non presentano il modello più grande come una necessità. La guida di OpenAI alla scelta del modello dice che "if cost and latency aren't a concern, you can default to Astra", ma consiglia anche di "keep the lightest setting that meets your quality bar": tenere l'impostazione più leggera che raggiunge la qualità richiesta. E ricorda che in un'automazione frequente consumi e costi crescono più in fretta che in un progetto occasionale.
Nell'articolo su come creare un agente AI ho trattato la scelta del primo flusso. Qui il tema è il passo successivo: quale modello assegnare a ogni passaggio, che è il lavoro della consulenza per l'AI nei processi aziendali.
Quanto costa ogni fascia di modello a token, e quanto pesa la differenza su un flusso ripetitivo?
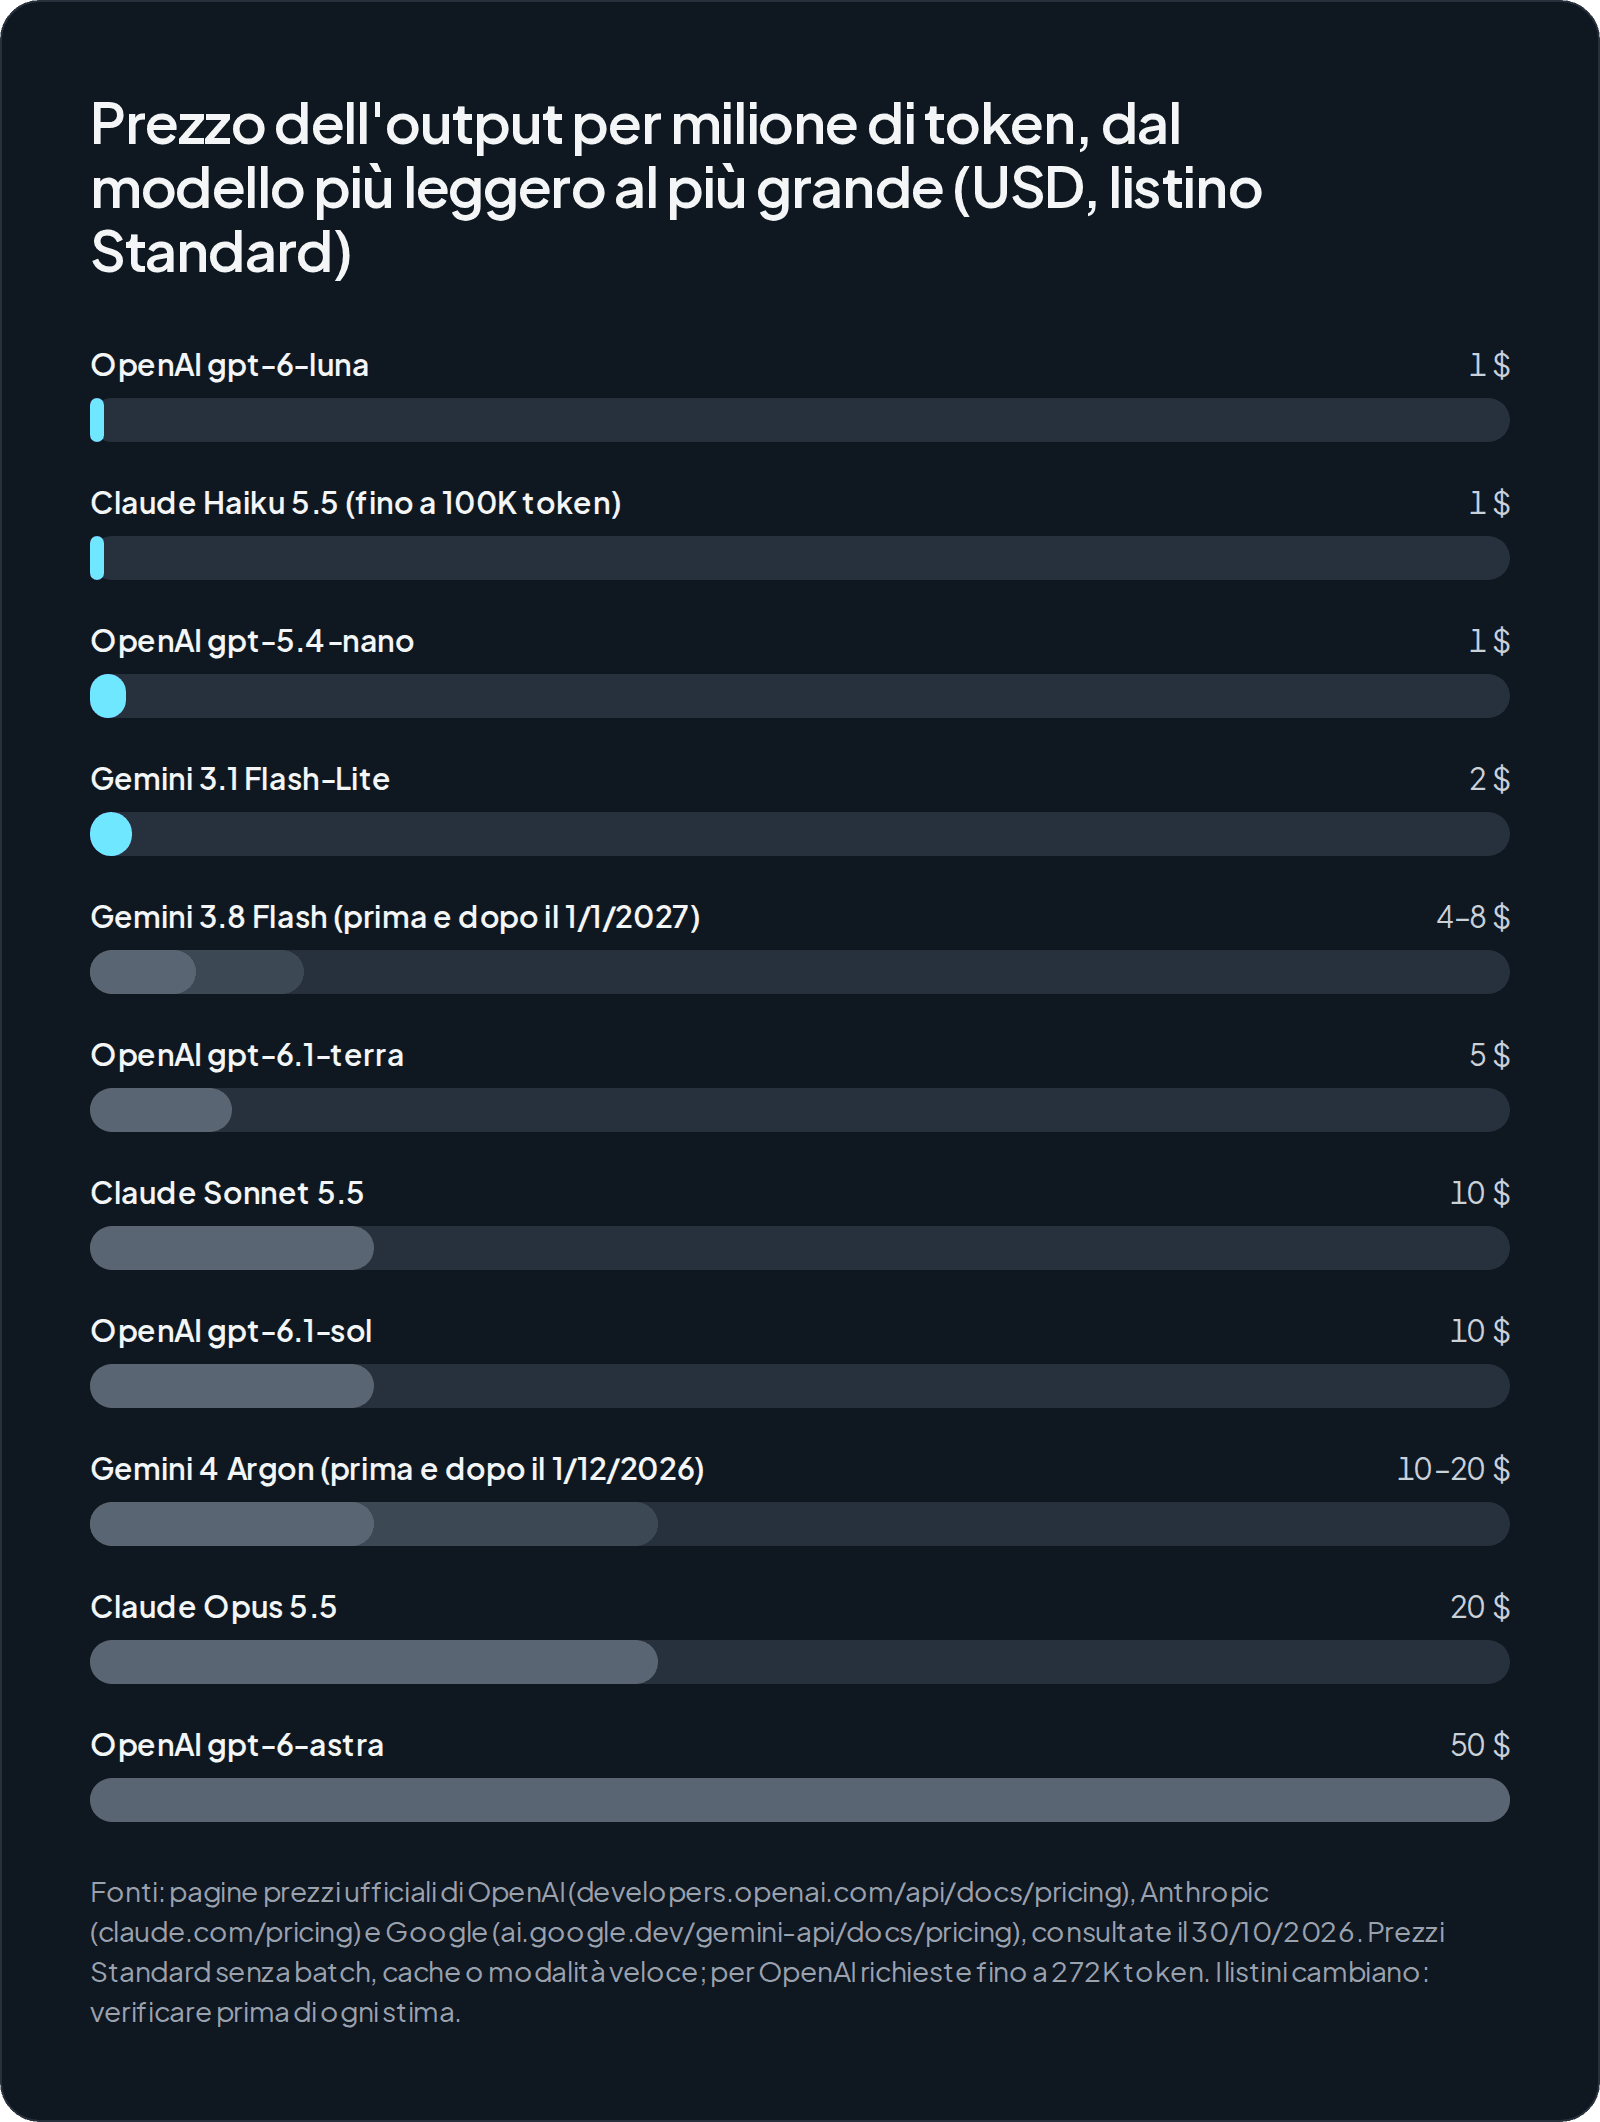
Le distanze sono ampie. Da OpenAI, gpt-6-luna costa 0,50 $ per milione di token in uscita e gpt-6-astra 50 $ (OpenAI). In tabella i prezzi Standard in dollari per milione di token, consultati il 30/10/2026: i listini cambiano e vanno ricontrollati prima di ogni stima.
| Fascia | Modello | Input | Output | Note |
|---|---|---|---|---|
| Piccola | gpt-6-luna | 0,10 | 0,50 | |
| Piccola | Claude Haiku 5.5 | 0,10 | 0,50 | fino a 100K token; sopra, 0,50 / 2,50 |
| Piccola | gpt-5.4-nano | 0,20 | 1,25 | |
| Piccola | Gemini 3.1 Flash-Lite | 0,25 | 1,50 | nessuna variazione annunciata |
| Intermedia | Gemini 3.8 Flash | 0,75 | 3,75 | 1,50 / 7,50 dal 1/1/2027 |
| Intermedia | gpt-6.1-terra | 1,00 | 5,00 | sopra 272K token, 2,00 / 7,50 |
| Intermedia | Claude Sonnet 5.5 | 2,00 | 10,00 | |
| Frontiera | gpt-6.1-sol | 2,00 | 10,00 | |
| Frontiera | Gemini 4 Argon | 2,00 | 10,00 | 4,00 / 20,00 dal 1/12/2026 |
| Frontiera | Claude Opus 5.5 | 4,00 | 20,00 | |
| Frontiera | gpt-6-astra | 10,00 | 50,00 |
Fonti: prezzi OpenAI, prezzi Claude, prezzi Gemini API. Le fasce sono una mia classificazione, non dei fornitori.
Il listino è solo il punto di partenza:
- Batch: tutti e tre i fornitori fanno pagare la metà le richieste elaborate in differita (OpenAI, Anthropic, Google), adatto per esempio all'estrazione notturna dai documenti.
- Fast mode di OpenAI: dove disponibile costa il doppio dello Standard (OpenAI).
- Regione di elaborazione: da OpenAI +10% per i modelli rilasciati dal 5 marzo 2026 (OpenAI); da Anthropic l'inferenza solo negli USA costa 1,1 volte lo standard (Anthropic).
I listini salgono anche: Google ha annunciato il raddoppio dei prezzi di Gemini 4 Argon dal 1° dicembre 2026 e di Gemini 3.8 e 3.6 Flash dal 1° gennaio 2027 (Google), come ho spiegato nell'articolo sui prezzi delle API di Gemini.
Quali passaggi di un processo reggono bene i modelli AI piccoli?
Quelli con un compito circoscritto e una risposta di forma prevista: classificazione, smistamento, estrazione di campi, scelta dello strumento da chiamare, output strutturati. Qui il modello piccolo è il primo candidato da provare.
Anthropic consiglia Haiku per "quick lookup or categorization" e per "extracting specific information from text" (Anthropic Academy). Liquid AI indica per LFM3 lo smistamento della posta, la gestione del calendario, la ricerca web e la scelta dello strumento giusto tra migliaia (blog Liquid AI); la scheda del modello aggiunge agenti locali, chiamata di strumenti, output strutturati e fine-tuning.
Secondo i benchmark pubblicati dal fornitore, senza valutazioni indipendenti dichiarate, LFM3-1.7B supera il più grande Qwen3.5-9B nella media dei test principali (49,37 contro 47,24), su BFCL V4 (71,39 contro 62,83), su IFEval (96,66 contro 92,08) e su AutomationBench (41,29 contro 15,10) (Liquid AI). Se reggessero a una verifica indipendente, direbbero che su alcuni compiti agentici un modello piccolo tiene testa a uno più grande: un'ipotesi da controllare sui propri casi.
Per collegare un modello a ERP e CRM servono risposte in formato prevedibile: OpenAI scrive che "only Structured Outputs ensure schema adherence" (OpenAI). Ma un codice articolo può stare nel campo giusto ed essere sbagliato, e infatti la stessa pagina raccomanda di "create and use evals".
Esempi per reparto: l'ufficio ordini estrae codici e quantità dalle email, l'assistenza smista i ticket per categoria e urgenza, il commerciale etichetta i lead prima di assegnarli. Sono punti di partenza tipici per gli agenti AI personalizzati.
In quali passaggi serve ancora un modello di frontiera?
Nel ragionamento in più passaggi, nella programmazione agentica, nelle analisi che richiedono molta conoscenza di dominio e nelle decisioni con conseguenze legali o economiche.
Lo ammette chi vende il modello piccolo: "larger models still win on agentic coding and knowledge, where size matters most", anche se "search helps close the knowledge gap" (Liquid AI). Sullo stesso blog, contro Qwen3.5-9B, LFM3-1.7B ottiene 63,37 contro 80,40 su GPQA Diamond, 43,40 contro 51,20 su SWE-bench Verified e 32,57 contro 42,67 su MCP-Atlas (Liquid AI). La scheda del modello lo dice chiaramente: "not recommended for agentic coding or complex multi-step reasoning due to its small size", e per i compiti ad alta intensità di conoscenza suggerisce di affiancargli il recupero dei documenti, lo stesso principio del cervello aziendale sui documenti interni.
Il limite vale anche per la fascia intermedia: per la programmazione più complessa OpenAI consiglia ancora Sol o Astra al posto di GPT-6.1 Terra (BleepingComputer). Anthropic suggerisce Opus per i "problems where you've tested with Sonnet and it struggled" (Anthropic Academy): si sale di fascia dopo un test, non per principio.
Il criterio che uso: il modello grande si giustifica quando un errore costa più della differenza di prezzo e il volume è basso. Una revisione di contratto al giorno è un buon candidato, diecimila email al mese no.
Cosa dicono davvero i benchmark di GPT-6.1 Terra e degli altri modelli intermedi?
Dipende da chi misura: i numeri dei fornitori riguardano compiti scelti da loro, i test indipendenti spesso mostrano un modello più disomogeneo.
Al lancio, riportato da BleepingComputer il 26 ottobre 2026, OpenAI ha indicato per GPT-6.1 Terra 1 $ in ingresso e 5 $ in uscita per milione di token, il 50% in meno di GPT-5.6 Terra e GPT-6.1 Sol (BleepingComputer). Secondo OpenAI, Terra guadagna 15 punti su Agents' Last Exam rispetto a GPT-5.6 Terra, raggiunge il livello di Astra a un prezzo per token dieci volte più basso, è più di tre volte più veloce di Astra e Sol e, con lo sforzo di ragionamento massimo, ottiene il 50,3% su Terminal-Bench 4.0 contro il 21,5% del predecessore (BleepingComputer).
Vals AI, società di valutazione esterna, ha misurato con lo sforzo massimo il 49,49% su Terminal-Bench 4.0, vicino al dato dichiarato, l'84,00% su Vibe Code Bench (ventesimo su 122) e il 60,47% sul Vals Index (undicesimo su 30) (Vals AI). Gli stessi test di Vals AI danno risultati più deboli altrove: Finance Index al 52,86% (ventinovesimo su 34), Legal Index al 58,64% (ventinovesimo su 31), Tax Agent Bench al 15,17% (cinquantanovesimo su 79). Vals osserva che in ambito legale e fiscale il modello spesso non arriva alla conclusione che i fatti permetterebbero.
Anche questa fonte ha limiti: la pagina riporta il Vals Index al 60,47% in tabella e al 60,17% negli aggiornamenti, e non contiene test di estrazione dati né di classificazione (Vals AI), cioè i passaggi più comuni nei processi aziendali. E lo sforzo massimo ha un prezzo: su Vals 2,925 $ per test, con una latenza di 39 minuti e 35 secondi (Vals AI). Lo sforzo di ragionamento è una leva di costo e di tempo che si aggiunge alla scelta del modello.
Per LFM3 non c'è alcuna valutazione indipendente dichiarata; le citazioni di AMD, Qualcomm e Ambarella sul blog di Liquid AI sono dichiarazioni di partner (Liquid AI). La conclusione vale per tutti i modelli: servono test propri, sui propri documenti.
Un modello AI piccolo in locale: cosa serve per farlo girare e cosa dice la licenza?
Il modello è leggero, ma prima va letta la licenza. LFM3-1.7B ha 1,73 miliardi di parametri e supporta 16 lingue, italiano compreso (Hugging Face). Gestisce 256K token di contesto, a 4 bit occupa circa 1 GB e, con 128K token di contesto, Liquid AI dichiara 1,6 GB di KV cache contro 4,3 GB di Qwen3.5-4B (Liquid AI).
Si avvia con llama.cpp, che espone un server locale compatibile con le API di OpenAI, oppure con Ollama (Hugging Face). Il codice scritto per le API cloud si può quindi puntare sul server interno con modifiche contenute, con i limiti descritti nella guida su come migrare dalle API OpenAI a un LLM locale. Sulla velocità i dati sono parziali: Liquid AI dichiara una generazione da 1,8 a 2,8 volte più rapida del modello di confronto con llama.cpp, senza indicare token al secondo né dispositivi, e circa 3,6 miliardi di token al giorno su una NVIDIA B300 (Liquid AI): un dato da data center, non da ufficio.
La licenza, indicata nella scheda del modello, è la LFM Open License v1.0, che copre l'uso commerciale solo sotto la soglia di 10 milioni di dollari di fatturato annuo e decade se non se ne rispettano i termini. Chi supera la soglia, o potrebbe superarla durante il progetto, deve leggere il testo completo prima del pilota e prevedere un'alternativa con licenza più permissiva.
Se il locale ha senso, i conti su hardware, installazione e assistenza sono nella pagina sui costi dell'AI in locale, e server e software si possono fornire già configurati. Con volumi bassi, però, un modello piccolo via API costa pochi dollari al mese: lì il locale si giustifica con i dati, non con il risparmio.
Quali dati escono dall'azienda a ogni passaggio, e come cambia scegliendo il modello?
Esce tutto il testo che il passaggio elabora: email, allegati, estratti del gestionale. Se smistamento ed estrazione girano su un modello piccolo in locale, si riduce ciò che esce senza rinunciare alla frontiera dove serve.
Le condizioni cambiano da un servizio all'altro:
- Conservazione: nei nuovi progetti Gemini a pagamento le richieste sono salvate di default (
store=true), disattivabile constore=falseo dalla dashboard "Logs and Datasets"; il changelog non dice per quanto restano né se servono all'addestramento (Google). - Livello gratuito: nel livello gratuito di Gemini 3.8 e 3.6 Flash i dati servono a migliorare i prodotti Google, in quello a pagamento no (Google).
- Isolamento tra clienti: su Workers AI di Cloudflare, con GLM-5.3, dal 27 agosto al 9 settembre 2026 155 risposte hanno contenuto dati di altri clienti, per una configurazione sbagliata sommata a un bug di SGLang; Cloudflare consiglia SGLang v0.5.22 o successive (Cloudflare).
Il caso Cloudflare insegna che il rischio esiste nei servizi condivisi e che chi usa lo stesso software in locale deve tenerlo aggiornato. L'ho approfondito nell'articolo sull'isolamento dei dati nelle API AI.
Uno schema ibrido possibile:
- un modello piccolo in locale classifica le richieste e, se i test lo confermano affidabile, toglie i dati personali non necessari;
- un modello di frontiera via API lavora solo sui casi che lo richiedono;
- un registro tiene traccia di cosa è stato inviato e a chi.
Non rende conformi in automatico: gli obblighi restano, e sono descritti nella pagina su AI e GDPR. Aiuta però a sapere quali dati escono, e a ridurli.
Da dove partire per assegnare il modello giusto a ogni passaggio?
Dal processo, non dal modello. Si divide il flusso in passaggi, si prepara un insieme di casi reali con la risposta attesa, si prova il modello più leggero e si sale di fascia solo dove i test lo giustificano.
Nel confronto tra due modelli vale il consiglio di Anthropic: "compare where the answers differ, not how long they are" (Anthropic Academy). Poi si fissano le regole di instradamento: il modello piccolo lavora per default, un caso passa al modello grande quando esce dalle categorie previste o serve una decisione, una persona rivede i passaggi con effetti su clienti, ordini o contabilità.
Per ogni passaggio si misurano costo per pratica, tasso di errore, tempo impiegato e quota di casi passati al modello grande, e si ripete la misura quando cambiano i listini o un fornitore ritira un modello, come spiego nell'articolo sul vendor lock-in nell'AI.
Nella valutazione iniziale mappiamo insieme i passaggi di un tuo processo e scegliamo, per ognuno, tra API di frontiera, modello in locale o una combinazione. Se serve, server e software si possono fornire già pronti. Se il volume è basso e i dati lo permettono, però, le API restano spesso la scelta più semplice, e te lo dico.
Domande frequenti
Per semplicità non conviene usare un solo modello di frontiera per tutto il processo?
Può convenire quando i volumi sono bassi e il costo non pesa: la stessa guida di OpenAI dice che, se costo e latenza non sono un problema, si può partire da Astra. Nei flussi ripetitivi però la differenza di prezzo tra le fasce si moltiplica su ogni richiesta, e si aggiungono tempi di risposta più lunghi. Un compromesso diffuso è partire con un solo modello e poi spostare sul modello più leggero i passaggi che superano i test.
Il prezzo per token è l'unico costo da considerare quando si sceglie un modello?
No. Contano anche lo sforzo di ragionamento impostato (che fa crescere i token in uscita e i tempi), le richieste ripetute dopo un errore, la modalità scelta (batch, standard o veloce), la residenza dei dati quando costa di più e il tempo delle persone che controllano i risultati. Un modello economico che sbaglia spesso può costare più di uno caro che sbaglia di rado.
Un modello piccolo si può migliorare con il fine-tuning sui dati aziendali?
La scheda di LFM3-1.7B indica il fine-tuning tra gli usi previsti. Servono però esempi corretti ed etichettati, un modo per misurare il miglioramento e una licenza compatibile con l'uso commerciale della propria azienda. Per le domande sui documenti interni di solito si parte dal recupero dei documenti (RAG), non dall'addestramento.
Cosa succede se il modello piccolo classifica male una richiesta?
L'errore si propaga ai passaggi successivi, per questo vanno previsti dei controlli: categorie chiuse e definite, uno schema di output da validare, il passaggio automatico a un modello più grande o a una persona quando il caso è ambiguo, e un registro per ritrovare gli errori. La garanzia di formato offerta dagli output strutturati non garantisce che i valori siano giusti.
Posso mescolare fornitori diversi nello stesso processo?
Sì, ed è uno dei modi per ridurre la dipendenza da un solo fornitore: per esempio un modello locale o economico per lo smistamento e un modello di frontiera di un altro fornitore per la risposta finale. Bisogna però tenere conto di contratti, condizioni sui dati e conservazione diversi per ogni fornitore, e documentare quali dati passano da chi.
Chi scrive
Lilium AI
AI nei processi aziendali: in locale per i dati sensibili, con i modelli di frontiera per il resto
Da leggere dopo
Come creare un agente AI per l'azienda: dal processo da ottimizzare al primo flusso in produzione
Per creare un agente AI si parte dal processo, non dallo strumento. Vediamo come scegliere il primo flusso, quando basta un workflow, quale modello usare per ogni passaggio, quali dati escono dall'azienda e quali controlli servono prima della produzione.
AI nei processi aziendali10 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min
Vendor lock-in nell'AI: cosa costa quando il fornitore ritira o cambia il modello che usi
I fornitori di AI ritirano i modelli con preavvisi da 45 giorni a 6 mesi, e i sostituti possono costare molto di più. Come stimare il costo del vendor lock-in AI e come ridurlo con modelli open-weight e un'architettura che non dipenda da un solo fornitore.
Integrazione con ERP, CRM e migrazione API10 min