Impostazioni privacy delle API AI: cosa controllare prima di inviare dati aziendali a OpenAI, Gemini e Claude
Le impostazioni privacy delle API di OpenAI, Gemini e Claude decidono per quanto restano i prompt, dove vengono elaborati e chi li può leggere. Dal 26 ottobre 2026 Gemini salva le richieste di default nei nuovi progetti: ecco cosa verificare.
Pubblicato il
Le impostazioni privacy delle API AI stabiliscono se i prompt servono all'addestramento, per quanto restano sui server del fornitore, dove vengono elaborati e chi in azienda può leggerli. Su OpenAI, Gemini e Claude vanno controllate progetto per progetto: dal 26 ottobre 2026, per esempio, Gemini salva di default le richieste nei nuovi progetti a pagamento (note di rilascio Google). OpenAI conserva i log antiabuso fino a 30 giorni e Anthropic cancella input e output entro 30 giorni, ma con eccezioni molto più lunghe. Le impostazioni possono ridurre l'esposizione dei dati, ma non sostituiscono il contratto né gli obblighi del titolare.
Quali impostazioni privacy API AI controllare prima di inviare dati aziendali?
Per ogni progetto ci sono sei punti da verificare:
- se i dati servono all'addestramento;
- per quanto tempo vengono conservati;
- se le richieste vengono salvate (parametro
storeo log); - in quale regione vengono elaborati e archiviati;
- chi ha accesso a chiavi e log;
- quali sub-responsabili intervengono e cosa dice il contratto.
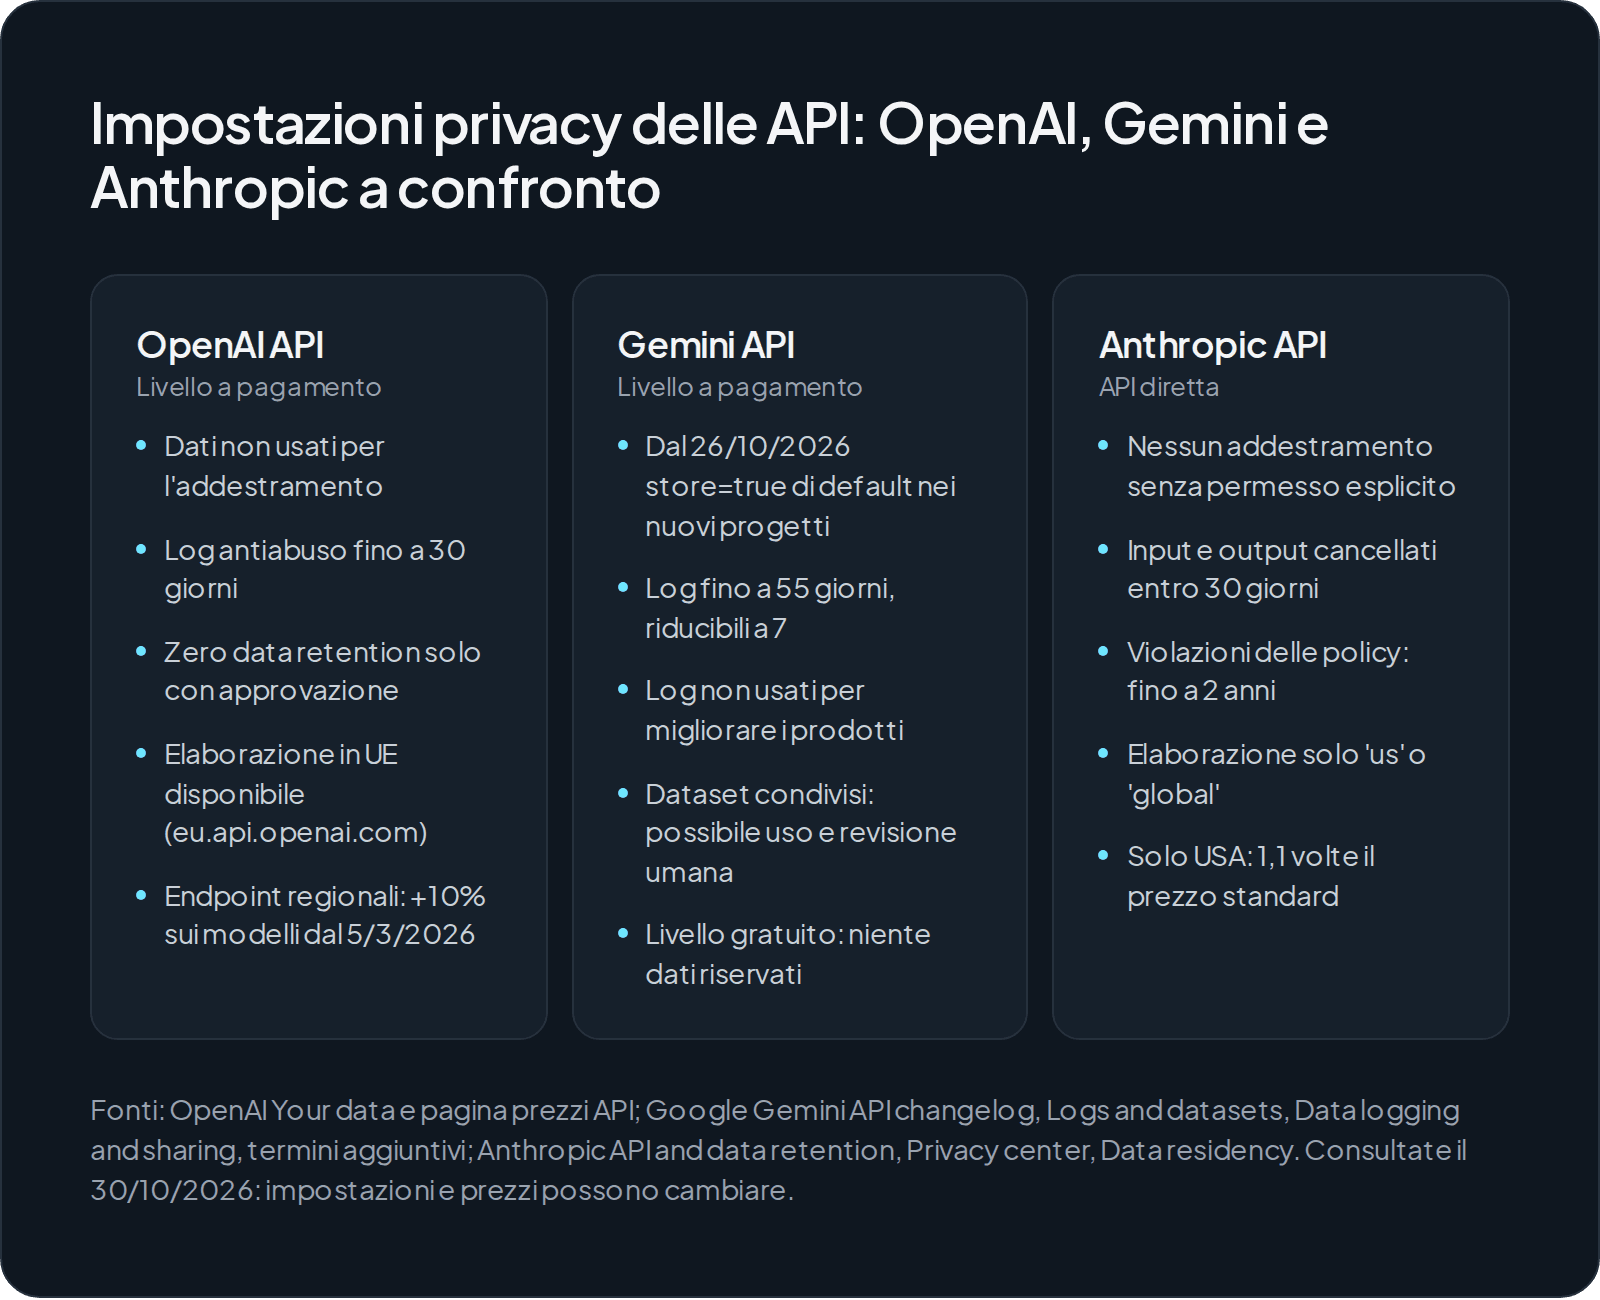
La tabella riassume cosa dicono le pagine ufficiali dei tre fornitori, consultate il 30/10/2026. Le condizioni cambiano: vanno ricontrollate prima di ogni decisione.
| Punto | OpenAI | Gemini (livello a pagamento) | Anthropic |
|---|---|---|---|
| Addestramento | Dati API non usati (Your data) | Log non usati per migliorare i prodotti; i dataset condivisi con Google possono esserlo (Data logging) | Dati conservati non usati senza permesso espresso (Data retention) |
| Conservazione | Log antiabuso fino a 30 giorni (Your data) | Log per 55 giorni di default, riducibili a 7 (Logs and datasets) | Input e output cancellati entro 30 giorni, violazioni fino a 2 anni (Privacy center) |
| Salvataggio richieste | Con zero data retention store è trattato come false (Your data) | store=true di default nei nuovi progetti dal 26/10/2026 (changelog) | Zero data retention solo su accordo (Privacy center) |
| Regione di elaborazione | USA, Europa ed Emirati (Your data); endpoint regionali a +10% sui modelli usciti dal 5 marzo 2026 (prezzi) | Non trattata nelle pagine consultate: va chiesta | Solo "us" o "global" sull'API diretta (Data residency) |
| Accesso a chiavi e log | Impostazioni per progetto, ereditabili dall'organizzazione (Your data) | Chiavi legate al permesso apikeys.keys.create (API key) | Ruoli User, Developer, Billing e Admin (ruoli Console) |
| Contratto e deroghe | ZDR su approvazione preventiva (Your data) | Termini aggiuntivi aggiornati il 28/04/2026 (termini) | Su Bedrock e Google Cloud il responsabile è il provider cloud (Data retention) |
Queste impostazioni non valgono per l'azienda intera. OpenAI configura la residenza dei dati per progetto (OpenAI); Anthropic permette agli amministratori di imporre allowed_inference_geos e default_inference_geo per ogni spazio di lavoro (Anthropic). Un progetto ben configurato può convivere con un altro lasciato sui valori predefiniti.
Configurare bene la console riduce i dati esposti, ma non rende conformi in automatico: gli obblighi del titolare del trattamento restano all'azienda. Ne parlo nella pagina su AI e GDPR.
Cosa cambia con il salvataggio di default delle richieste nelle API di Gemini?
Dal 26 ottobre 2026, nei nuovi progetti del livello a pagamento, le chiamate generateContent, streamGenerateContent e batchGenerateContent salvano le richieste di default (store=true), mentre i progetti esistenti mantengono l'impostazione attuale (note di rilascio Gemini). Per disattivare il salvataggio si passa store=false nella singola richiesta, oppure si spegne il logging in Settings, nella dashboard Logs and Datasets.
I log scadono dopo 55 giorni, salvo che vengano salvati in un dataset; la finestra si può ridurre a 7, 14 o 28 giorni (Logs and datasets). Nei progetti con fatturazione attiva, prompt e risposte nei log non servono a migliorare i prodotti (Data logging and sharing).
Il punto delicato sono i dataset. Se si condivide un dataset con Google, i dati possono essere usati per sviluppare i prodotti di Google e letti da revisori umani; il rifiuto si esprime alla creazione del dataset, e i log salvati in un dataset non hanno una scadenza prestabilita (Data logging and sharing). La stessa pagina cita un "Contributor Tier" su invito che offre token scontati in cambio dell'uso dei dati: da valutare con chi si occupa di privacy.
Alcune richieste non finiscono nei log: quelle a Imagen e Veo, gli embedding, Gemini Robotics e le richieste con video, GIF o PDF (Logs and datasets). Non significa conservazione zero: i termini aggiuntivi prevedono che Google registri prompt e risposte per un periodo limitato, per individuare abusi e rispettare obblighi di legge, senza indicare quanti giorni. Con il grounding su Google Search, prompt e output restano 30 giorni (termini Gemini API).
Sul livello gratuito Google usa i contenuti per migliorare i prodotti, revisori umani possono leggerli e i termini chiedono di non inviare informazioni riservate o personali; nello Spazio economico europeo, in Svizzera e nel Regno Unito, per le applicazioni rese disponibili agli utenti si possono usare solo i servizi a pagamento (termini Gemini API). Listini e rincari sono in prezzi delle API di Gemini.
Per quanto tempo OpenAI, Google e Anthropic conservano prompt e risposte?
Per OpenAI e Anthropic la regola di base è 30 giorni; per Gemini dipende dal logging. Ci sono poi eccezioni che allungano molto i tempi.
OpenAI. I dati inviati alle API non vengono usati per addestrare i modelli, e i log antiabuso restano fino a 30 giorni (Your data). Lo zero data retention (ZDR) e il Modified Abuse Monitoring richiedono un'approvazione preventiva. Diversi endpoint restano comunque esclusi dallo ZDR: Conversations, Assistants, Threads, Vector Stores, Files, Batches e Fine-tuning (Your data). Le funzioni che salvano uno stato vanno quindi censite a parte.
Anthropic. Input e output vengono cancellati entro 30 giorni, ma le violazioni delle policy d'uso restano fino a 2 anni, i punteggi di classificazione fino a 7 anni e i feedback 5 anni (privacy center). Lo ZDR si ottiene solo su accordo, e anche così i cosiddetti "Covered Models" richiedono una conservazione di 30 giorni; l'Activity Feed della Compliance API e le trascrizioni delle sessioni remote di Cowork restano 6 anni (Anthropic, data retention).
Google. Log fino a 55 giorni, con durata configurabile (Logs and datasets); dataset senza scadenza prestabilita (Data logging); conservazione antiabuso di durata non dichiarata (termini).
Si può scegliere dove vengono elaborati i dati, e quanto costa farlo?
Con OpenAI sì, anche in Europa, pagando il 10% in più sui modelli usciti dal 5 marzo 2026 (prezzi OpenAI). Con l'API diretta di Anthropic no: l'elaborazione è solo "us" o "global" (Data residency).
OpenAI. Il dominio europeo è eu.api.openai.com e copre Spazio economico europeo e Svizzera. L'elaborazione regionale esiste solo per USA, Europa ed Emirati: le altre regioni offrono soltanto l'archiviazione ("Support for regional storage does not imply support for regional processing"). La regione si sceglie alla creazione del progetto, e fuori dagli USA non si può impostare store=true su chat/completions (Your data).
La pagina prezzi (consultata il 30/10/2026, soggetta a modifiche) indica in dollari per milione di token (input / input in cache / output, fino a 272K token di input): gpt-6.1-terra 1,00 / 0,05 / 5,00; gpt-6.1-sol 2,00 / 0,10 / 10,00; gpt-6-astra 10,00 / 1,00 / 50,00.
Anthropic. La geografia dello spazio di lavoro accetta solo "us" e non si cambia dopo la creazione; l'elaborazione solo negli USA costa 1,1 volte il prezzo standard sui modelli Claude 4.6 e successivi (Data residency). Su Amazon Bedrock e Google Cloud la regione dipende dall'endpoint scelto, ma il responsabile del trattamento diventa il provider cloud (data retention).
Google. Le pagine Gemini consultate non trattano la regione di elaborazione: va chiesta al fornitore.
Una regione europea, inoltre, può non chiudere il tema della giurisdizione a cui è soggetto il fornitore: ne parlo in sovereign AI.
Chi in azienda può creare chiavi, leggere i log e cambiare le impostazioni?
Dipende dai ruoli configurati nella console di ogni fornitore, e spesso le persone abilitate sono più di quelle che si immaginano.
Gemini. Per creare una chiave serve il permesso IAM apikeys.keys.create, per esempio con il ruolo Project Editor. La stessa pagina indica un'alternativa per chi non ottiene i permessi: creare un progetto Google Cloud non associato all'organizzazione e generarsi le chiavi da solo (Using Gemini API keys). È una porta aperta verso progetti ombra fuori dal controllo IT, con le conseguenze descritte in cosa fare se un dipendente usa un'AI non autorizzata. Dal 28/05/2026 le nuove chiavi di AI Studio sono legate a un service account e dal 07/05/2026 le chiavi non limitate e inattive vengono bloccate (Using Gemini API keys). La pagina dei log non dice chi nel progetto può leggerli (Logs and datasets).
Anthropic Console. I ruoli sono quattro: User (solo playground), Developer (chiavi API, costi e utilizzo), Billing (fatturazione) e Admin (utenti e ruoli). Gli Admin dell'organizzazione sono automaticamente amministratori di tutti gli spazi di lavoro (ruoli e permessi).
Claude Enterprise unificato. Per chi dà Claude ai dipendenti, la pagina di Anthropic del 23/10/2026 descrive modelli consentiti per ruolo, tetti di spesa per gruppo e per persona, SSO, Compliance API, uscita di rete spenta di default e nessun addestramento di default. Chi usa lo ZDR per Claude Code, la configurazione HIPAA o le chiavi gestite dal cliente resta sulla configurazione attuale. La pagina non parla di registri di audit: conviene chiederlo. Per il confronto tra abbonamenti e API c'è la pagina sui modelli di frontiera in azienda.
Tre abitudini semplici aiutano: un responsabile interno per ogni fornitore, una revisione periodica di ruoli e chiavi, una separazione netta tra progetti di prova e progetti con dati reali.
Cosa resta fuori dal controllo delle impostazioni del fornitore?
Diverse cose non dipendono da un interruttore nella console: i difetti dell'infrastruttura condivisa, le conservazioni per abuso o per obblighi di legge, i sub-responsabili e gli obblighi del titolare.
Il caso più recente riguarda Cloudflare: con il modello GLM-5.3, dal 27 agosto al 9 settembre 2026, un problema di esposizione della cache KV ha interessato 155 risposte, su prompt oltre i 681.280 token, senza prove di sfruttamento deliberato (Cloudflare). Il difetto stava nel software di inferenza del fornitore, fuori da ciò che il cliente configura. L'analisi completa è in isolamento dei dati nelle API AI.
Poi c'è il contratto. Secondo il Parere EDPB 22/2024, adottato il 7 ottobre 2024, il titolare deve avere a disposizione l'identità di responsabili e sub-responsabili, verificarne le garanzie a prescindere dal livello di rischio e decidere lui sui sub-responsabili. Impostazioni e contratto vanno quindi letti insieme: DPA, elenco dei sub-responsabili, regione e conservazione. Su ruoli e valutazioni d'impatto rimando a intelligenza artificiale e GDPR.
Quando le API vanno bene con le giuste impostazioni, e quando conviene tenere i dati in azienda?
In molti casi le API ben configurate sono la scelta più sensata: prototipi, testi pubblici o commerciali, picchi di lavoro, dati pseudonimizzati, compiti in cui i modelli di frontiera fanno chiaramente meglio. La configurazione minima è: livello a pagamento, logging spento o finestra breve, regione scelta dove possibile, ruoli limitati.
L'AI in locale merita una valutazione in altri casi:
- dati che per contratto o per segreto professionale non devono uscire dall'azienda;
- documenti interni da interrogare con permessi e citazioni, come nel cervello aziendale;
- la necessità di evitare le conservazioni presso il fornitore descritte nelle sezioni precedenti;
- un fornitore scelto che non offre l'elaborazione in UE.
In questi casi conviene valutare l'AI on-premise. Spesso la risposta è mista: un modello di frontiera per i passaggi che non toccano dati riservati, un modello open-weight in locale per il resto. È il lavoro che faccio nella consulenza per i processi aziendali. Anche in locale, però, servono accessi, registri e policy d'uso: il problema cambia forma, non sparisce.
Da dove partire per verificare le impostazioni privacy delle API già in uso?
Il primo passo è un censimento di progetti, spazi di lavoro e chiavi attivi presso OpenAI, Google e Anthropic, compresi quelli creati fuori dall'organizzazione, che la documentazione Gemini rende possibili.
Poi, fornitore per fornitore:
- Gemini: per ogni progetto creato dal 26/10/2026, verificare
storee logging (changelog), ridurre la finestra di conservazione (Logs and datasets) e controllare i dataset condivisi (Data logging). - OpenAI: verificare la regione del progetto e gli endpoint esclusi dallo ZDR; se serve lo ZDR, farne richiesta formale (Your data).
- Anthropic: controllare la geografia dei workspace e i ruoli in Console (Data residency, ruoli).
- Documenti interni: allineare registro dei trattamenti e DPA, aggiornare la policy interna e formare chi usa le chiavi.
Se vuoi fare questa verifica con qualcuno che la imposti progetto per progetto, puoi chiedere una valutazione. Se emerge che alcuni flussi devono restare in azienda, server e software si possono fornire già configurati. Se invece le API, ben impostate, bastano, te lo dico.
Domande frequenti
Le impostazioni delle API valgono anche per gli abbonamenti ChatGPT o Claude dati ai dipendenti?
No. API e app per i dipendenti sono prodotti diversi, con console, contratti e impostazioni separati. Claude Enterprise, per esempio, ha regole sue: modelli consentiti per ruolo, tetti di spesa per gruppo e per persona, SSO e Compliance API. Ogni prodotto va verificato per conto suo.
Se uso Claude tramite Amazon Bedrock o Google Cloud, chi è il responsabile del trattamento?
Secondo la documentazione di Anthropic, su Bedrock e su Google Cloud gestito da Google il responsabile del trattamento è il provider cloud, non Anthropic. Contratto, sub-responsabili e regione vanno quindi verificati con quel provider, e la regione di elaborazione dipende dall'endpoint scelto.
I PDF inviati alle API di Gemini finiscono nei log?
Secondo la pagina Logs and datasets di Google, le richieste che contengono PDF, video o GIF non vengono salvate nei log. Restano però le regole dei termini del servizio, che prevedono una conservazione per un periodo limitato per individuare abusi e rispettare obblighi di legge, senza indicare quanti giorni.
Lo zero data retention si può attivare da soli dalla console?
No. OpenAI lo concede solo con approvazione preventiva, e comunque alcuni endpoint come Files, Vector Stores e Batches ne restano esclusi. Anthropic lo prevede solo su accordo, e per alcuni modelli chiede comunque una conservazione di 30 giorni. Va chiesto al fornitore e messo per iscritto nel contratto.
Ogni quanto conviene ricontrollare le impostazioni privacy delle API?
Almeno a ogni nuovo progetto e quando il fornitore pubblica una novità nelle note di rilascio: il cambio di Gemini del 26 ottobre 2026, per esempio, vale solo per i progetti nuovi. Una revisione periodica di ruoli, chiavi e impostazioni, per esempio ogni tre mesi, è un'abitudine ragionevole.
Chi scrive
Lilium AI
AI nei processi aziendali: in locale per i dati sensibili, con i modelli di frontiera per il resto
Da leggere dopo
Isolamento dei dati nelle API AI: le informazioni della tua azienda possono finire nelle risposte di altri clienti?
Su Workers AI di Cloudflare, per due settimane, 155 risposte hanno restituito dati di altri clienti. Vediamo come si isolano i clienti su una GPU condivisa, cosa promettono i fornitori, cosa dice il GDPR e quanto costa ridurre la condivisione.
Privacy, GDPR e sovranità dei dati11 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min
Intelligenza artificiale e GDPR: quando scegliere un modello AI on-premise?
Il GDPR non vieta l'AI in cloud e non premia automaticamente quella in casa. Una guida agli obblighi reali (ruoli, DPIA, sicurezza, trasferimenti, AI Act) e ai criteri per capire quando l'on-premise riduce davvero il rischio.
Privacy, GDPR e sovranità dei dati10 min