Monitoraggio dei costi AI: come vedere quanto spende ogni persona, reparto e processo
Vedere quanto spende in AI ogni persona, reparto o processo dipende da come si organizzano workspace, chiavi ed etichette, e da cosa permette ogni fornitore. Confronto tra Anthropic, OpenAI e Google, con i limiti dei tetti di spesa.
 Giulio PessioneCosti e TCO12 min
Pubblicato il
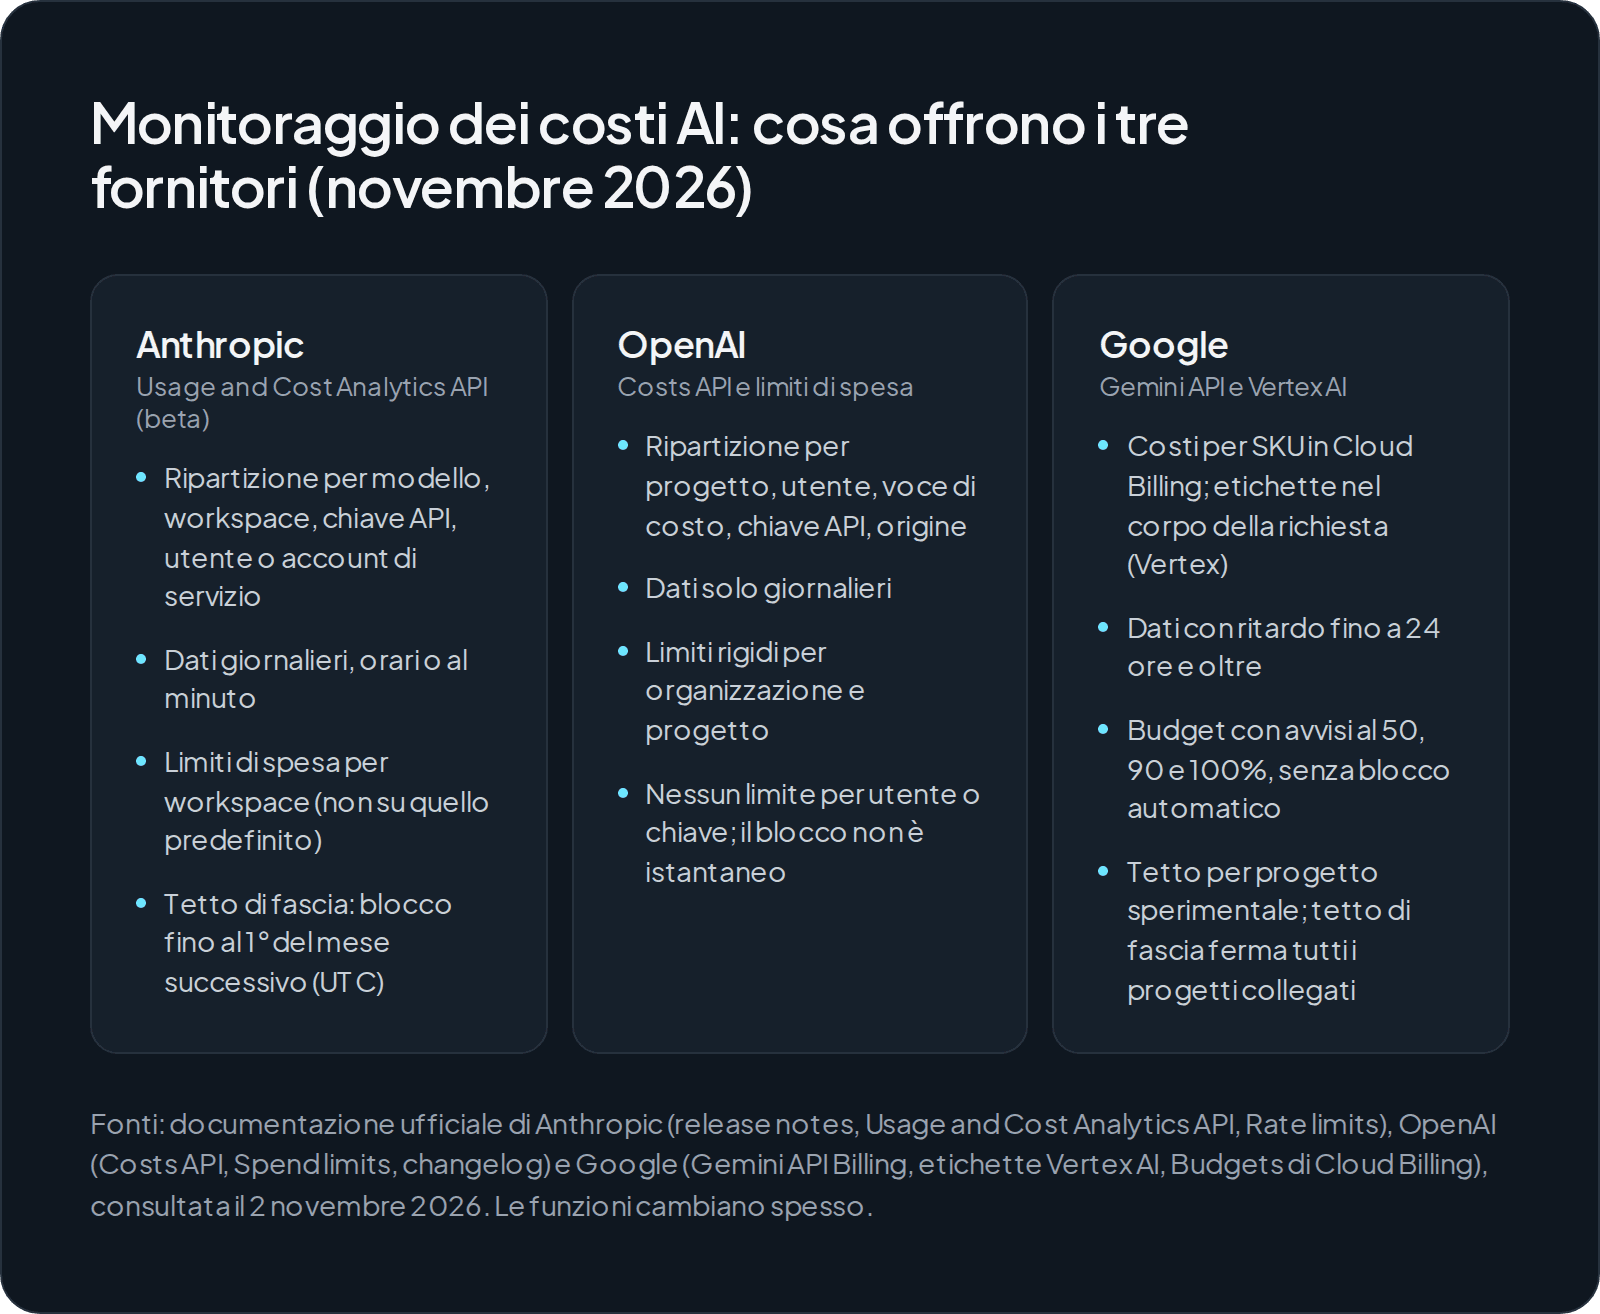
Il monitoraggio costi AI serve a sapere chi spende, in quale processo e con quale modello, non solo quanto arriva in fattura. Tra i tre grandi fornitori, oggi Anthropic offre il dettaglio più fine: divide la spesa per utente, chiave API e workspace, con dati fino al minuto, attraverso un'API ancora in beta. OpenAI divide per progetto, utente e chiave, ma solo per giorno. Google si appoggia a progetti, SKU ed etichette, con ritardi fino a 24 ore. Con tutti e tre, però, il dettaglio arriva solo se workspace, chiavi ed etichette sono organizzati prima di partire.
Cosa significa monitoraggio costi AI, e perché la fattura del fornitore non basta?
La fattura dice quanto si è speso in totale. Il monitoraggio dei costi AI dice chi ha speso, in quale processo e con quale modello. Serve a decidere dove intervenire.
Con l'AI i costi crescono con l'uso e con il numero di persone, e due richieste simili possono costare in modo molto diverso. Ecco alcuni esempi dal listino di Anthropic, consultato il 2 novembre 2026. I prezzi cambiano e vanno ricontrollati.
- Modalità fast. Opus 5.5 costa 4 $ per milione di token in ingresso e 20 $ in uscita. In modalità fast costa 8 $ e 40 $ (Pricing).
- Elaborazione solo negli Stati Uniti. Con
inference_geo: "us"si applica un moltiplicatore di 1,1 (Pricing). - Strumenti e agenti. La ricerca web costa 10 $ ogni 1.000 ricerche. Managed Agents costa 0,08 $ per ora di sessione, oltre ai token (Pricing).
- Scelta del modello. Haiku 5.5, con prompt fino a 100.000 token, costa 0,10 $ in ingresso e 0,50 $ in uscita: un quarantesimo di Opus 5.5 (Pricing).
Anthropic dichiara anche che i modelli Claude dalla 4.7 in poi producono circa il 30% di token in più per lo stesso testo (Pricing). Cambiare modello può quindi far salire il conto anche se il prezzo per token resta uguale.
Il monitoraggio deve rispondere a tre domande:
- chi ha consumato: una persona o un account di servizio;
- dove: in quale reparto o processo;
- con cosa: quale modello, con quali opzioni e strumenti.
Il quadro generale su abbonamenti, API e contratti è nella pagina sui modelli di frontiera in azienda.
Quanto dettaglio danno oggi Anthropic, OpenAI e Google sui costi?
Oggi Anthropic è il più dettagliato dei tre. OpenAI ripartisce i costi per progetto, utente e chiave, ma solo giorno per giorno. Google ragiona per progetto, SKU ed etichette.
Anthropic. Il 29 ottobre 2026 è uscita in beta la Usage and Cost Analytics API. Gli endpoint /v1/organizations/analytics/usage e /v1/organizations/analytics/cost valgono per Claude Console e Claude Enterprise. Si possono filtrare e raggruppare per modello, workspace, chiave API e utente o account di servizio (release notes). I dati si suddividono per giorno, ora o minuto, con i costi in dollari (documentazione dell'API). Le vecchie Usage and Cost API diventano legacy, ma restano supportate (release notes).
L'API è in beta e ho consultato solo una parte della documentazione. Nell'esempio di risposta compaiono anche agent_id, session_id, rbac_group_id e claude_tag_*. Fanno pensare a una ripartizione per agente, sessione e gruppo di permessi. Però vengono da un esempio, non da una tabella ufficiale dei parametri, e vanno verificate prima di costruirci sopra un report.
OpenAI. La Costs API (GET /organization/costs) richiede una chiave admin e accetta solo intervalli giornalieri (bucket_width = 1d). Raggruppa per project_id, user_id, line_item, api_key_id e api_source. Dal 4 agosto 2026 anche le dashboard Usage e Costs permettono di filtrare per chiave API (changelog).
Google. Sulla Gemini API il consumo si vede in AI Studio e i costi in Cloud Billing, raggruppati per SKU. I grafici di spesa possono richiedere fino a 24 ore (Gemini API Billing). Le chiavi ereditano limiti e fatturazione del progetto, e la pagina non documenta una ripartizione dei costi per chiave. Su Vertex AI si aggiungono le etichette.
| Anthropic | OpenAI | ||
|---|---|---|---|
| Strumento | Usage and Cost Analytics API, in beta (fonte) | Costs API e dashboard (fonte) | AI Studio e Cloud Billing Reports (fonte) |
| Ripartizione | Modello, workspace, chiave, utente o account di servizio | Progetto, utente, voce di costo, chiave, origine | Progetto e SKU; etichette su Vertex AI (fonte) |
| Dettaglio temporale | Giorno, ora o minuto (fonte) | Solo giorno | Report di fatturazione |
| Chi accede | Admin API key o OAuth org:admin; su Enterprise chiave read:analytics (fonte) | Chiave admin | Non indicato nelle pagine consultate |
| Ritardo dei dati | Non indicato nelle parti consultate | Non indicato | Fino a 24 ore (Gemini API); su Vertex di solito entro un giorno, a volte di più (fonte) |
Come si attribuisce la spesa a un reparto o a un processo, e non solo a una persona?
L'attribuzione va progettata prima di partire. Servono tre cose: un contenitore per ogni processo (il workspace su Anthropic, il progetto su OpenAI e Google), chiavi API separate per ogni flusso e, dove il fornitore lo consente, etichette nelle richieste. Ricostruire tutto da una fattura unica è molto difficile.
Su Anthropic ogni risposta dell'API contiene l'intestazione anthropic-workspace-id (Rate limits). Salvandola nei registri interni si collegano i costi del fornitore ai log delle proprie applicazioni.
Su Vertex AI le etichette vanno nel campo labels del corpo della richiesta, e da lì arrivano a Cloud Billing (documentazione Vertex AI). La stessa pagina segnala tre trappole:
- le etichette inserite negli header non arrivano a Cloud Billing;
- con Provisioned Throughput vengono ignorate senza alcun avviso;
- i limiti sono stretti: al massimo 64 etichette per chiamata, chiavi e valori fino a 63 caratteri e al massimo 1.000 valori unici per chiave in tutta la vita dell'account di fatturazione.
Per questo le etichette vanno usate per reparto, processo e ambiente, non per singolo cliente o ticket. Il dettaglio per singola pratica resta nei registri interni. Agenti e automazioni dovrebbero usare account di servizio dedicati. Altrimenti il costo di un agente notturno finisce sul nome di chi l'ha configurato. Ne parlo anche nella guida su come creare un agente AI per l'azienda.
Tetti di spesa e avvisi: cosa succede davvero quando si raggiunge il limite?
Gli avvisi informano, i tetti rigidi bloccano. Il blocco non è sempre istantaneo, e alcuni tetti fermano tutto fino al mese successivo.
Anthropic. Ogni fascia ha un tetto mensile: 500 $ per Start, 1.000 $ per Build e 200.000 $ per Scale. La fascia Custom non ha un tetto fisso (Rate limits). Quando si raggiunge il tetto, l'uso si ferma fino alle 00:00 UTC del primo giorno del mese successivo. Le richieste ricevono un errore HTTP 429 con codice enforced_spend_limit_reached e senza retry-after (Rate limits). Il limite impostato dall'azienda, invece, restituisce un HTTP 400. Si può fissare per ogni workspace tranne quello predefinito (Rate limits): un motivo in più per non lasciarci i processi.
OpenAI. Dal 22 luglio 2026 esistono limiti rigidi per organizzazione e per progetto, ma non per singolo utente o singola chiave (changelog). Il blocco restituisce un errore 429 (organization_spend_limit_exceeded o project_spend_limit_exceeded). Non è istantaneo: la spesa registrata può superare di poco il limite (Spend limits). La pagina non indica il fuso orario del ciclo mensile. Dal 26 maggio 2026 l'Admin API gestisce anche gli avvisi di spesa e l'elenco dei modelli consentiti (changelog).
Google. Sulla Gemini API il tetto per progetto è descritto come "sperimentale e di portata limitata", con sforamenti possibili di circa 10 minuti. Ci sono poi i tetti di fascia sull'account di fatturazione: 250 $ al mese per Tier 1, 2.000 $ per Tier 2, da 20.000 a 100.000 $ per Tier 3. Quando si raggiungono, si fermano tutti i progetti collegati fino al mese successivo (Gemini API Billing). I budget di Cloud Billing hanno soglie predefinite al 50%, 90% e 100%. Un budget che invia solo avvisi non blocca la spesa. Con le notifiche Pub/Sub si possono automatizzare azioni, per esempio disattivare la fatturazione, ma così si ferma l'intero progetto (Budgets).
La conseguenza è concreta. Se un esperimento condivide l'organizzazione o l'account di fatturazione con le risposte ai clienti, e raggiunge il tetto a metà mese, ferma anche quelle. I flussi critici vanno quindi separati da quelli sperimentali. Le automazioni devono riconoscere questi errori, avvisare una persona e, se previsto, passare a un modello di riserva. Listini e rincari di Gemini sono nell'articolo sui prezzi delle API di Gemini.
Con gli abbonamenti per utente come si controlla chi consuma cosa?
Nei piani aziendali di Claude la dashboard degli amministratori mostra uso e costo per gruppo e per utente. La leva più diretta è scegliere quali modelli rendere disponibili e a chi. Secondo l'articolo di Anthropic del 2 luglio 2026, la dashboard offre:
- uso e costo per gruppo e per utente, filtrabili per gruppi SCIM, e il costo per commit di Claude Code;
- avvisi agli amministratori al 75% e al 90% del limite dell'organizzazione e notifiche agli utenti al 75% e al 95%;
- la scelta dei modelli disponibili per ruolo e del modello predefinito.
Con differenze di listino come quella tra Opus 5.5 e Haiku 5.5, è ragionevole aspettarsi che il modello predefinito pesi sulla spesa o sui limiti d'uso. Quanto, va verificato sul proprio piano. Su Claude Enterprise si può usare anche la nuova API, con una chiave read:analytics creata dal primary owner (documentazione). Per gli altri fornitori le funzioni vanno verificate nelle rispettive console.
L'Admin API non è disponibile per gli account individuali (documentazione). Chi lavora con un account personale resta quindi fuori sia dal monitoraggio dei costi sia dai controlli sui dati. Cosa fare quando succede è spiegato nell'articolo sui dati caricati su un'AI non autorizzata.
Quali dati espone il monitoraggio stesso, e chi dovrebbe poterli vedere?
I report per persona sono dati che riguardano i dipendenti. Chi ha le chiavi di amministrazione vede l'attività di tutta l'organizzazione. Accessi e scopi vanno quindi decisi prima di attivare i report.
Su Console servono una Admin API key o un token OAuth con scope org:admin. Anthropic consiglia una chiave dedicata, conservata in un gestore di segreti e ruotata, oppure la Workload Identity Federation (documentazione). La stessa pagina segnala un limite di Claude Platform on AWS: qui user_profile_id, i tag claude_tag_* e le dimensioni dei Managed Agents sono vuoti, e ogni richiesta copre una sola regione. Si perde così proprio il dettaglio per persona e per agente. Sulla versione su Google Cloud gestita da Anthropic, invece, l'API è disponibile con i permessi IAM usageAnalytics.list e costAnalytics.list.
Il monitoraggio per persona tocca anche il rapporto di lavoro. Prima di attivarlo conviene coinvolgere il DPO e il consulente del lavoro. Nella policy va scritto chi vede i report e per quali scopi. Usarli per valutare i singoli senza basi chiare e senza averlo comunicato espone a rischi da valutare con chi segue questi temi. È più prudente partire dai report per processo e reparto. Le altre impostazioni da controllare sono nella guida sulle impostazioni privacy delle API AI. Il quadro sugli obblighi è nella pagina su AI e GDPR.
Il monitoraggio costi AI cambia se una parte dei processi gira in locale?
In locale il costo per token scompare e restano i costi fissi. Il monitoraggio si sposta su quanto è usata la macchina e su chi la usa. I registri per persona e per processo servono comunque.
Il monitoraggio delle API serve anche a decidere cosa portare in locale. Un buon candidato per una valutazione è un processo stabile, ad alto volume, con dati sensibili e un peso rilevante in fattura. Un processo con volumi bassi o molto variabili, di solito, conviene lasciarlo sulle API.
Le voci di costo del locale sono nella pagina sui costi dell'AI in locale. I criteri di scelta sono nell'articolo su quando conviene un server AI invece delle API. Spesso la soluzione più sensata è ibrida: modelli di frontiera via API per i passaggi difficili e un modello in locale per quelli ripetitivi. In quel caso serve un'unica vista dei costi, che metta insieme le fatture dei fornitori e l'utilizzo della macchina interna.
Da dove partire per vedere i costi AI per persona, reparto e processo?
- Inventario. Elenca fornitori, piani, chiavi API e account personali in uso, compresi quelli non autorizzati.
- Struttura. Un workspace o un progetto per ogni processo, nessun processo sul workspace predefinito e account di servizio per agenti e automazioni.
- Estrazione. Estrai i dati ogni giorno via API (ogni ora, dove possibile) verso un foglio o un cruscotto interno. Su Google i costi etichettati possono arrivare dopo più di 24 ore.
- Soglie. Metti avvisi ovunque e tetti rigidi solo sui flussi non critici, con un responsabile per ogni soglia.
- Regole. Decidi chi vede i report per persona e per quali scopi, scrivilo nella policy e forma chi usa l'AI.
- Scadenze. La modalità fast di Opus 4.8 sarà rimossa il 30 novembre 2026. Dopo quella data le richieste con
speed: "fast"restituiranno errore. Anthropic indica la migrazione verso Opus 5.5 (release notes).
Nel mio lavoro aiuto le aziende a impostare questa struttura e a leggere i numeri per processo, con i modelli di frontiera, con quelli in locale o con entrambi. Il metodo è descritto nella pagina sulla consulenza AI per i processi aziendali. Se dai dati risulta che un processo conviene in locale, server e software si possono fornire già configurati. Per cominciare puoi richiedere una valutazione.
Domande frequenti
Le dashboard dei fornitori mostrano i costi in tempo reale?
No, non sempre. Su Gemini API i grafici di spesa possono richiedere fino a 24 ore. Su Vertex AI i costi etichettati di solito arrivano entro un giorno, ma a volte anche dopo. L'API dei costi di OpenAI raggruppa i dati solo per giorno. La nuova API di Anthropic, in beta, arriva fino al dettaglio al minuto. Per gli avvisi rapidi conviene contare anche i token nei propri registri interni.
Si può mettere un limite di spesa a ogni singolo dipendente?
Dipende dal fornitore e dal piano. Sulle API di OpenAI i limiti valgono solo per organizzazione e progetto, non per utente o chiave. Anthropic permette limiti per workspace, tranne quello predefinito. Nei piani aziendali di Claude gli utenti ricevono notifiche al 75% e al 95% del limite. Per un limite per persona via API, di solito si dà a ciascuno un proprio progetto o workspace, oppure si passa da un sistema intermedio interno.
Cosa succede a un processo automatico quando si raggiunge il tetto di spesa del fornitore?
Le richieste vengono rifiutate con un errore. Su Anthropic il tetto di fascia blocca fino all'inizio del mese successivo (ore 00:00 UTC) senza indicare quando riprovare. Su Gemini API il tetto di fascia ferma tutti i progetti collegati all'account di fatturazione. L'automazione deve riconoscere questi errori, avvisare una persona e, se previsto, passare a un modello di riserva.
Serve un software esterno per il monitoraggio dei costi AI?
Non per forza. Con poche chiavi e un solo fornitore possono bastare le dashboard native e un'estrazione periodica via API in un foglio di calcolo. Uno strumento dedicato, o un sistema intermedio interno, diventa utile con più fornitori, molti processi o modelli in locale da mettere nella stessa vista.
Chi scrive
AI engineer
Sono un AI engineer: progetto e realizzo sistemi di intelligenza artificiale per le aziende, soprattutto nei processi commerciali come vendite, assistenza clienti, qualificazione dei contatti e automazione. Seguo la parte tecnica dall'inizio alla fine: configuro i server per l'AI in locale, sviluppo assistenti sui documenti e agenti, e li integro con i programmi già in uso in azienda.
Da leggere dopo
Quando conviene acquistare un server AI invece di pagare le API?
Comprare un server AI conviene quando i volumi sono alti e stabili, i dati sono sensibili e c'è chi lo gestisce. Partendo dai rincari dei listini e da un preprint sul punto di pareggio vediamo come fare i conti, e quando le API restano la scelta migliore.
Costi e TCO10 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min
Come creare un agente AI per l'azienda: dal processo da ottimizzare al primo flusso in produzione
Per creare un agente AI si parte dal processo, non dallo strumento. Vediamo come scegliere il primo flusso, quando basta un workflow, quale modello usare per ogni passaggio, quali dati escono dall'azienda e quali controlli servono prima della produzione.
AI nei processi aziendali10 min