Vendor lock-in nell'AI: cosa costa quando il fornitore ritira o cambia il modello che usi
I fornitori di AI ritirano i modelli con preavvisi da 45 giorni a 6 mesi, e i sostituti possono costare molto di più. Come stimare il costo del vendor lock-in AI e come ridurlo con modelli open-weight e un'architettura che non dipenda da un solo fornitore.
Pubblicato il
Il vendor lock-in AI è la dipendenza da un modello e da un fornitore che decidono da soli quando spegnerlo e quanto far pagare il sostituto. Per i modelli stabili i preavvisi pubblicati vanno da 45 giorni a 6 mesi (Google Cloud, OpenAI). Il sostituto indicato può costare di più: per gpt-5-mini il prezzo di output passa da 2 $ a 12 $ per milione di token (OpenAI, Pricing). Il rischio si riduce con un inventario dei modelli, test aziendali indipendenti e, dove ha senso, modelli open-weight gestiti in proprio.
Cos'è il vendor lock-in AI, e perché il ritiro di un modello lo rende concreto?
Il vendor lock-in AI è la dipendenza da un modello di cui non controlli né il calendario né il listino. Finché il modello funziona, la dipendenza resta invisibile. Quando il fornitore annuncia il ritiro, diventa una scadenza con un costo.
Anthropic descrive quattro stati: Active, Legacy, Deprecated e Retired. Dopo l'ultimo, "Requests to models past the retirement date will fail" (Anthropic, Model deprecations). Un'applicazione che chiama un modello ritirato quindi non peggiora: smette di funzionare.
Alcuni casi recenti:
- il 23/10/2026 OpenAI ha spento, tra gli altri, gpt-3.5-turbo, gpt-4, gpt-4-turbo, o1, o3-mini e gpt-image-1 (OpenAI, Deprecations);
- Google ha ritirato Gemini 2.5 Pro, Flash e Flash-Lite su Vertex AI il 20/10/2026 (Google Cloud, Model versions and lifecycle);
- Anthropic ha spento Claude Opus 4.1 il 5/8/2026, due mesi dopo l'annuncio del 5/6 (Anthropic, Model deprecations).
Il lock-in riguarda anche gli strumenti costruiti attorno al modello. Il 30/11/2026 OpenAI chiude la dashboard e le API degli Evals, l'API v1/prompts e Agent Builder (OpenAI, Deprecations). Chi ci aveva costruito test, prompt o flussi deve rifarli altrove.
Con quanto preavviso i fornitori ritirano i modelli?
Secondo le politiche pubblicate, il preavviso va da 45 giorni a 6 mesi per i modelli stabili. Per i modelli in anteprima può essere molto più breve (fonti nella tabella).
| Fornitore | Modelli stabili | Altri casi | Note | Fonte |
|---|---|---|---|---|
| OpenAI | Almeno 6 mesi (modelli generalmente disponibili) | Almeno 3 mesi per le varianti specializzate; per i preview tempi "such as 2 weeks" | Ritiro anticipabile per sicurezza o conformità, con "as much notice as reasonably possible" | Deprecations |
| Anthropic | Almeno 60 giorni per i modelli rilasciati pubblicamente | — | Avviso via email e documentazione | Model deprecations |
| Google Vertex AI | Disponibili almeno 12 mesi dal rilascio, preavviso di almeno 45 giorni | — | Le date possono essere prorogate, non anticipate | Model versions and lifecycle |
Google mette per iscritto un impegno utile per chi pianifica: le date di ritiro "won't be moved to an earlier date than what is listed" (Google Cloud).
Nella pratica i tempi possono essere stretti. Sulla piattaforma di Mistral, GLM 5.2 è stato deprecato il 29/9 con ritiro il 31/10/2026, circa 32 giorni, e sostituito da GLM 5.3 allo stesso prezzo (Mistral AI, Changelog). Gemini 3.6 Flash, rilasciato il 21/7/2026, ha il ritiro fissato al 19/11/2026, meno di quattro mesi dopo (Google Cloud). Prima di costruire un processo su un modello conviene controllare in che stato è e quale data di ritiro ha.
A volte la data stessa è poco chiara. Per claude-haiku-4-5 la pagina indica un ritiro "Not sooner than October 15, 2026", data già passata, mentre il modello risulta ancora Active (Anthropic). Serve un monitoraggio attivo, non un controllo una volta l'anno.
Quanto costa passare al modello sostitutivo indicato dal fornitore?
Dipende dal modello: alcuni sostituti costano molto di più, altri molto di meno. Il conto va rifatto a ogni ritiro.
La tabella unisce i prezzi standard della pagina prezzi di OpenAI e i sostituti indicati nella pagina delle deprecazioni, consultate il 27/10/2026 e prive di data di aggiornamento. I prezzi cambiano.
| Modello in uscita | Input / output (USD per milione di token) | Sostituto indicato | Input / output del sostituto | Data di spegnimento |
|---|---|---|---|---|
| gpt-5-mini | 0,25 / 2,00 | gpt-5.6-terra | 2,00 / 12,00 | 11/12/2026 |
| gpt-5-nano | 0,05 / 0,40 | gpt-5.6-luna | 0,20 / 1,20 | 11/12/2026 |
| o4-mini | 1,10 / 4,40 | gpt-5.6-terra | 2,00 / 12,00 | 23/10/2026 (già spento) |
| gpt-5 | 1,25 / 10,00 | gpt-5.6-sol | 4,00 / 20,00 (con prezzo promozionale, vedi sotto) | 11/12/2026 |
| o3 | 2,00 / 8,00 | gpt-5.6-sol | 4,00 / 20,00 (con prezzo promozionale, vedi sotto) | 11/12/2026 |
| gpt-4o (snapshot 2024-08-06 e 2024-11-20) | 2,50 / 10,00 | gpt-6-luna | 0,10 / 0,50 | 14/1/2027 |
| gpt-4.1 | 2,00 / 8,00 | gpt-6-luna | 0,10 / 0,50 | 14/1/2027 |
Per gpt-5-mini l'output costa sei volte tanto e l'input otto volte tanto (OpenAI, Pricing). Per gpt-4o e gpt-4.1 vale il contrario. Il prezzo però è solo una parte della scelta: un modello più economico che sbaglia più spesso sui tuoi casi d'uso non fa risparmiare.
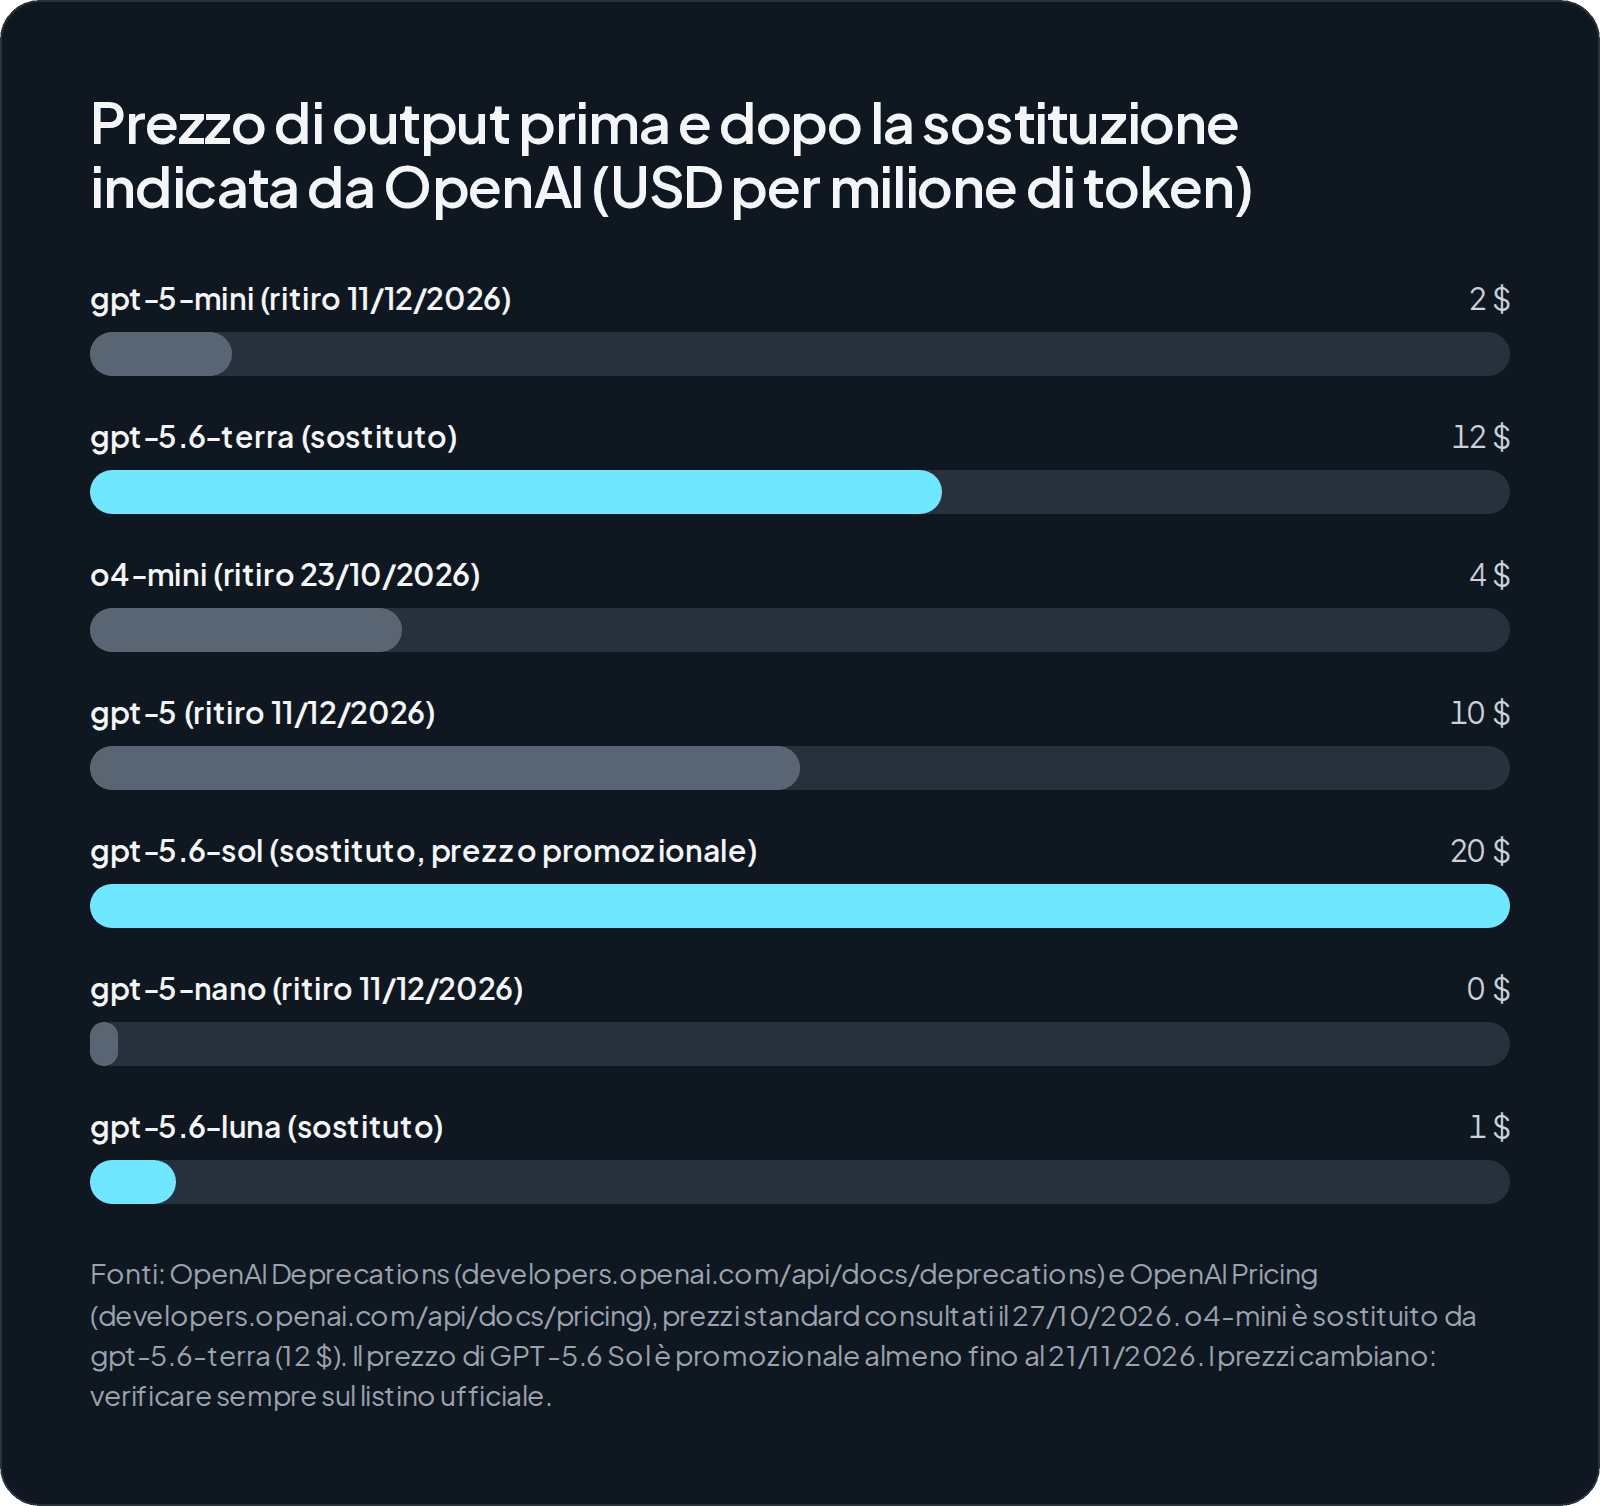
Attenzione ai prezzi promozionali. Per GPT-5.6 Sol il prezzo promozionale vale "at least through November 21, 2026" (OpenAI, Pricing). Mistral ha lanciato Large 4 il 6/10 con uno sconto del 50% per due settimane (Mistral AI, Changelog). Un budget costruito su una promozione rischia di saltare dopo poche settimane.
Per mettere queste cifre accanto ai costi di un'infrastruttura interna trovi un metodo nella pagina sui costi dell'AI in locale e nell'articolo su quanto costa un'AI privata in azienda.
Quali costi nascosti porta un cambio di modello, oltre al prezzo a token?
I costi maggiori spesso stanno nel lavoro: prompt da riscrivere, test da ripetere, personalizzazioni perse, strumenti da sostituire.
Fine-tuning. I modelli fine-tuned si spengono insieme al loro modello base (OpenAI, Deprecations), e OpenAI sta "winding down the fine-tuning platform" (OpenAI, Pricing). Dal 6/1/2027 nemmeno i clienti attivi potranno creare nuovi job (OpenAI, Deprecations). Chi ha un modello personalizzato su gpt-4.1 o gpt-4o lo vedrà spegnersi il 14/1/2027, senza poterne addestrare uno nuovo sulla stessa piattaforma. L'addestramento costava 25 $ per milione di token su gpt-4.1 e gpt-4o (OpenAI, Pricing). All'azienda resta il dataset, se lo ha conservato.
Cambi nelle API. Anthropic rimuove i parametri temperature, top_p e top_k dalla versione API 2026-10-21: chi li passa riceve un errore 400 (Anthropic). Un'applicazione che regolava le risposte con questi parametri va rivista.
Strumenti di valutazione. Gli Evals di OpenAI sono di sola lettura dal 31/10 (OpenAI, Deprecations): chi teneva lì i propri test deve migrarli proprio mentre valuta il modello sostitutivo.
Cosa succede ai dati aziendali quando si cambia modello o fornitore?
Un cambio di modello può spostare i dati verso un servizio con condizioni, tempi di conservazione e giurisdizione diversi. Le verifiche fatte all'inizio del progetto vanno ripetute.
Le condizioni cambiano anche presso lo stesso fornitore. Sulla Gemini API i dati del livello gratuito sono usati "to improve our products", anche con Gemma 4 tramite l'API di Google; nel livello a pagamento no (Google, Gemini Developer API pricing). Se un sostituto viene provato con una chiave gratuita, l'esposizione dei dati cambia. E il changelog di Mistral non dice dove vengono elaborati i dati di Voxtral 3, in Public Preview dal 20/10 (Mistral AI, Changelog): senza questa informazione, a mio avviso, un modello non va usato con dati personali.
Se il sostituto arriva da un altro fornitore o da una piattaforma come Bedrock o Vertex, conviene rivedere con il legale o il DPO contratto, accordo sul trattamento dei dati e documentazione privacy. Può cambiare anche la giurisdizione, tema trattato nell'articolo sulla sovereign AI. Gli obblighi che restano all'azienda sono riassunti nella pagina su AI e GDPR.
Il Data Act europeo, applicabile dal 12/9/2025, obbliga i fornitori a rimuovere gli ostacoli al passaggio verso un altro fornitore e dal 12/1/2027 elimina i costi di passaggio, compresi quelli di trasferimento dei dati in uscita (Commissione europea, Data Act explained). Se si applichi a una specifica API di modelli va verificato con un legale: non è una tutela automatica.
I modelli open-weight riducono il vendor lock-in AI?
Sul fronte dei tempi sì: i pesi scaricati restano all'azienda, che decide quando aggiornare. Restano però i costi di hardware e gestione e la verifica delle licenze.
Un esempio è Gemma 4 di Google, nelle taglie E2B, E4B, 12B, 26B A4B (MoE) e 31B denso. Quantizzati in Q4_0, i soli pesi occupano circa 17,5 GB per il 31B e 6,7 GB per il 12B (Google, Gemma 4), a cui va aggiunta la memoria per il contesto.
Le licenze vanno lette una per una:
- Recursive Flint (40B MoE, circa 2,5B parametri attivi) è distribuito con licenza Apache 2.0 tramite Ollama, dalla versione 0.40.8 (Ollama, Releases);
- per Gemma 4 il link alla licenza punta a una pagina "apache_2", ma il testo della documentazione non lo conferma (Google, Gemma 4);
- per Mistral Large 4 si legge "Open weights are coming soon", senza licenza indicata (Mistral AI, Changelog).
I benchmark dei nuovi modelli sono dichiarati dal produttore, come il 74,2% di Flint su SWE-bench Verified (Ollama, Releases): un indizio da verificare sui propri casi.
Anche un fornitore solo API può conservare i pesi: Anthropic si impegna a farlo per "the lifetime of Anthropic as a company", ma lasciarli accessibili resta un'ipotesi in valutazione (Anthropic, Commitments on Model Deprecation and Preservation).
Per capire cosa serve a far girare un modello in casa, anche senza connessione, puoi leggere l'articolo sull'intelligenza artificiale offline e la pagina sull'AI on-premise.
Quando conviene comunque restare su un fornitore cloud?
Quando i volumi sono bassi, quando serve il modello più capace sul mercato o quando nessuno in azienda può seguire un'infrastruttura. In questi casi il lock-in non si evita: si gestisce.
Alcune migrazioni imposte fanno anche risparmiare. Chi usa gpt-4o-mini passa da 0,15 / 0,60 $ a 0,10 / 0,50 $ per milione di token con gpt-6-luna (OpenAI, Pricing, consultata il 27/10/2026). Se la qualità regge, il ritiro diventa un'occasione.
Per pochi utenti l'abbonamento può essere la strada più semplice. Claude Team Standard costa 20 $ a utente al mese con fatturazione annuale e 25 $ con quella mensile; Anthropic precisa che i prezzi possono cambiare (Claude, Pricing, consultata il 27/10/2026). Senza integrazioni proprie un ritiro pesa meno sul codice, ma può cambiare il comportamento dell'assistente, e i costi crescono con le persone.
Spesso la scelta più sensata è ibrida: modelli locali per i dati riservati e i processi stabili, cloud per i compiti occasionali che richiedono la massima capacità. Le opzioni per un assistente interno sono nella pagina sul ChatGPT aziendale privato.
Da dove partire per ridurre la dipendenza da un solo modello?
Si parte da un inventario e da poche regole tecniche che rendono il cambio di modello un'operazione ordinaria.
- Inventario dei modelli. Quali modelli e versioni usa ogni applicazione, con quale data di ritiro secondo le pagine ufficiali di OpenAI, Anthropic, Google Cloud e Mistral. Va aggiornato con regolarità e affidato a una persona precisa.
- Un livello di astrazione tra applicazioni e modelli: cambiare modello deve voler dire cambiare una configurazione, non riscrivere ogni integrazione.
- Un set di test aziendale, con domande reali e risposte attese, in uno strumento interno o open source che non possa chiudere per decisione del fornitore.
- Prompt, configurazioni e dataset di fine-tuning conservati in azienda, con versioni e storico.
- Un pilota con un modello open-weight su un processo stabile, per confrontare costi e qualità sui propri dati.
Se usi già le API di un fornitore e vuoi capire se spostare una parte dei processi su un modello gestito internamente, trovi il percorso nella pagina sulla migrazione dalle API. Se preferisci partire dal tuo caso, puoi chiedere una valutazione indipendente: ti aiuto a fare l'inventario e a capire dove il lock-in pesa davvero e dove no.
Domande frequenti
Usare un modello tramite Amazon Bedrock o Google Cloud protegge dai ritiri decisi dal produttore?
Non automaticamente. Anthropic precisa che Amazon Bedrock e Google Cloud fissano i propri calendari di ritiro, che possono essere diversi da quelli dell'API diretta. Bisogna controllare la pagina del ciclo di vita della piattaforma che si usa davvero, e non solo quella del produttore del modello.
Se Anthropic conserva i pesi dei modelli ritirati, posso continuare a usarli?
No, non per questo motivo. Nel documento del 4/11/2025 Anthropic si impegna a conservare i pesi dei modelli pubblici, ma non a lasciarli accessibili: mantenerli disponibili al pubblico è un'ipotesi ancora in valutazione. Dopo la data di ritiro le richieste API falliscono.
Un prezzo promozionale su un nuovo modello è una buona base per il budget?
Solo per un periodo limitato. OpenAI indica che il prezzo promozionale di GPT-5.6 Sol è garantito almeno fino al 21/11/2026, e Mistral ha lanciato Large 4 con uno sconto del 50% per due settimane. Per il budget conviene usare il prezzo di listino pieno e trattare la promozione come un risparmio temporaneo.
Con un modello open-weight installato in azienda non ci sono più aggiornamenti da gestire?
No. Gli aggiornamenti restano, ma è l'azienda a decidere quando farli. Bisogna comunque tenere aggiornati il software di inferenza, il sistema e le librerie, valutare i nuovi modelli e verificare la licenza di ciascuno. Il lavoro si sposta dal fornitore all'azienda, o a chi la assiste.
Cosa chiedere al fornitore prima di firmare per ridurre il rischio di lock-in?
Quali preavvisi minimi applica ai ritiri e se sono scritti nel contratto. Se le date pubblicate possono essere anticipate. Come si esportano dati, log e configurazioni. Quali costi di uscita sono previsti, tenendo presente che il Data Act elimina i costi di passaggio dal 12/1/2027 per i servizi a cui si applica.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Come integrare un'intelligenza artificiale privata con ERP, CRM e software aziendali
Collegare un'AI a ERP, CRM e gestionali: casi d'uso da cui partire, come funzionano connettori e Model Context Protocol, quanto costano le soluzioni dei fornitori e quali controlli servono per tenere i dati in azienda.
Integrazione con ERP, CRM e migrazione API9 min
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
Sovereign AI: cos'è la sovranità dell'intelligenza artificiale e perché interessa alle aziende europee
Sovereign AI non è solo uno slogan politico: per un'azienda significa sapere chi controlla dati, modelli e infrastruttura. Le iniziative europee, il nodo del CLOUD Act e i livelli di sovranità possibili, con i loro compromessi.
Privacy, GDPR e sovranità dei dati8 min