Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Pubblicato il
Al 27 ottobre 2026 i prezzi Gemini API sul livello a pagamento standard vanno da 0,25 a 2,00 $ per milione di token in input e da 1,50 a 10,00 $ in output, secondo la pagina prezzi ufficiale di Google. Sulla stessa pagina Google annuncia due rincari: dal 1° dicembre 2026 raddoppiano i prezzi di Gemini 4 Argon, dal 1° gennaio 2027 quelli di Gemini 3.8 Flash e 3.6 Flash. Con volumi moderati le API restano di solito la scelta più economica. Un modello open-weight in azienda può convenire quando i volumi sono alti e costanti o quando i dati non devono uscire.
Quali sono i prezzi Gemini API oggi, modello per modello?
Sul livello a pagamento standard si paga da 0,25 a 2,00 $ per milione di token in input e da 1,50 a 10,00 $ in output, a seconda del modello. Sono i valori della pagina prezzi della Gemini Developer API, consultata il 27/10/2026. Sono espressi in dollari e Google li può cambiare. Non li converto in euro, perché il cambio varia e non ho una fonte ufficiale da citare.
| Modello (livello standard) | Input | Output | Cache (lettura) | Archiviazione cache ($/ora) |
|---|---|---|---|---|
| Gemini 4 Argon | 2,00 | 10,00 | 0,10 (solo implicita) | non indicato |
| Gemini 3.8 Flash / 3.6 Flash | 0,75 | 3,75 | 0,075 | 0,50 |
| Gemini 3.5 Flash-Lite | 0,30 | 2,50 | 0,03 | 1,00 |
| Gemini 3.1 Flash-Lite | 0,25 (audio 0,50) | 1,50 | 0,025 | 1,00 |
Valori in USD per milione di token, dalla pagina prezzi di Google, consultata il 27/10/2026, prima dei rincari annunciati.
Un token è un frammento di testo, spesso una parte di parola. Ogni chiamata conta i token che invii (input) e quelli che il modello produce (output). Per il testo, il token in uscita costa da cinque a oltre otto volte quello in entrata, come si ricava dalla stessa tabella. Per questo, in risposte lunghe, riassunti estesi o documenti generati, l'output è di solito la voce che pesa di più sul conto.
Due dettagli contano nella scelta del modello. Gemini 4 Argon non è disponibile sul livello gratuito (fonte). Gemma 4 è gratuito sul livello gratuito ma risulta "Not available" su quello a pagamento (fonte). Su Gemma 4 torno più avanti, perché per un'azienda europea la cosa ha conseguenze pratiche.
Cosa cambiano i rincari di dicembre 2026 e gennaio 2027?
Per Argon e per i due Flash i prezzi per token raddoppiano. A parità di utilizzo, quindi, raddoppia anche la spesa in token per quei modelli. Per Flash-Lite e Gemma la pagina prezzi non annuncia rincari.
Le variazioni pubblicate da Google:
- Gemini 4 Argon, dal 1° dicembre 2026: input da 2 a 4 $, output da 10 a 20 $, cache da 0,10 a 0,20 $ per milione di token. Il costo di archiviazione della cache non è indicato.
- Gemini 3.8 Flash e 3.6 Flash, dal 1° gennaio 2027: input da 0,75 a 1,50 $, output da 3,75 a 7,50 $, cache da 0,075 a 0,15 $, archiviazione della cache da 0,50 a 1,00 $ all'ora.
C'è poi il ciclo di vita dei modelli. Secondo la documentazione di Google Cloud, Gemini 3.6 Flash viene ritirato il 19/11/2026 e il sostituto indicato è gemini-3.8-flash. Chi oggi usa 3.6 Flash deve quindi migrare entro quella data verso un modello che da gennaio raddoppia di prezzo. Nella stessa pagina il ritiro di 3.7 Flash è fissato al 28/1/2027.
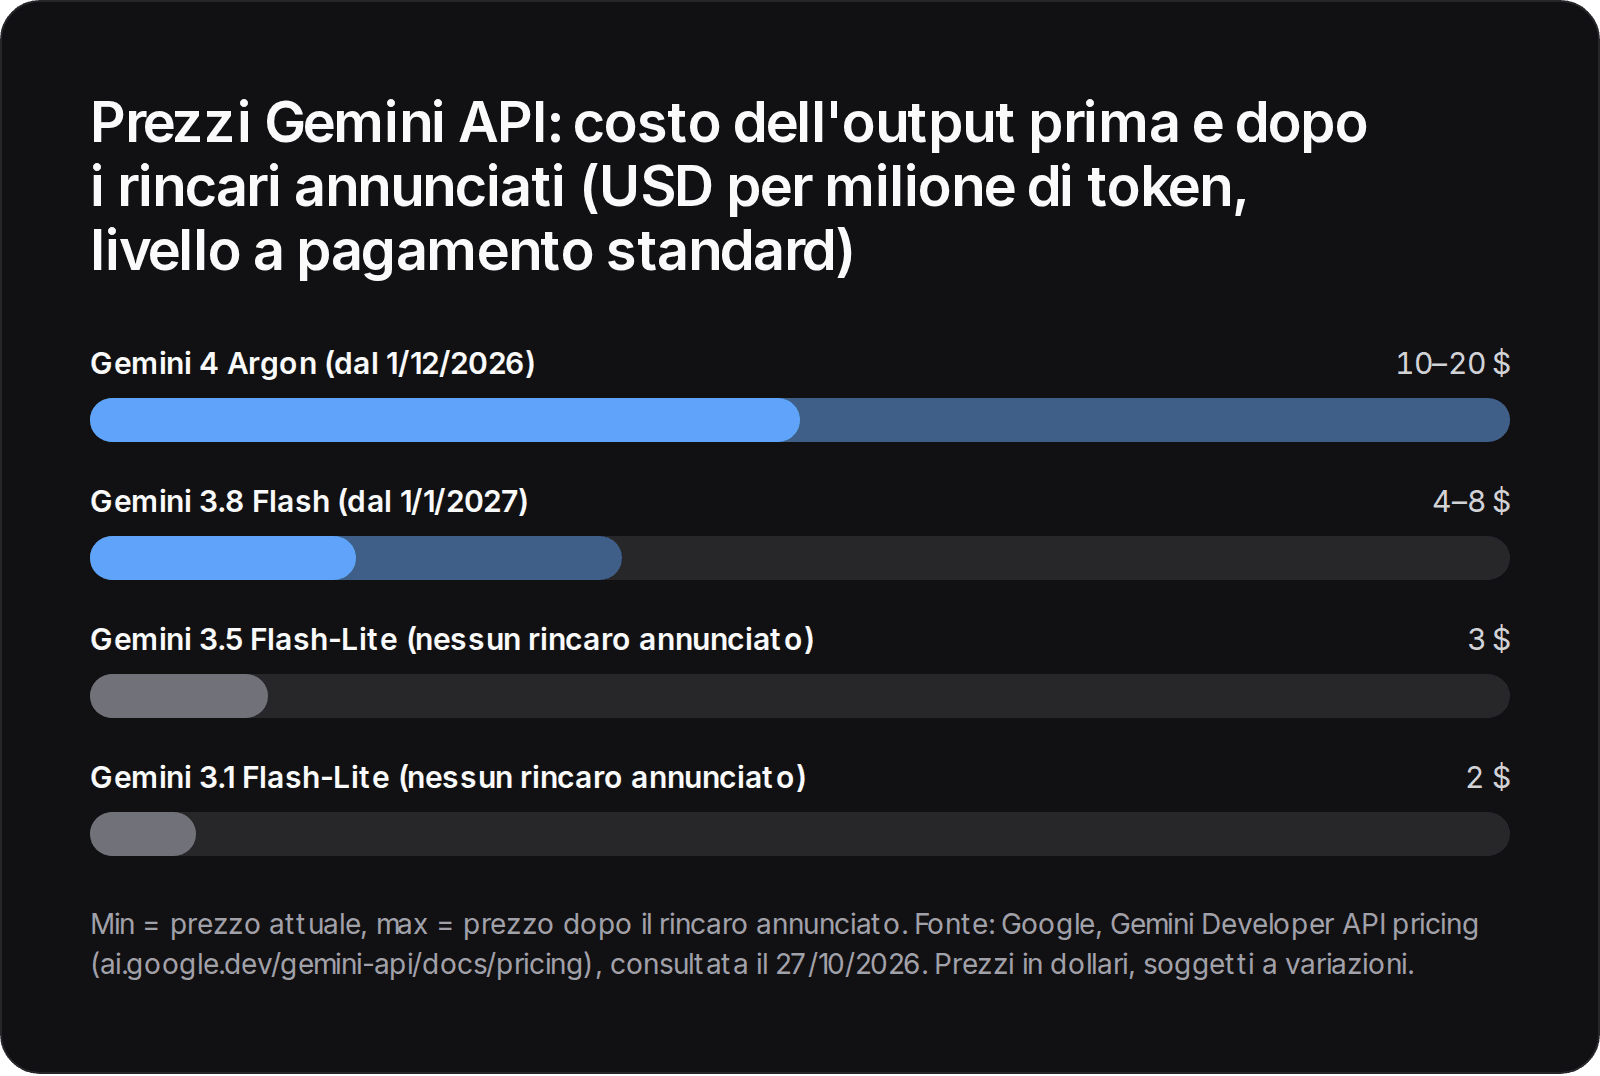
Duecento dollari al mese restano una cifra gestibile per molte aziende. Il punto è un altro: il budget dipende da decisioni del fornitore. In questo caso il listino di Argon raddoppia dal 1° dicembre, a poco più di un mese dalla data in cui ho consultato la pagina prezzi.
Batch, Flex, Priority e cache: quanto pesano sul conto reale?
Il livello di servizio può dimezzare il conto oppure quasi raddoppiarlo. Secondo la pagina prezzi, Batch e Flex costano la metà dello standard, mentre Priority costa circa 1,8 volte lo standard.
| Livello | Argon input (oggi → dic.) | Argon output (oggi → dic.) | 3.8 Flash input (oggi → gen.) |
|---|---|---|---|
| Batch / Flex | 1,00 → 2,00 | 5,00 → 10,00 | 0,375 → 0,75 |
| Standard | 2,00 → 4,00 | 10,00 → 20,00 | 0,75 → 1,50 |
| Priority | 3,60 → 7,20 | 18 → 36 | 1,35 → 2,70 |
USD per milione di token, dalla pagina prezzi di Google, consultata il 27/10/2026. Batch e Flex non sono disponibili sul livello gratuito.
Ecco un criterio pratico per assegnare i flussi:
- Batch o Flex per i lavori che possono aspettare: classificazione di archivi, riassunti notturni, arricchimento delle schede nel CRM, estrazione di dati da documenti accumulati.
- Standard per le chat interattive e gli assistenti usati dalle persone durante la giornata.
- Priority solo dove la latenza ha un valore misurabile, per esempio un assistente rivolto ai clienti con tempi di risposta concordati. Se quel valore non si sa misurare, Priority è probabilmente un costo di troppo.
La cache serve quando si ripetono un prompt di sistema lungo o gli stessi documenti in molte chiamate. Ha però un costo di archiviazione orario che per i Flash passa da 0,50 a 1,00 $ a gennaio (fonte). Il risparmio dipende da quante volte il contenuto viene riletto prima di scadere, e va stimato sui dati reali.
Una voce che sfugge spesso ai preventivi è il grounding con Ricerca Google o Maps. Le prime 5.000 richieste al mese sono gratuite e la quota è condivisa tra i modelli Gemini 3 e successivi. Oltre questa soglia si pagano 14 $ ogni 1.000 richieste, in aggiunta ai token (fonte). Un assistente che consulta il web a ogni domanda può superare la soglia in fretta.
Dove finiscono i dati inviati alle API di Gemini, e per quanto restano?
Con i servizi a pagamento Google dichiara di non usare prompt e risposte per migliorare i prodotti. Li registra però per un periodo limitato, solo per rilevare e prevenire violazioni della politica d'uso e per eventuali comunicazioni richieste da leggi o autorità (termini aggiuntivi della Gemini API). Le norme d'uso e di monitoraggio degli abusi indicano una conservazione di 55 giorni per prompt, contesto e output.
I dati conservati possono essere consultati in revisione umana solo da dipendenti Google autorizzati. Secondo la stessa pagina, non vengono usati per addestrare modelli diversi da quelli dedicati al controllo delle regole. La pagina non indica in quale regione sono conservati i dati né un'opzione a conservazione zero. Prima di inviare dati riservati o personali, conviene chiarire entrambi i punti a livello contrattuale.
Poi c'è il logging, una funzione distinta dal monitoraggio degli abusi e disponibile solo per i progetti con fatturazione attiva. La policy su log e condivisione dei dati, aggiornata il 26/10/2026, prevede quanto segue:
- il logging è attivo di default per le chiamate Interactions API e, nei progetti creati dal 26 ottobre 2026 in poi, anche per le chiamate Generate Content;
- i log restano al massimo 55 giorni di default, con durata impostabile a 7, 14, 28 o 55 giorni;
- i log salvati in un dataset non hanno scadenza;
- i dataset condivisi con Google seguono le condizioni dei servizi non a pagamento e possono servire a migliorare i prodotti, ma è possibile fare opt-out dalla creazione del dataset.
La stessa policy descrive anche un Contributor Tier, in anteprima privata su invito: fino al 50% di sconto sui token di alcuni modelli, in cambio dell'uso dei dati alle condizioni dei servizi non a pagamento. È un buon esempio di come costo e riservatezza siano legati: lo sconto si paga con i dati.
In pratica, per un'azienda servono tre cose:
- impostare la conservazione dei log al minimo compatibile con le proprie esigenze di debug;
- fare opt-out dalla creazione di dataset condivisi con Google;
- registrare chi usa quali chiavi API, per quali progetti e con quali dati.
Nessuna di queste impostazioni rende automaticamente conforme il trattamento. Restano gli obblighi del titolare, di cui parlo nella pagina su AI e GDPR. Per un confronto con un altro fornitore, c'è l'articolo su ChatGPT e i dati riservati.
Il livello gratuito di Gemini si può usare in azienda in Europa?
Nello Spazio economico europeo, in Svizzera e nel Regno Unito le condizioni dei servizi a pagamento si applicano a tutti i servizi. Valgono quindi anche per la quota gratuita e per Google AI Studio, come indicano i termini aggiuntivi. Gli stessi termini stabiliscono che chi rende disponibili applicazioni a utenti in queste aree può usare solo i servizi a pagamento.
Fuori da queste aree il quadro è diverso. Sui servizi gratuiti Google usa i contenuti per migliorare i prodotti, possono intervenire revisori umani, e i termini chiedono di non inviare informazioni sensibili, riservate o personali. La tabella prezzi lo riassume così: per 3.8 Flash, 3.6 Flash, Flash-Lite e Gemma 4, "Used to improve our products" vale Yes sul livello gratuito e No su quello a pagamento.
A mio avviso il rischio più concreto non è la scelta del piano, ma i dipendenti che aprono account o chiavi API personali per "provare", fuori da qualsiasi controllo aziendale. Servono una policy d'uso chiara, un canale ufficiale e un minimo di formazione. Ne parlo nella pagina sul ChatGPT aziendale privato.
Il tema della privacy pesa anche sulle decisioni di adozione. Nel 2025, tra le imprese UE che avevano valutato l'AI senza adottarla, il 48,83% cita timori su protezione dei dati e privacy (Eurostat). In Italia, nel 2025, la privacy è un ostacolo per il 43,2% delle imprese che non usano l'AI (ISTAT).
Quando conviene un modello open-weight al posto delle API di Gemini?
Per volumi bassi o medi, picchi irregolari e bisogno dei modelli più capaci, le API restano di solito più economiche e più semplici da gestire. Un modello open-weight in azienda può avere senso con volumi alti e costanti, con dati che non devono uscire o con il bisogno di un budget prevedibile.
Il conto cambia quando gli utenti sono centinaia e lavorano ogni giorno, quando i flussi automatici girano in continuo e se i rincari si ripetono nel tempo. Cambia anche quando i requisiti di riservatezza, in cloud, richiedono comunque controlli, contratti e lavoro legale. La differenza strutturale è questa: il costo locale è in gran parte fisso, quello delle API cresce con l'uso e con le persone.
| Criterio | API di Gemini | Open-weight in azienda |
|---|---|---|
| Costo | Variabile, legato a token e listino | In gran parte fisso, legato a hardware e assistenza |
| Qualità sui compiti difficili | Modelli di frontiera | Può essere inferiore su alcuni compiti: va misurata sui propri casi |
| Dati | Conservati dal fornitore per un periodo definito | Restano nell'infrastruttura scelta |
| Avvio | Rapido | Richiede progetto e installazione |
| Manutenzione | A carico del fornitore | Aggiornamenti, energia e assistenza a carico dell'azienda |
| Ritiro dei modelli | Deciso dal fornitore | Deciso dall'azienda |
Anche il locale ha costi da non sottovalutare: possibile qualità inferiore ai modelli di frontiera su alcuni compiti, manutenzione, aggiornamento dei modelli, energia. Li ho scomposti nella pagina sui costi dell'AI in locale e nell'articolo su quanto costa un'intelligenza artificiale privata.
Spesso la scelta più sensata è un'architettura ibrida. Un modello open-weight interno gestisce i dati riservati e i volumi ripetitivi, mentre le API di frontiera restano per i compiti difficili e non sensibili. Come si pianifica il passaggio è spiegato nella pagina sulla migrazione dalle API.
Anche i costi frenano le aziende: in Italia, nel 2025, sono un ostacolo per il 43,0% delle imprese che non usano l'AI (ISTAT). Per questo il confronto va fatto sui consumi reali, non sulle impressioni.
Da dove partire per stimare il costo reale delle API di Gemini?
Il primo passo è ricalcolare il conto attuale con i listini che entreranno in vigore. Prima di questo, qualsiasi confronto con un'alternativa resta un esercizio teorico.
- Estrai i consumi reali degli ultimi due o tre mesi dalla console. Dividili per input, output, cache e grounding, poi ricalcolali con i prezzi in vigore da dicembre e da gennaio (pagina prezzi).
- Classifica i flussi: cosa può passare a Batch o Flex, cosa deve restare standard, cosa richiede davvero Priority.
- Controlla le date di ritiro dei modelli che usi nella documentazione sul ciclo di vita. Google precisa che le date possono essere rimandate, ma non anticipate. Pianifica i test sul sostituto prima della scadenza, perché costo e comportamento possono cambiare.
- Rivedi log e condivisione secondo la policy sui log e scrivi una policy interna sull'uso delle chiavi API.
- Solo a quel punto confronta il risultato con uno scenario open-weight o ibrido su tre anni.
Altri confronti di questo tipo sono raccolti nella categoria Costi e TCO. Se vuoi una lettura indipendente dei tuoi numeri, puoi richiedere una valutazione. Non vendo hardware né licenze, quindi se il cloud resta la scelta migliore per il tuo caso te lo dico.
Domande frequenti
Quanto costa il grounding con Google Search nelle API di Gemini?
Secondo la pagina prezzi di Google, consultata il 27/10/2026, le prime 5.000 richieste al mese sono gratuite e la quota è condivisa tra i modelli Gemini 3 e successivi. Oltre quella soglia si pagano 14 $ ogni 1.000 richieste, in aggiunta al costo dei token. I prezzi possono cambiare.
Cos'è il Contributor Tier di Gemini e conviene a un'azienda?
È un'anteprima privata su invito: Google dichiara fino al 50% di sconto sui token di alcuni modelli, in cambio dell'uso dei dati alle condizioni dei servizi non a pagamento, quindi anche per migliorare i prodotti. Per dati riservati o personali è una scelta da valutare con molta cautela insieme al proprio consulente privacy.
Cosa succede quando Google ritira un modello Gemini che uso in produzione?
Le chiamate al modello ritirato smettono di funzionare e bisogna passare al sostituto indicato. Per esempio Gemini 3.6 Flash viene ritirato il 19/11/2026 e il sostituto è gemini-3.8-flash. Google precisa che le date di ritiro possono essere rimandate, ma non anticipate. Conviene testare il sostituto con anticipo, perché costo e comportamento possono cambiare.
Posso usare Gemma 4 a pagamento tramite le API di Google?
No. Alla data di consultazione la pagina prezzi indica Gemma 4 come gratuito sul livello gratuito e 'Not available' su quello a pagamento. Essendo un modello open-weight, però, si può installare su un'infrastruttura propria o di un fornitore scelto dall'azienda, con costi e responsabilità di gestione a carico di chi lo installa.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
È sicuro utilizzare ChatGPT con i dati riservati della propria azienda?
Usare ChatGPT con dati riservati dipende dal piano, dal contratto e dalle regole interne. Una risposta onesta per chi guida un'azienda: account personali, piani business, GDPR e casi in cui conviene un'AI sui propri server.
Privacy, GDPR e sovranità dei dati8 min
Intelligenza artificiale offline: come utilizzare un LLM senza connessione Internet
Un LLM può funzionare senza connessione Internet, su server o PC aziendali. Spieghiamo cosa serve, come evitare che un'installazione "locale" contatti comunque servizi esterni, quanto costa rispetto alle API e quando conviene restare in cloud.
AI offline e industria8 min