Come creare un agente AI per l'azienda: dal processo da ottimizzare al primo flusso in produzione
Per creare un agente AI si parte dal processo, non dallo strumento. Vediamo come scegliere il primo flusso, quando basta un workflow, quale modello usare per ogni passaggio, quali dati escono dall'azienda e quali controlli servono prima della produzione.
Pubblicato il
Per creare un agente AI per l'azienda si parte da un processo preciso. Se ne descrivono passaggi ed eccezioni, si sceglie il modello e gli strumenti per ogni passaggio, si limitano i permessi e si decide dove serve l'approvazione di una persona. Lo strumento di sviluppo viene dopo, e conviene poterlo sostituire. Spesso il primo "agente" conviene che sia un workflow con un LLM in alcuni punti: tende a costare meno ed è più facile da controllare.
Lo strumento può cambiare anche senza che l'azienda lo decida. OpenAI ha annunciato il 3 giugno 2026 che Agent Builder chiuderà il 30 novembre 2026, insieme all'API v1/prompts (pagina Deprecations di OpenAI). Chi ha costruito i propri flussi solo lì ora deve ricostruirli altrove. Per questo l'articolo parte dal processo e arriva allo strumento solo alla fine.
Cosa serve per creare un agente AI, e quando basta un workflow?
Serve un processo descritto bene. Un agente autonomo serve solo quando i passaggi non si possono stabilire in anticipo. Nella guida Building effective agents, Anthropic chiama workflow i "systems where LLMs and tools are orchestrated through predefined code paths", mentre gli agenti "dynamically direct their own processes and tool usage". Nel workflow il percorso lo decide chi scrive il codice, nell'agente lo decide il modello.
La guida raccomanda di partire da "finding the simplest solution possible, and only increasing complexity when needed" e avverte che "the autonomous nature of agents means higher costs, and the potential for compounding errors" (Anthropic): un errore al secondo passaggio può trascinarsi fino all'ultimo.
| Criterio | Workflow con LLM | Agente autonomo |
|---|---|---|
| Prevedibilità dei passaggi | Passaggi fissi, decisi nel codice | Il modello sceglie passaggi e strumenti |
| Costo | Numero di chiamate noto in anticipo | Numero di chiamate variabile |
| Controllabilità | Si testa passaggio per passaggio | Servono log dettagliati e punti di arresto |
| Casi tipici | Smistamento email, estrazione dati da ordini, bozze | Ricerche su più fonti, pratiche con molte eccezioni |
Nel resto dell'articolo uso "agente" per entrambi, come si fa sul mercato, ma la scelta va fatta passaggio per passaggio.
Quale processo aziendale scegliere per il primo agente AI?
Il primo processo da scegliere ha volume alto, ingresso testuale ed errori facili da correggere. Secondo Istat, nel 2025 usa l'AI il 16,4% delle imprese con almeno 10 addetti (8,2% nel 2024), e tra chi la usa il 70,8% la impiega per analizzare testi e documenti. Tra gli ambiti rilevati figurano marketing e vendite (33,1%) e processi amministrativi (25,7%): aree in cui cercare i primi candidati.
I criteri da verificare:
- Volume alto e ripetitivo: tante pratiche simili ogni settimana.
- Ingresso testuale: email, PDF, moduli, trascrizioni di chiamate.
- Risultato misurabile: si può dire se la pratica è stata gestita bene.
- Errore reversibile: una classificazione sbagliata si corregge, un bonifico partito no.
- Una persona di riferimento che oggi fa quel lavoro e può controllare l'agente.
Esempi per reparto: in assistenza, smistamento delle richieste e prima bozza di risposta; nell'ufficio ordini, lettura degli ordini via email e preparazione dell'inserimento nell'ERP; nelle vendite, aggiornamento del CRM dagli appunti di una chiamata; in amministrazione, estrazione dei dati dai documenti e controllo con l'anagrafica.
Per il collegamento ai gestionali rimando alla guida su come integrare l'AI con ERP e CRM. All'inizio conviene evitare selezione del personale o valutazione del credito: rientrano tra i sistemi ad alto rischio dell'Allegato III dell'AI Act (AI Act Service Desk, articolo 26).
Come si descrive il processo prima di scrivere una riga di codice?
Si descrive come lo svolgono oggi le persone: cosa entra (canale, formato, frequenza), i passaggi nell'ordine reale, le decisioni e chi le prende, le eccezioni frequenti, i sistemi coinvolti, chi approva e cosa esce.
Per ogni passaggio va annotato se legge dati, scrive dati o comunica con l'esterno: questa distinzione decide permessi e approvazioni. Un esempio sul flusso degli ordini:
| Passaggio | Tipo | Approvazione di una persona |
|---|---|---|
| Leggere l'email e l'allegato | Legge | No |
| Estrarre cliente, articoli, quantità | Legge | No |
| Controllare anagrafica e listino nell'ERP | Legge | No |
| Inserire l'ordine nell'ERP | Scrive | Sì, nelle prime fasi |
| Inviare la conferma al cliente | Comunica all'esterno | Sì |
Tra un passaggio e l'altro conviene usare output strutturati, cioè dati con campi fissi come un JSON con cliente, codice articolo e quantità. OpenAI li raccomanda per "eliminate freeform channels that attackers can exploit" (OpenAI, Safety in building agents); in più, un campo si confronta con il valore atteso, un testo libero molto meno.
Vanno preparati subito un insieme di casi reali anonimizzati con il risultato corretto, da usare come test, e le metriche: quota di casi gestiti senza correzioni, tempo per pratica, errori trovati in revisione. Gli obiettivi si fissano dopo aver misurato il punto di partenza.
Quale modello usare per ogni passaggio, e quanto costa farlo girare?
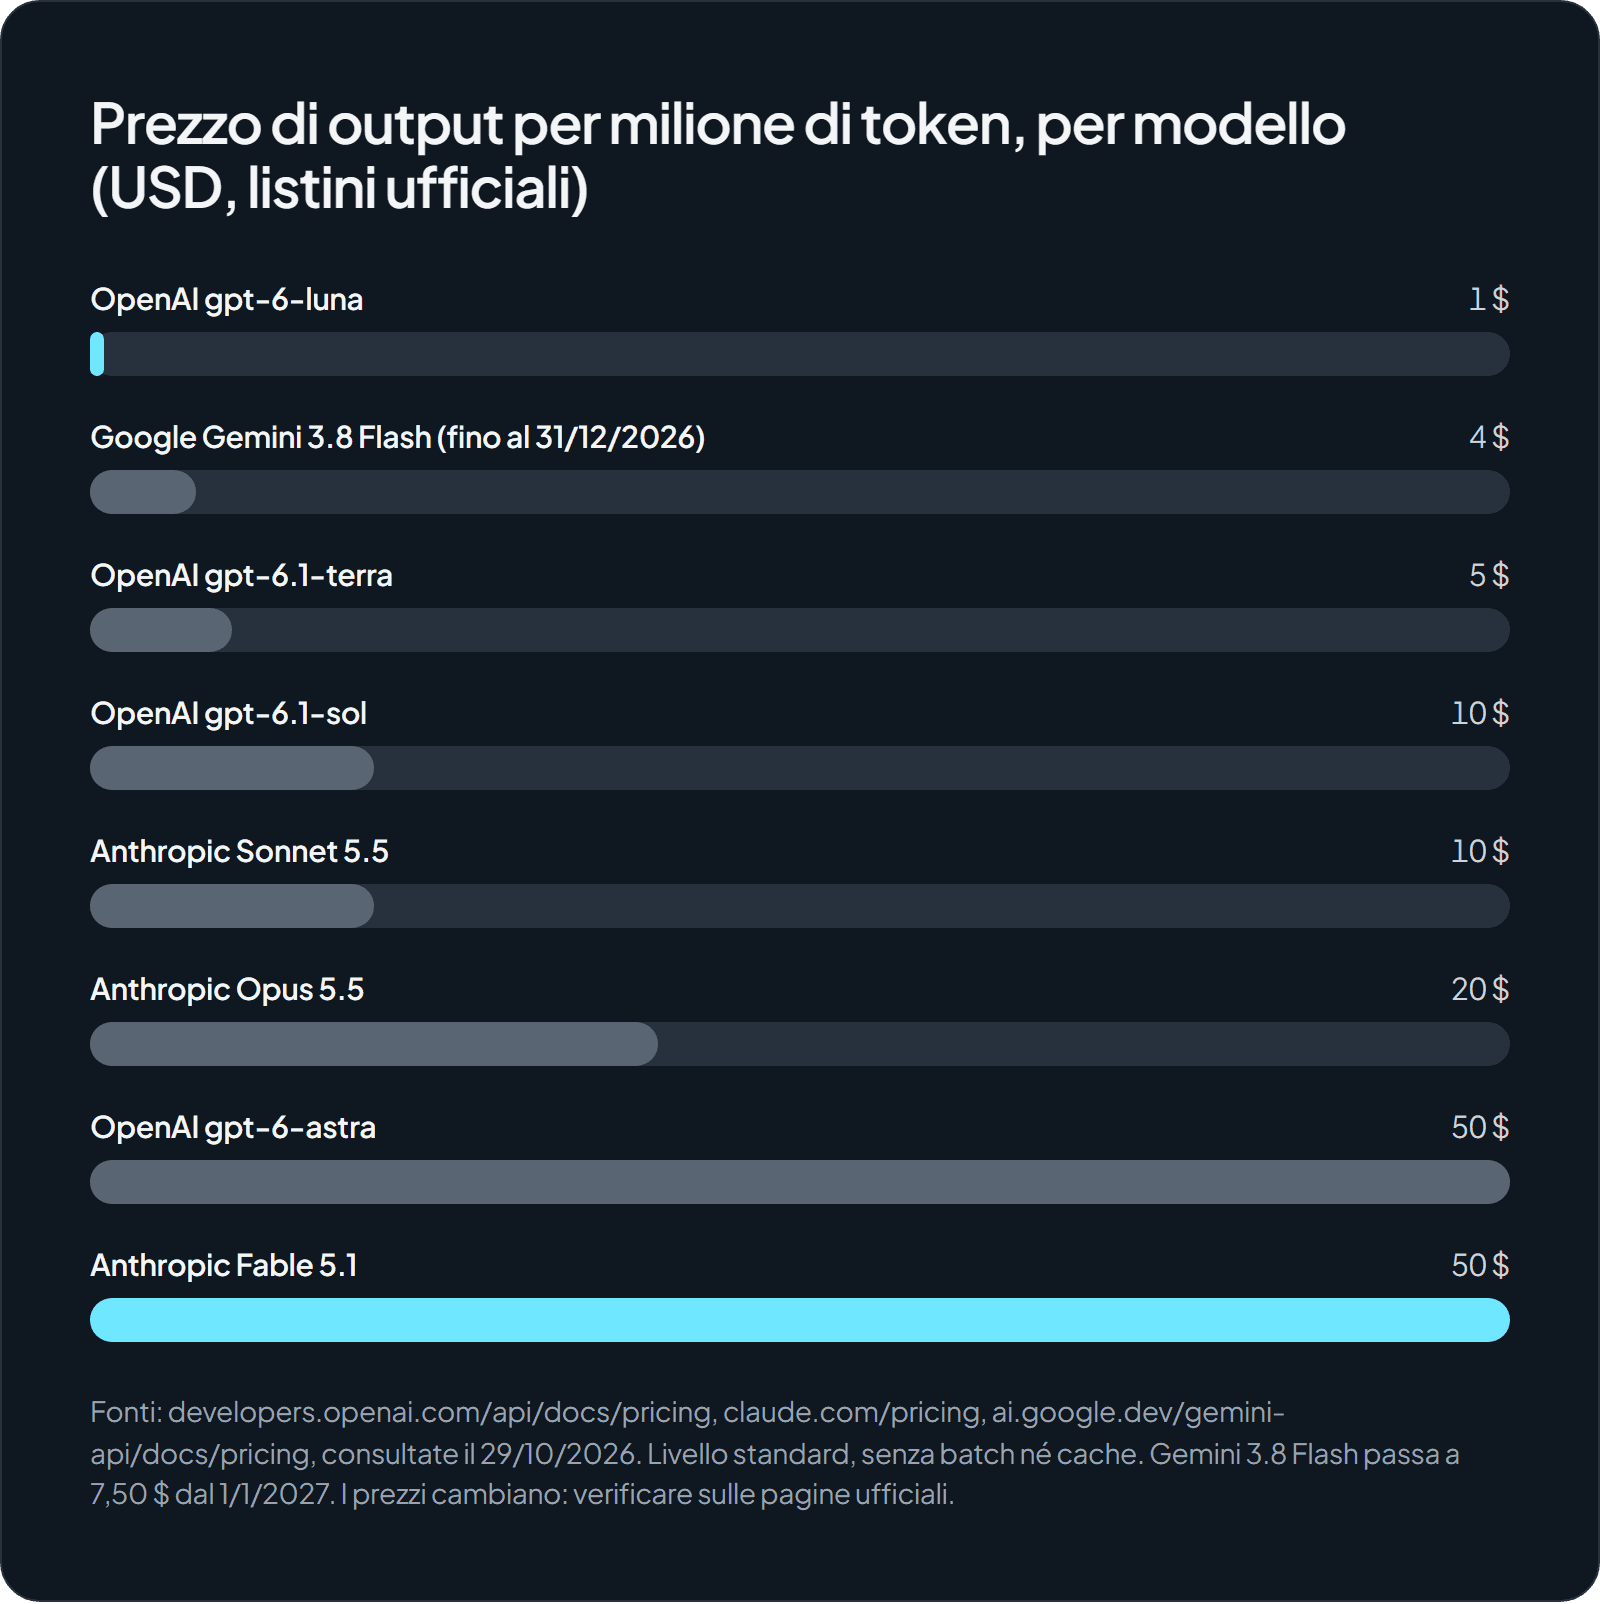
Per ogni passaggio conviene usare il modello più piccolo che supera i test sui casi reali. Ecco i listini ufficiali, consultati il 29/10/2026, in dollari per milione di token (livello standard). Cambiano spesso: vanno ricontrollati prima di ogni stima.
| Modello | Input | Output | Fonte |
|---|---|---|---|
| gpt-6-luna | 0,10 $ | 0,50 $ | OpenAI |
| gpt-6.1-terra | 1,00 $ | 5,00 $ | OpenAI |
| gpt-6.1-sol | 2,00 $ | 10,00 $ | OpenAI |
| gpt-6-astra | 10,00 $ | 50,00 $ | OpenAI |
| Sonnet 5.5 | 2 $ | 10 $ | Anthropic |
| Opus 5.5 | 4 $ | 20 $ | Anthropic |
| Fable 5.1 | 10 $ | 50 $ | Anthropic, documentazione |
| Gemini 3.8 Flash | 0,75 $ (1,50 $ dal 1/1/2027) | 3,75 $ (7,50 $ dal 1/1/2027) | |
| Gemini 4 Argon | 2 $ (4 $ dal 1/12/2026) | 10 $ (20 $ dal 1/12/2026) |
Per i passaggi che non richiedono risposta immediata il batch costa circa la metà su OpenAI e su Anthropic. Sui rincari di Google c'è un'analisi dedicata sui prezzi delle API di Gemini.
Un agente consuma anche strumenti: la ricerca web costa 10 $ ogni 1.000 chiamate su OpenAI (più i token dei risultati) e 10 $ ogni 1.000 ricerche su Anthropic; il grounding con Google Search è gratuito fino a 5.000 richieste al mese per Gemini 3 e successivi, poi "$14 per 1,000 requests" (Google). OpenAI applica inoltre un sovrapprezzo del 10% sugli endpoint regionali per i modelli usciti dal 5 marzo 2026 (OpenAI).
Per passaggi con volumi molto alti e dati sensibili può avere senso un modello open-weight in locale, da confrontare sui costi su più anni come spiego nella pagina sui costi dell'AI in locale.
Quali dati passano dal fornitore quando l'agente lavora?
Al fornitore passa tutto ciò che l'agente mette nel prompt: non solo la richiesta, ma anche ciò che recupera dai sistemi, come anagrafica, storico ordini e note del CRM. Più strumenti si collegano, più dati possono uscire a ogni chiamata.
Conta anche il tipo di account. Per le API di Gemini, i dati del livello gratuito vengono usati per migliorare i prodotti, quelli del livello a pagamento no, salvo il livello "Contributor" in anteprima privata (Google). Va controllato quale livello usa chi sviluppa, anche nei prototipi. Gli endpoint regionali di OpenAI servono a scegliere dove avviene l'elaborazione, ma vanno valutati insieme al contratto e alle regole sul trattamento, non al loro posto: ne parlo nella pagina su AI e GDPR.
Anche l'infrastruttura può sbagliare. Cloudflare ha documentato che dal 27 agosto al 9 settembre 2026, su Workers AI con il modello GLM-5.3, "155 responses" relative a prompt molto lunghi potevano contenere residui di altre richieste, per una memoria configurata sotto il contesto dichiarato e un bug di SGLang; consiglia SGLang v0.5.22 o successiva (Cloudflare). La lezione vale anche per chi gestisce lo stack in proprio: i componenti di inferenza vanno aggiornati e configurati con cura.
Una soluzione frequente è l'architettura ibrida: i passaggi con dati personali o documenti riservati restano su un modello in locale, gli altri vanno al modello di frontiera. È uno dei temi del servizio sugli agenti AI personalizzati.
Quali permessi e controlli servono prima di mettere l'agente in produzione?
L'agente deve avere solo gli strumenti, i permessi e l'autonomia che servono al suo processo. La scheda OWASP LLM06 Excessive Agency indica tre cause di problemi: funzioni in eccesso, permessi in eccesso sui sistemi a valle (scrittura su tutto l'ERP quando basterebbe la lettura) e autonomia in eccesso. Le contromisure: strumenti e permessi minimi, approvazione umana delle azioni ad alto impatto, esecuzione nel contesto dell'utente e non con un account amministrativo, registro dell'attività e limiti alla frequenza delle azioni.
C'è poi la prompt injection: "untrusted text or data enters an AI system, and malicious contents in that text or data attempt to override instructions to the AI" (OpenAI). Per un agente che legge la posta, ogni email è testo non affidabile. OpenAI suggerisce filtri in ingresso e di "always enable tool approvals"; la guida è scritta per Agent Builder, in dismissione, ma i principi valgono altrove. Anthropic aggiunge "extensive testing in sandboxed environments" e punti in cui l'agente si ferma per chiedere a una persona (Anthropic).
Per i sistemi ad alto rischio, l'articolo 26 dell'AI Act chiede supervisione da parte di "natural persons who have the necessary competence, training and authority" e la conservazione dei log per un periodo "of at least six months". Un agente che smista email od ordini di norma non rientra nell'alto rischio; anche lì, però, log e responsabili nominati sono una buona pratica, che resta una parte della conformità, non la conformità intera.
Come si evita che un agente si fermi a metà mese o costi più del previsto?
Servono tetti di spesa impostati di proposito e un agente che sappia cosa fare quando li raggiunge. Anthropic distingue "spend limits" (costo mensile massimo) e "rate limits" (richieste e token al minuto); il tetto mensile va da 500 $ per il livello Start a 200.000 $ per Scale (Anthropic, Rate limits). Raggiunto il tetto, l'API si ferma fino al primo giorno del mese successivo e restituisce l'errore HTTP 429 enforced_spend_limit_reached, senza retry-after. Un agente in produzione deve riconoscerlo: invece di ritentare, mette le pratiche in coda, manda un avviso e passa il lavoro a una persona.
L'azienda può fissare limiti più bassi per singolo workspace, ma non sul workspace predefinito (Anthropic): conviene un workspace dedicato per ogni agente. Per Claude Enterprise, Anthropic ha annunciato il 28/10/2026 budget mensili condivisi per gruppo, con avvisi email al 50, 75, 95 e 100% (Anthropic).
Il secondo rischio è il ritiro di modelli e strumenti. Secondo la pagina Deprecations di OpenAI, il 30/11/2026 chiudono Agent Builder e l'API v1/prompts, l'11/12/2026 escono dall'API gpt-5 e o3 con le loro varianti, il 14/1/2027 gpt-4o, gpt-4o-mini e gpt-4.1. La difesa è tenere fuori dal tool del fornitore logica, prompt e casi di test, così da poter rifare i test e cambiare modello. Ne parlo nell'articolo sul vendor lock-in nell'AI.
Come si passa dal pilota al primo flusso in produzione?
A fasi, con un'autonomia che cresce solo dove i test lo giustificano.
- In parallelo: l'agente lavora sugli stessi casi delle persone, senza che vedano le sue proposte; poi si confrontano i risultati.
- Proposta e approvazione: l'agente prepara bozze e inserimenti, una persona approva ogni scrittura.
- Autonomia limitata: l'agente agisce da solo solo su azioni a basso impatto e reversibili, con registro, tetto di spesa e revisione a campione.
Ogni fase richiede responsabilità chiare: chi possiede il processo, chi approva, chi legge i log, chi forma le persone. La formazione fa parte del progetto: tra le imprese che hanno valutato l'AI senza adottarla, il 58,6% indica come ostacolo la mancanza di competenze (Istat).
Altri spunti si trovano nella categoria AI nei processi aziendali. Se vuoi capire quale processo della tua azienda si presta a un primo agente, quali dati passerebbero dal fornitore e con quali controlli, puoi partire dalla valutazione iniziale.
Domande frequenti
Serve un programmatore per creare un agente AI aziendale?
Per un prototipo spesso bastano strumenti visuali o le piattaforme dei fornitori. Per un agente che legge e scrive su ERP, CRM o posta aziendale servono invece competenze di integrazione: permessi, gestione degli errori, log e test. Il ruolo che non si può delegare è quello di chi conosce il processo e decide cosa l'agente può fare.
Conviene addestrare un modello con il fine-tuning per il proprio agente?
Per la maggior parte dei processi aziendali no: istruzioni chiare, esempi e accesso ai documenti giusti danno risultati più facili da controllare e aggiornare. Il fine-tuning lega inoltre al fornitore. OpenAI, per esempio, indica che dal 6 gennaio 2027 i clienti esistenti non potranno creare nuovi job di fine-tuning (pagina Deprecations, consultata il 29/10/2026).
Un agente AI può sostituire un dipendente?
Nei casi realistici un agente si occupa di una parte del lavoro: smistare, estrarre, preparare bozze. La persona resta per le eccezioni, le approvazioni e il rapporto con il cliente. Conviene misurare quanto lavoro ripetitivo si toglie al reparto, senza ragionare in termini di posti sostituiti.
Cosa succede se il modello usato dall'agente viene ritirato?
L'agente smette di funzionare o va spostato sul modello sostitutivo, che può costare e comportarsi in modo diverso. Per questo conviene tenere prompt, casi di test e logica del processo fuori dagli strumenti del fornitore, così da poter rifare i test e cambiare modello con meno lavoro.
Chi scrive
Lilium AI
AI nei processi aziendali: in locale per i dati sensibili, con i modelli di frontiera per il resto
Da leggere dopo
Come integrare un'intelligenza artificiale privata con ERP, CRM e software aziendali
Collegare un'AI a ERP, CRM e gestionali: casi d'uso da cui partire, come funzionano connettori e Model Context Protocol, quanto costano le soluzioni dei fornitori e quali controlli servono per tenere i dati in azienda.
Integrazione con ERP, CRM e migrazione API9 min
Vendor lock-in nell'AI: cosa costa quando il fornitore ritira o cambia il modello che usi
I fornitori di AI ritirano i modelli con preavvisi da 45 giorni a 6 mesi, e i sostituti possono costare molto di più. Come stimare il costo del vendor lock-in AI e come ridurlo con modelli open-weight e un'architettura che non dipenda da un solo fornitore.
Integrazione con ERP, CRM e migrazione API10 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min