Migrare dalle API OpenAI a un LLM locale: guida tecnica, costi e rischi
OpenAI spegne gpt-4o e gpt-4.1 il 14 gennaio 2027. Ecco cosa cambia nel codice quando si passa a Ollama o vLLM, quali parametri si perdono, quanto costano i listini attuali, quali dati restano da OpenAI e in quali casi conviene restare in cloud.
Pubblicato il
Per migrare da API OpenAI a un LLM locale spesso basta cambiare poco codice. Ollama e vLLM espongono endpoint compatibili con quelli di OpenAI, quindi in molti casi si cambiano solo l'indirizzo e il nome del modello. Il lavoro vero è altrove: alcuni parametri mancano, la qualità va misurata sui propri casi d'uso e il server va gestito e protetto. Chi usa gpt-4o o gpt-4.1 deve comunque cambiare modello entro il 14 gennaio 2027, quindi conviene valutare anche l'opzione locale.
Cosa significa migrare da API OpenAI a un LLM locale, e quanto codice va riscritto?
Significa far rispondere un modello open-weight, installato su un server dell'azienda, alle stesse chiamate che oggi l'applicazione invia a OpenAI. Se il codice usa chat/completions o embeddings, le modifiche sono spesso minime. Con Ollama l'indirizzo locale è http://localhost:11434/v1/. Il client chiede comunque una chiave API, che Ollama ignora (documentazione Ollama):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:11434/v1/", api_key="ollama")
risposta = client.chat.completions.create(
    model="nome-modello-locale",
    messages=[{"role": "user", "content": "Riassumi questa procedura"}],
)
Ollama supporta /v1/chat/completions, /v1/completions, /v1/embeddings, /v1/models e gli endpoint audio. Dalla versione 0.13.3 supporta anche /v1/responses, ma senza stato lato server (Ollama). Il comando ollama cp crea un alias con il nome di un modello OpenAI: durante i test l'applicazione può continuare a chiedere "gpt-4o" e ricevere la risposta dal modello locale. vLLM copre completions, chat/completions (con chat template), Responses, embeddings e audio. La sua documentazione è segnata come "developer preview".
La compatibilità riguarda il formato delle chiamate, non la qualità delle risposte. Cambiare l'indirizzo richiede poco tempo. Per capire se il nuovo modello risponde bene servono invece prove strutturate. Nella pagina sulla migrazione dalle API spiego come imposto questa valutazione.
Quali funzioni delle API OpenAI non si ritrovano in Ollama e vLLM?
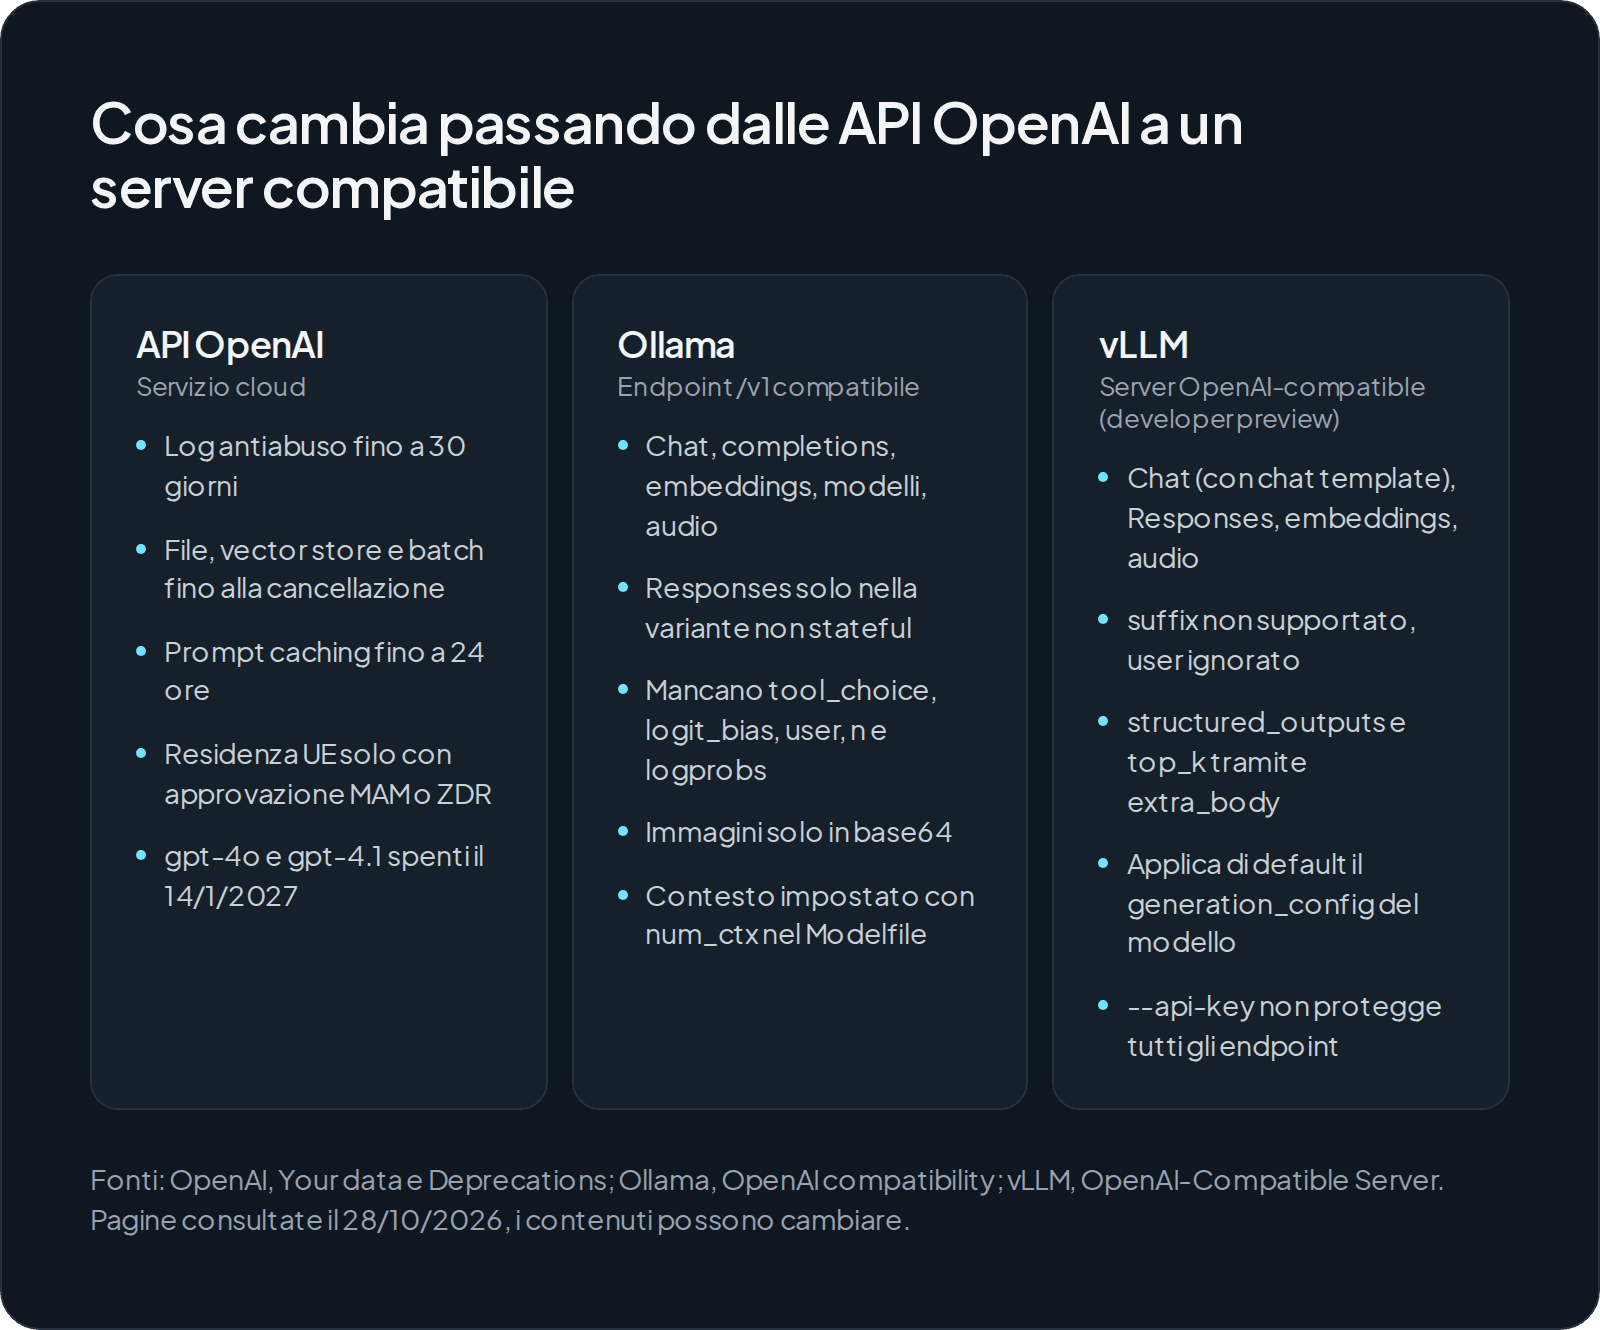
Mancano alcuni parametri e lo stato lato server. Alcune impostazioni vanno inoltre spostate nella configurazione del server. La tabella riassume le differenze indicate nelle documentazioni di Ollama e vLLM:
| Funzione usata oggi | Ollama | vLLM | Cosa fare |
|---|---|---|---|
| Chat completions | Supportata | Supportata, con chat template | Verificare il template del modello |
| Embeddings | Supportati | Supportati | Verificare la compatibilità degli indici già creati |
| Responses con stato | Non supportato | Endpoint presente, stato da verificare | Salvare la cronologia nell'applicazione |
tool_choice, n, logprobs, logit_bias | Non supportati | Da verificare sulla versione in uso | Rivedere la logica che li usa |
user | Non supportato | Ignorato | Tracciare l'utente nei log applicativi |
suffix | Non indicato | Non supportato | Riformulare il prompt |
Output strutturati, top_k | Da verificare | Tramite extra_body | Adattare la chiamata |
| Immagini via URL | Solo base64 | Da verificare | Convertire le immagini prima dell'invio |
| Lunghezza del contesto | Modelfile, num_ctx | Da verificare | Spostare l'impostazione lato server |
Due dettagli pesano più di quanto sembri. Con Ollama la cronologia della conversazione deve gestirla l'applicazione, perché su Responses mancano previous_response_id e conversation. vLLM applica di default il file generation_config.json del modello: anche a parità di prompt, le risposte possono differire da quelle di OpenAI.
Anche chi resta in cloud deve aspettarsi modifiche. Con la versione API 2026-10-21, Anthropic ha rimosso temperature, top_p e top_k, che ora restituiscono un errore 400 (Anthropic, deprecazioni).
Perché i ritiri dei modelli OpenAI rendono la decisione urgente?
Perché chi usa gpt-4o o gpt-4.1 deve migrare comunque entro il 14 gennaio 2027. Il calendario è nella pagina delle deprecazioni di OpenAI:
| Data di spegnimento | Modelli | Sostituto indicato |
|---|---|---|
| 23/10/2026 (già avvenuto) | GPT-3.5 Turbo, GPT-4, GPT-4 Turbo, GPT-4.1 nano, GPT-4o 2024-05-13, o1, o3-mini, o4-mini e relativi fine-tuned | — |
| 11/12/2026 | GPT-5 (con mini, nano e pro), o3, o3-pro | Modelli gpt-5.6 |
| 14/1/2027 | gpt-4o, gpt-4o-mini, gpt-4.1, gpt-4.1-mini | gpt-6-luna |
| 1/4/2027 | gpt-5.1, gpt-5.3-codex, gpt-5.4-nano | — |
Il 30 novembre 2026 spariscono anche i prompt riutilizzabili (v1/prompts), Evals e Agent Builder. Dal 6 gennaio 2027 i clienti esistenti non potranno più avviare nuovi job di fine-tuning (OpenAI). Altri fornitori si comportano allo stesso modo: Anthropic promette "at least 60 days' notice" e ritira claude-sonnet-4-5 il 30 novembre 2026 (Anthropic). Con un modello open-weight in azienda, invece, è l'azienda a decidere quando cambiarlo. Ho analizzato i costi dei cambi forzati nell'articolo sul vendor lock-in nell'AI.
Quanto costano oggi le API OpenAI rispetto a un LLM locale?
I modelli piccoli di OpenAI costano poco, e con volumi bassi il locale raramente conviene. Il conto cambia con i contesti lunghi, con i livelli prioritari e con volumi alti e costanti. La tabella riporta i prezzi Standard per contesti fino a 272K token, consultati il 28/10/2026 sulla pagina prezzi di OpenAI:
| Modello | Input ($/M token) | Input in cache | Output |
|---|---|---|---|
| gpt-6-luna | 0,10 | 0,01 | 0,50 |
| gpt-6.1-terra | 1,00 | 0,05 | 5,00 |
| gpt-6-sol | 2,00 | 0,20 | 10,00 |
| gpt-5.6-sol | 4,00 | 0,40 | 20,00 |
| gpt-6-astra | 10,00 | 1,00 | 50,00 |
Sulla stessa pagina si trovano altre condizioni:
- oltre 272K token di contesto i prezzi circa raddoppiano: gpt-6-sol passa a 4 $ in input e 15 $ in output;
- Fast, il nuovo nome di Priority, costa il doppio dello Standard;
- gli endpoint regionali aggiungono il 10% per i modelli idonei usciti dal 5 marzo 2026;
- Batch e Flex costano la metà dello Standard.
OpenAI indica il prezzo promozionale di gpt-5.6-sol come valido almeno fino al 21 novembre 2026: dopo quella data va ricontrollato. Anche Google raddoppia i prezzi: Gemini 4 Argon dal 1° dicembre 2026, i modelli Flash dal 1° gennaio 2027 (Google). Ne parlo nell'articolo sui prezzi delle API di Gemini.
I listini cambiano, quindi ogni confronto va rifatto con i prezzi del giorno e i propri volumi reali. Il metodo completo è nella pagina sui costi dell'AI in locale.
Quali dati restano da OpenAI, per quanto tempo, e cosa cambia con un LLM locale?
Per impostazione predefinita le API non usano i dati per l'addestramento: "data sent to the OpenAI API is not used to train or improve OpenAI models", salvo adesione esplicita. Alcuni dati però vengono conservati (OpenAI):
| Dato | Conservazione | Zero Data Retention |
|---|---|---|
| Log antiabuso | "for up to 30 days, unless longer retention is required by law" | — |
/v1/responses | 30 giorni di default | — |
| Prompt caching | Fino a 24 ore | — |
/v1/files, /v1/vector_stores, /v1/conversations, /v1/batches, fine-tuning | Fino alla cancellazione | Non idonei |
Anche con la Zero Data Retention, il materiale sospetto di abuso su minori viene conservato per una revisione umana. Con la Safety Retention, i contenuti segnalati possono essere conservati e rivisti. L'endpoint UE eu.api.openai.com richiede l'approvazione MAM o ZDR e l'emendamento Modified Retention. Restano comunque esclusi i dati di sistema, come account, metadati e fatturazione (OpenAI).
Due episodi recenti, riportati da fonti secondarie, mostrano dove nasce il problema. Secondo WMAR-2 News, al Johns Hopkins Bayview sono stati coinvolti circa 3.182 pazienti. Un dipendente aveva caricato un foglio di calcolo su uno strumento AI pubblico non approvato. Secondo Tech Times UK, il servizio 302.ai, gestito da una società di Hong Kong, ha lasciato oltre 144.000 log di chat su uno storage Azure pubblico, chiuso l'8 settembre 2026. In nessuno dei due casi la causa indicata è il modello in sé.
Un LLM locale elimina il passaggio dei dati verso un fornitore esterno, ma non è sicuro in automatico. Secondo la documentazione di vLLM, --api-key protegge solo /v1, /v2 e /inference, mentre endpoint come /invocations restano senza autenticazione. Servono una rete isolata, un'autenticazione davanti al server e i log degli accessi. Per l'analisi dei rischi è utile il documento sugli LLM pubblicato nel programma di esperti dell'EDPB (aprile 2025). Non è una posizione ufficiale del comitato. Gli obblighi che restano in ogni caso sono nella pagina su AI e GDPR.
Quali modelli open-weight possono sostituire GPT, e come si verifica la qualità?
Esistono candidati per diverse taglie di hardware, ma la qualità va misurata sui propri casi d'uso. Ecco alcuni modelli arrivati di recente su Ollama, secondo le note di rilascio:
| Modello | Parametri | Contesto | Note |
|---|---|---|---|
| Recursive Flint | 40B MoE, circa 2,5B attivi | 262K | Apache 2.0; v0.40.8, su Linux e Windows dalla v0.40.9 |
| Nemotron 3.5 Bolt | 74B, 9B attivi | — | Pensato per una GPU NVIDIA da 24 GB |
| Nemotron 3.5 Super | 120B, 12B attivi | 1M | v0.40.5 |
Per Flint, Recursive dichiara il 54,9% su Terminal-Bench 2.1 e il 74,2% su SWE-bench Verified (Ollama). Sono numeri del produttore: aiutano a scegliere cosa provare, ma non bastano per decidere. Mistral Large 4 è in anteprima, con la dicitura "Open weights are coming soon" e senza licenza indicata (Mistral). Meglio non pianificare una migrazione su pesi che non si possono ancora scaricare, e verificare la licenza di ogni modello.
Per la verifica servono quattro elementi:
- un set di prova ricavato dai casi reali, con i dati anonimizzati;
- gli stessi prompt inviati al modello attuale e ai candidati locali;
- criteri scritti prima del test: correttezza, formato, tempi di risposta;
- una revisione umana sui casi in cui un errore costa davvero.
Quando conviene restare sulle API OpenAI invece di migrare?
Il cloud resta spesso la scelta più sensata in tre casi: volumi bassi o irregolari, bisogno di capacità di frontiera, mancanza delle competenze per gestire un server. gpt-6-luna costa 0,10 $ in input e 0,50 $ in output per milione di token, e il Batch costa la metà (OpenAI, consultata il 28/10/2026). Con questi prezzi, sui piccoli volumi un server proprio difficilmente conviene. Le competenze sono un limite reale. Secondo l'ISTAT, consideriamo le imprese con almeno 10 addetti che hanno valutato l'AI senza adottarla: il 58,6% indica competenze insufficienti, il 43,2% privacy e protezione dei dati, il 43,0% costi elevati.
Spesso la strada più ragionevole è intermedia: i flussi sensibili restano sul server interno, quelli generici vanno in cloud, con la stessa interfaccia compatibile. Ne parlo nell'articolo su come integrare un'AI privata con ERP e CRM. In entrambi i casi serve una governance. Il D.Lgs. 179/2026, in vigore dal 23 ottobre 2026, designa AgID e ACN come autorità nazionali per l'AI.
Da dove partire con la migrazione dalle API OpenAI?
Quando affianco un'azienda in questa valutazione parto dall'inventario:
- Inventario. Per ogni applicazione si elencano modelli, endpoint e parametri usati, con le date della pagina delle deprecazioni.
- Classificazione. I flussi si ordinano per sensibilità dei dati e volume di token. Quelli sensibili e voluminosi sono i primi candidati al locale.
- Pilota su un solo flusso. Si usa Ollama o vLLM, con un alias per non toccare il nome del modello nel codice (Ollama). Davanti al server serve un'autenticazione propria, perché
--api-keynon basta (vLLM). - Confronto. Qualità e costo si misurano sul set di prova. Se i risultati non reggono, serve un piano pronto per tornare in cloud.
- Regole d'uso. Accessi, registri, policy e formazione riducono il rischio di casi come il foglio caricato su uno strumento non approvato.
Vuoi capire quali flussi conviene spostare e quali lasciare in cloud? Puoi partire dalla valutazione: guardiamo insieme volumi, dati e scadenze, senza vendere hardware né licenze.
Domande frequenti
Posso usare OpenAI e un modello locale nella stessa applicazione?
Sì. Ollama e vLLM espongono endpoint compatibili con quelli di OpenAI. La stessa applicazione può quindi mandare i flussi con dati sensibili al server interno e gli altri alle API cloud, cambiando solo indirizzo e modello. Servono però regole chiare su quale dato va dove e un controllo dei parametri che il server locale non supporta.
Cosa succede ai miei modelli fine-tuned su OpenAI?
Secondo la pagina delle deprecazioni di OpenAI, dal 6 gennaio 2027 i clienti esistenti non potranno avviare nuovi job di fine-tuning. Alcuni modelli fine-tuned vengono inoltre spenti insieme ai modelli di base. Conviene conservare i dataset di addestramento e di valutazione, che si possono riutilizzare anche con un modello open-weight.
Serve un server con molte GPU per fare una prima prova?
Non sempre. Alcuni modelli recenti sono pensati per hardware contenuto: secondo le note di rilascio di Ollama, Nemotron 3.5 Bolt è pensato per una GPU NVIDIA da 24 GB. Per un pilota su un solo flusso spesso basta una macchina dedicata. Il dimensionamento per la produzione dipende da utenti contemporanei, lunghezza del contesto e tempi di risposta richiesti.
Gli embedding e la knowledge base vanno rifatti se cambio modello?
In genere sì. I vettori generati da modelli di embedding diversi non sono confrontabili, quindi cambiando modello i documenti vanno indicizzati di nuovo. Conviene tenere a portata di mano i documenti originali e una procedura di indicizzazione ripetibile. I dati caricati su /v1/files e /v1/vector_stores di OpenAI restano lì finché non vengono cancellati esplicitamente.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Vendor lock-in nell'AI: cosa costa quando il fornitore ritira o cambia il modello che usi
I fornitori di AI ritirano i modelli con preavvisi da 45 giorni a 6 mesi, e i sostituti possono costare molto di più. Come stimare il costo del vendor lock-in AI e come ridurlo con modelli open-weight e un'architettura che non dipenda da un solo fornitore.
Integrazione con ERP, CRM e migrazione API10 min
Come integrare un'intelligenza artificiale privata con ERP, CRM e software aziendali
Collegare un'AI a ERP, CRM e gestionali: casi d'uso da cui partire, come funzionano connettori e Model Context Protocol, quanto costano le soluzioni dei fornitori e quali controlli servono per tenere i dati in azienda.
Integrazione con ERP, CRM e migrazione API9 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min