Mistral Large 4: cos'è, quanto costa e si può usare in azienda anche in locale?
Mistral Large 4 è un modello da circa 1.000 miliardi di parametri con i pesi scaricabili e API a 0,70 $ per milione di token in ingresso. Vediamo prezzi, dati, licenza e quale hardware serve davvero per usarlo in azienda in locale.
 Giulio PessioneAI in locale e on-premise11 min
Pubblicato il
Mistral Large 4 è il modello di punta di Mistral AI: ha circa 1.000 miliardi di parametri e un contesto da 1 milione di token, e i pesi si possono scaricare dal 29 ottobre 2026 con una licenza che permette l'uso interno e commerciale (Mistral, The Next Web, LICENSE). Via API costa 0,70 $ per milione di token in ingresso e 2,10 $ in uscita, e di default i dati sono ospitati nell'UE (scheda docs, Help Center). In locale anche il file più compresso pesa circa 298 GB, quindi servono almeno 512 GB di memoria unificata oppure un nodo con più GPU da data center (ggml-org). Ha senso per agenti e documenti lunghi; per i compiti ripetitivi di solito basta un modello più piccolo.
Cos'è Mistral Large 4, e cosa è confermato a fine ottobre 2026?
Mistral Large 4 è il modello più grande della francese Mistral AI. È stato addestrato da zero su infrastruttura europea e si può far girare on-premise (Mistral). La preview è uscita il 6 ottobre. I pesi, annunciati per il 27 ottobre, sono arrivati il 29 (The Next Web, 6 ottobre, The Next Web, 29 ottobre).
L'architettura è a "miscela di esperti" (MoE): per ogni token il modello usa solo una parte dei parametri. I dati principali:
- 1,05 mila miliardi di parametri totali, di cui 52 miliardi attivi per token (49 senza embedding e strati di uscita) (scheda docs, Hugging Face);
- 128 esperti, 4 attivi per token più 1 condiviso (Hugging Face);
- contesto da 1 milione di token: legge testo e immagini, ma risponde solo in testo (Hugging Face);
- tre livelli di ragionamento: Low, Medium e High, che è il predefinito (Mistral);
- function calling, output strutturati, batch e agenti (scheda docs).
Due punti restano da chiarire. La scheda nella documentazione indica la versione v26.10 come «Public Preview» e riporta due identificativi diversi, mistral-large-4+1 e mistral-large-4-0: prima di scrivere codice va verificato quale vale. La pagina su Hugging Face parla di «160+ languages», ma il tag della stessa pagina ne indica 39 e la differenza non è spiegata. L'italiano va quindi provato sui propri testi.
Quanto costa Mistral Large 4 via API rispetto a GPT-6.1 e agli abbonamenti?
Il listino di Mistral Large 4 prevede 0,70 $ per milione di token in ingresso, 0,07 $ per i token in cache e 2,10 $ in uscita (Mistral, scheda docs). Ho consultato le pagine il 31/10/2026, e i listini cambiano. I dati però non tornano del tutto: una FAQ della pagina prezzi indica ancora 0,5 $ e 1,5 $ per un «Mistral Large» non specificato, e il 29 ottobre The Next Web scriveva che i prezzi non erano ancora pubblicati. Prima di fare un budget conviene controllare il prezzo nella console.
Il batch costa il 50% in meno e la cache fa risparmiare fino al 90% (pricing Mistral). Questo è il confronto con OpenAI per richieste con input fino a 272.000 token (pricing OpenAI, consultato il 31/10/2026):
| Modello | Ingresso ($/M token) | Cache ($/M token) | Uscita ($/M token) |
|---|---|---|---|
| Mistral Large 4 | 0,70 | 0,07 | 2,10 |
| gpt-6.1-terra | 1,00 | 0,05 | 5,00 |
| gpt-6.1-sol | 2,00 | 0,10 | 10,00 |
| gpt-6-astra | 10,00 | 1,00 | 50,00 |
Sopra quella soglia Terra sale a 2 $ in ingresso e 7,50 $ in uscita. OpenAI applica anche un sovrapprezzo del 10% per l'elaborazione regionale sui modelli rilasciati dal 5 marzo 2026 (pricing OpenAI).
Il prezzo a token, da solo, non basta per scegliere: lo riconosce anche Pierre Stock di Mistral, che a The Next Web lo definisce potenzialmente fuorviante. Nel mio lavoro guardo quanto costa un compito finito. Mistral dichiara il 47% di token in meno per compito sul Coding Agent Index (Mistral): è un dato del fornitore, misurato sul codice.
Per l'uso diretto, Mistral vende Pro a 14,99 $ al mese, Team a 24,99 $ per utente al mese IVA esclusa ed Enterprise su richiesta, con audit log, SAML SSO e deployment privati o on-premise (pricing Mistral). In un flusso come quello dell'esempio la fascia di modello pesa più della scelta del fornitore: ne parlo in modelli AI piccoli o di frontiera e nella pagina sui modelli di frontiera in azienda.
Cosa dicono i benchmark di Mistral Large 4, e quanto fidarsi?
I numeri mettono Large 4 tra i modelli competitivi nei compiti da agente e nel codice, ma vengono quasi tutti dal fornitore, e TechCrunch non riporta verifiche indipendenti.
Secondo Mistral:
- Terminal-Bench 4.0: 41%, contro il 28% della preview;
- Coding Agent Index di Artificial Analysis: 48%, alla pari con GLM-5.3;
- BrowseComp: 84,5%; B3 Agent Security: 97,1%;
- nei confronti alla cieca di Surge Code è secondo solo a Claude Opus 5.5.
Sull'Intelligence Index v5 di Artificial Analysis fa 26 punti: il massimo tra gli open-weight occidentali, ma sotto i migliori open-weight cinesi, come riconosce la stessa pagina su Hugging Face. Per un confronto c'è l'articolo su Kimi K3.1 Pro.
Un benchmark sul codice non dice come il modello risponde in italiano a un cliente, né come estrae le condizioni da un contratto. Per decidere conta il test sui propri casi.
Dove finiscono i dati aziendali usando Mistral Large 4 con le API e le app di Mistral?
Di default i dati sono ospitati nell'Unione europea. A seconda della funzione, però, possono essere trasferiti temporaneamente a sub-responsabili, anche in Paesi senza decisione di adeguatezza, con clausole contrattuali standard. Con l'endpoint USA restano negli Stati Uniti, e nel piano Enterprise si possono disattivare alcune funzioni che comportano trasferimenti fuori UE (Help Center, 12/08/2026).
Le regole sull'addestramento cambiano da prodotto a prodotto (Help Center, 03/09/2026):
| Prodotto | Uso dei dati per l'addestramento |
|---|---|
| Enterprise | escluso di default |
| Vibe individuale (nome usato dal Help Center) | non escluso di default |
| API e Studio | si disattiva con l'interruttore «Anonymous improvement data»; il valore predefinito per l'API non è indicato |
Prima di inviare dati reali va controllato quell'interruttore nelle impostazioni dell'organizzazione.
La conservazione zero dei dati vale solo sui piani a pagamento e per le chiamate stateless, va chiesta motivandola e Mistral può rifiutarla. Sono esclusi, tra gli altri, Agents, Batch, Conversations, Libraries e Chat (docs ZDR). Chi usa il batch per risparmiare il 50% rinuncia quindi alla conservazione zero su quelle chiamate.
Un'alternativa è Microsoft Foundry, che Mistral indica come primo cloud provider con deployment privato su Azure: lì valgono le condizioni del contratto con Microsoft, da verificare a parte. I controlli da fare sono in impostazioni privacy delle API AI; perché la sede europea del fornitore non risolve tutto, nell'articolo sulla sovereign AI.
Cosa serve per far girare Mistral Large 4 in locale?
Serve un nodo con più GPU da data center. Le versioni più compresse stanno in una macchina con 512 GB di memoria unificata, ma con qualità e velocità non dichiarate. Mistral non pubblica requisiti hardware ufficiali (Mistral), quindi si parte dalle dimensioni dei file GGUF pubblicati da ggml-org (Hugging Face): 2,10 TB in BF16, 1,12 TB in Q8_0, 635 GB in Q4_K_M, 381 GB in Q2_K e 298 GB in IQ2_XXS. Per le ultime due la pagina scrive «Fits in 512 GB of unified memory», senza dire quanta qualità si perde con una compressione così spinta.
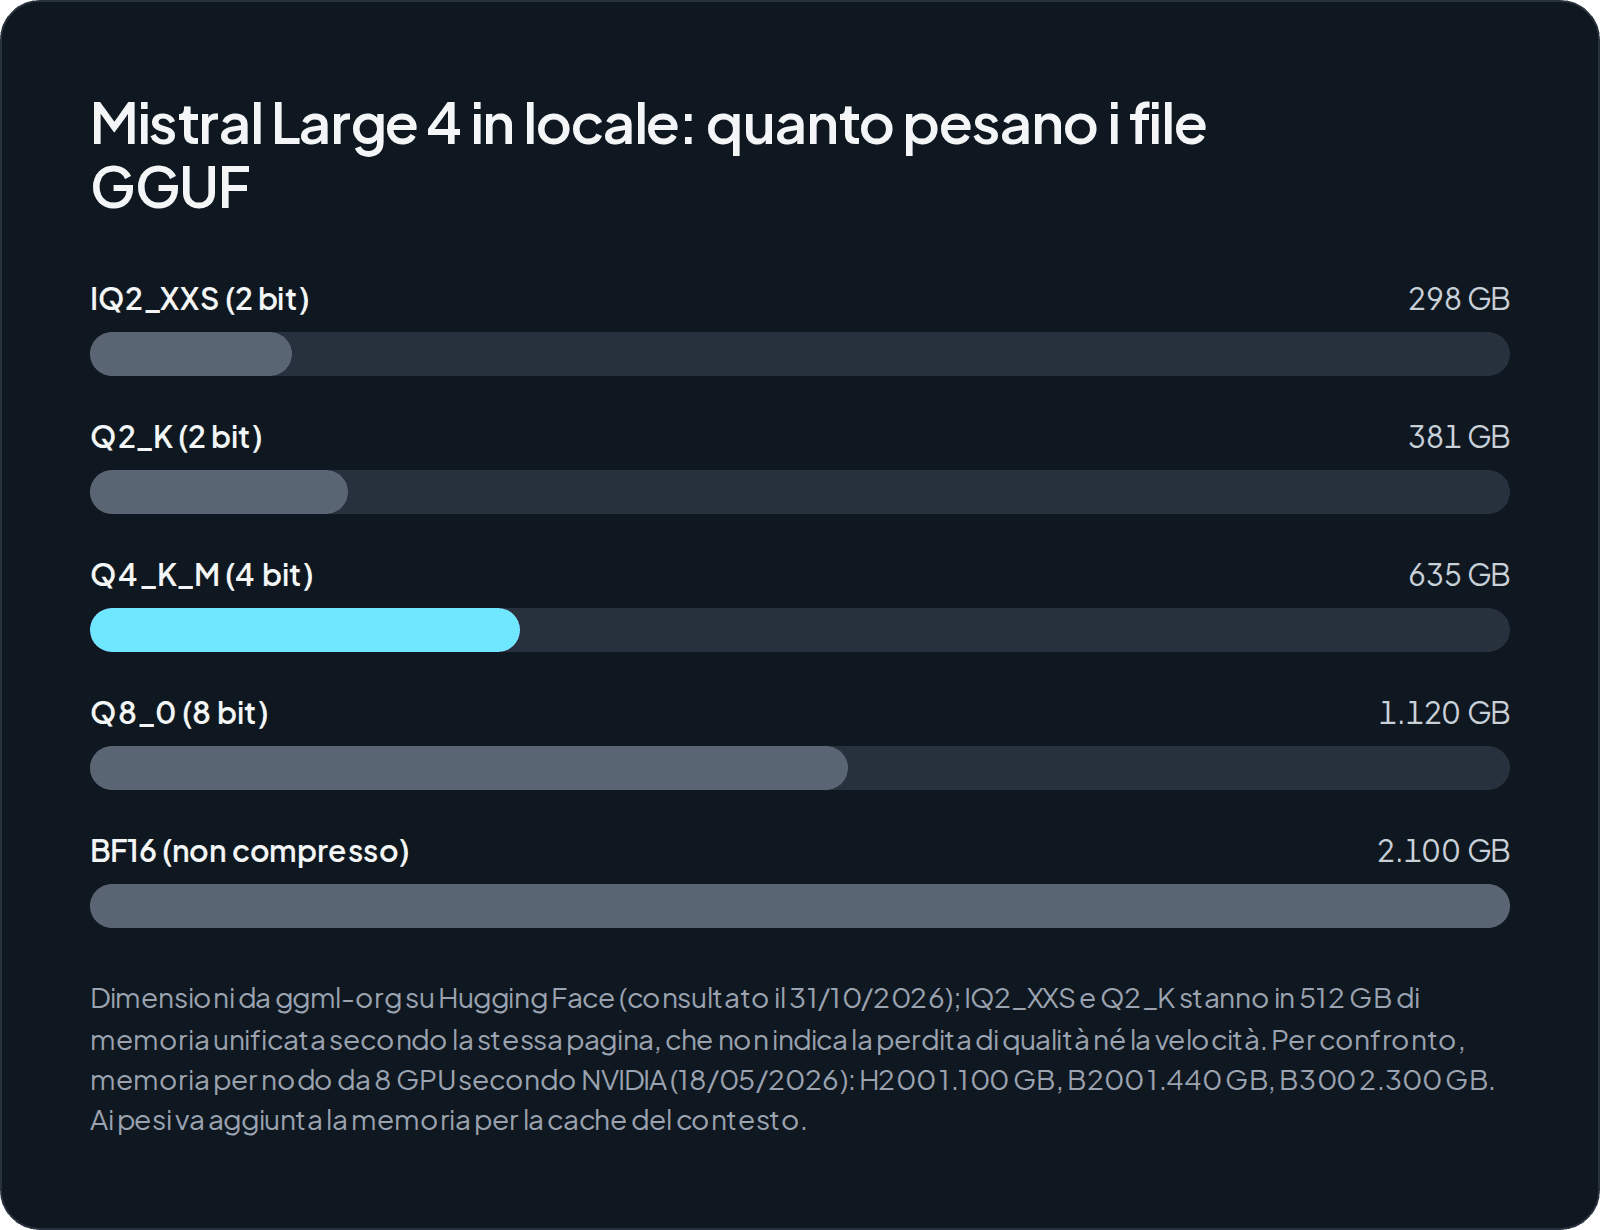
Per l'uso con più utenti, la pagina ufficiale mostra esempi con vLLM e SGLang su un nodo da 8 GPU, senza dire quale modello di GPU. I pesi sono in FP8, con un checkpoint NVFP4 per le GPU Blackwell. Questa è la memoria dei nodi da 8 GPU secondo NVIDIA (pagina del 18/05/2026):
| Nodo da 8 GPU | Memoria per GPU | Memoria per nodo |
|---|---|---|
| H200 | 141 GB | 1,1 TB |
| B200 | 180 GB | 1,44 TB |
| B300 | 288 GB | 2,30 TB (2,1 TB sulla pagina prodotto) |
Secondo The Next Web, la versione quantizzata gira su quattro B200 o B300.
Una macchina compatta come la DGX Spark va confrontata con i 298 GB del file più piccolo. Le versioni ridotte, compresa una per laptop, arriveranno «nei prossimi mesi» secondo The Next Web, ma senza date non si possono mettere in un piano. Come si dimensiona un progetto di questo tipo lo spiego nelle pagine su AI on-premise e sui costi dell'AI in locale.
Cosa permette la licenza di Mistral Large 4, e quando serve un accordo commerciale?
La Mistral Ecosystem Open-Weight License è una «MIT modificata»: consente uso, modifica, fine-tuning e uso commerciale (Mistral). Serve una licenza commerciale separata solo per offrire il modello come servizio, in modalità MaaS (LICENSE).
Il testo della licenza considera MaaS dare a terzi accesso al modello o ai derivati lasciando loro un «controllo significativo» su input, parametri o dati di addestramento. Non lo sono un prodotto per utenti finali che incorpora funzioni AI, l'inoltro di richieste a modelli ospitati da altri, l'uso interno e l'uso tramite i prodotti Mistral. Non ci sono soglie di fatturato o di utenti, e il modello è fornito «AS IS», senza garanzie. Un gruppo che lo mette a disposizione delle consociate, o una software house che lo offre ai clienti con accesso diretto, dovrebbe farlo valutare a un legale.
Il vantaggio dei pesi in casa è preciso: secondo Pierre Stock, intervistato da TechCrunch, l'accesso «can't be cut off by definition». La copia scaricata resta all'azienda anche se il fornitore ritira o cambia il modello via API. Cosa costa quando succede il contrario lo trovi in vendor lock-in nell'AI.
Per quali processi aziendali ha senso Mistral Large 4, e quando conviene un'altra scelta?
Mistral Large 4 è un candidato da provare per agenti, documenti lunghi e analisi complesse, soprattutto se si preferisce un fornitore europeo o si vuole poter portare il modello in casa. Per classificazioni, estrazioni di campi e smistamenti ripetitivi di solito bastano modelli più piccoli, che costano meno via API e in locale.
- Via API può convenire quando i volumi variano o nessuno può gestire un server, leggendo bene le esclusioni della conservazione zero.
- In locale può convenire quando i dati non devono uscire e i volumi sono alti e stabili, ma il nodo multi-GPU è un investimento importante: per molti processi è più sensato un open-weight più piccolo su hardware meno costoso.
- I modelli di frontiera dei grandi fornitori possono restare la scelta migliore per i compiti più difficili (su Surge Code Claude Opus 5.5 resta davanti, secondo Mistral) o se si lavora già in una suite che integra l'AI.
Il locale non toglie gli obblighi verso le persone. In un provvedimento sulla Provincia autonoma di Trento, il Garante ha chiesto misure per «l'effettivo esercizio dei diritti di rettifica e cancellazione», «indipendentemente dal sistema o dal modello di intelligenza artificiale utilizzato» (provv. n. 760 del 7/10/2026). Permessi, registri, policy e formazione servono in ogni caso: ne parlo nella pagina su AI e GDPR.
Chi usa Mistral Large 3 (mistral-large-2512) ha una scadenza: è deprecato dal 31 ottobre 2026 e verrà ritirato il 30 aprile 2027, con Large 4 indicato come sostituto (docs). È il momento per chiedersi se passare tutto a Large 4 o scegliere un modello per ogni passaggio del flusso, il lavoro che faccio nella consulenza per i processi.
Da dove partire per valutare Mistral Large 4 in azienda?
Si parte da un processo concreto e da un test misurabile. Al server si pensa dopo, e solo se i numeri lo giustificano.
- Scegli un processo e prepara da 30 a 50 casi reali anonimizzati: email, ordini, contratti, ticket.
- Provalo via API con l'addestramento disattivato, misurando token per compito, qualità e differenza tra i livelli Low, Medium e High.
- Confrontalo sugli stessi casi con un modello più piccolo e con un modello di frontiera di un altro fornitore.
- Stima il costo del locale su più anni, solo se dati o volumi lo richiedono.
- Fai verificare la licenza se il modello andrà a società collegate o a clienti.
Se vuoi fare questi conti sui tuoi processi, puoi partire dalla valutazione. Se il locale risulta sensato, posso fornire server e software già configurati: assistente sui documenti, agenti, integrazioni con ERP e CRM. Se invece i numeri dicono API, te lo dico.
Domande frequenti
Chi usa Mistral Large 3 via API deve passare a Large 4?
Sì, entro la data di ritiro. Mistral ha deprecato Large 3 (mistral-large-2512) il 31 ottobre 2026, lo ritirerà il 30 aprile 2027 e indica Large 4 come sostituto. Il cambio va comunque testato: prezzi, consumo di token e comportamento delle risposte possono cambiare.
Mistral Large 4 funziona bene in italiano?
Mistral scrive che il modello parla in modo nativo oltre 160 lingue, comprese tutte quelle ufficiali dell'UE, ma il tag su Hugging Face ne indica 39 e la differenza non è spiegata. Non ci sono dati pubblici specifici sull'italiano: conviene provarlo su email, contratti e documenti propri.
Esistono versioni più piccole di Mistral Large 4 da usare su un PC?
Non ancora. Secondo The Next Web arriveranno versioni più piccole, tra cui una per laptop, «nei prossimi mesi», ma senza date. Mistral parla anche di varianti specializzate per la sicurezza informatica tramite Forge. Oggi le versioni GGUF già pubblicate partono da circa 298 GB.
Si può usare Mistral Large 4 su Azure invece che sui server di Mistral?
Sì. Mistral indica Microsoft Foundry come primo cloud provider con deployment privato su Azure. In quel caso le condizioni su conservazione, area di elaborazione e accessi sono quelle del contratto con Microsoft, da verificare a parte.
Mistral Large 4 ha protezioni contro gli usi malevoli nella sicurezza informatica?
Mistral dichiara che il modello rifiuta in media il 96,6% delle richieste cyber malevole e che ottiene il 97,1% su B3 Agent Security. Sono dati del fornitore, senza verifiche indipendenti pubblicate. Con i pesi in casa, poi, i controlli sull'uso spettano all'azienda.
Chi scrive
Consulente AI per PMI
Lavoro da circa due anni nel settore dell'intelligenza artificiale in ambito commerciale: processi di vendita, assistenza clienti, qualificazione dei contatti e automazione. Aiuto le aziende a capire dove l'AI crea valore e fornisco quello che serve per portarla nei processi: server per l'AI in locale, già configurati, e software come assistenti sui documenti, agenti e integrazioni con i programmi aziendali.
Da leggere dopo
Kimi K3.1 Pro: il modello open-weight da 1 milione di token si può usare in azienda, anche in locale?
Kimi K3.1 Pro di Moonshot AI si avvicina a Claude Opus 5.5 nei benchmark e costa meno via API. I dati però passano da Singapore, e i pesi annunciati per il 4 novembre richiedono hardware da data center. Ecco cosa sapere prima di usarlo in azienda.
AI in locale e on-premise9 min
Sovereign AI: cos'è la sovranità dell'intelligenza artificiale e perché interessa alle aziende europee
Sovereign AI non è solo uno slogan politico: per un'azienda significa sapere chi controlla dati, modelli e infrastruttura. Le iniziative europee, il nodo del CLOUD Act e i livelli di sovranità possibili, con i loro compromessi.
Privacy, GDPR e sovranità dei dati8 min
Vendor lock-in nell'AI: cosa costa quando il fornitore ritira o cambia il modello che usi
I fornitori di AI ritirano i modelli con preavvisi da 45 giorni a 6 mesi, e i sostituti possono costare molto di più. Come stimare il costo del vendor lock-in AI e come ridurlo con modelli open-weight e un'architettura che non dipenda da un solo fornitore.
Integrazione con ERP, CRM e migrazione API10 min