NVIDIA DGX Spark in azienda: quanto costa davvero, quali modelli regge e quando conviene rispetto alle API
La DGX Spark da 128 GB è salita a 6.950 $ e quella da 64 GB parte da 4.999 $. Vediamo quali modelli regge, cosa NVIDIA non dichiara, quanto costa rispetto ad API e abbonamenti e quando il cloud resta la scelta più sensata.
Pubblicato il
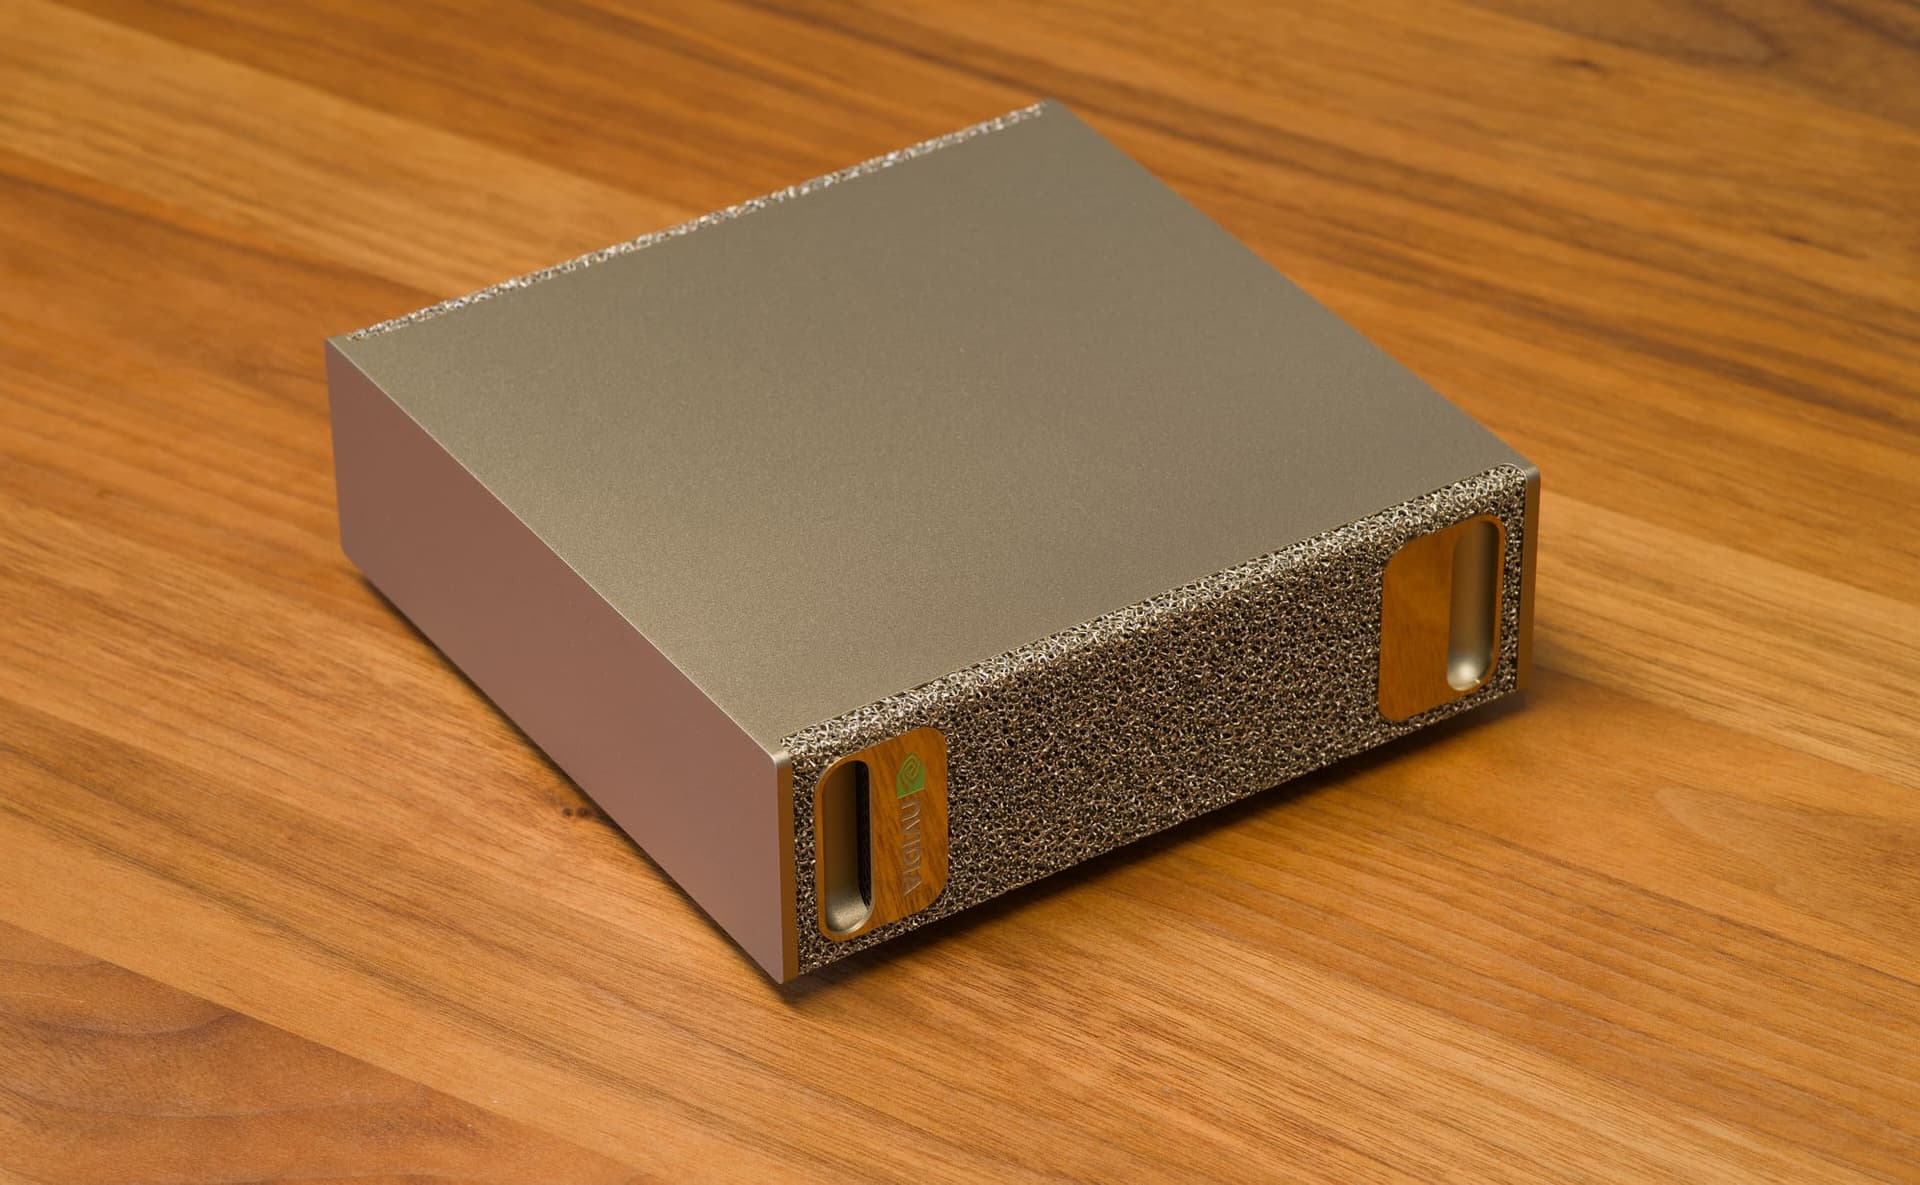
Per le aziende, la NVIDIA DGX Spark da 128 GB costa oggi 6.950 $, quasi il 75% in più di un anno fa. La nuova versione da 64 GB parte da 4.999 $ e si compra solo tramite partner OEM (The Register). NVIDIA dichiara che la 128 GB carica modelli fino a 200 miliardi di parametri (NVIDIA), ma non quante persone può servire contemporaneamente (blog NVIDIA). Rispetto alle API può convenire quando i dati sono riservati e un gruppo ristretto la usa molto. Con pochi utenti e volumi bassi, spesso le API costano meno.
Quanto costa una DGX Spark per le aziende oggi, versione per versione?
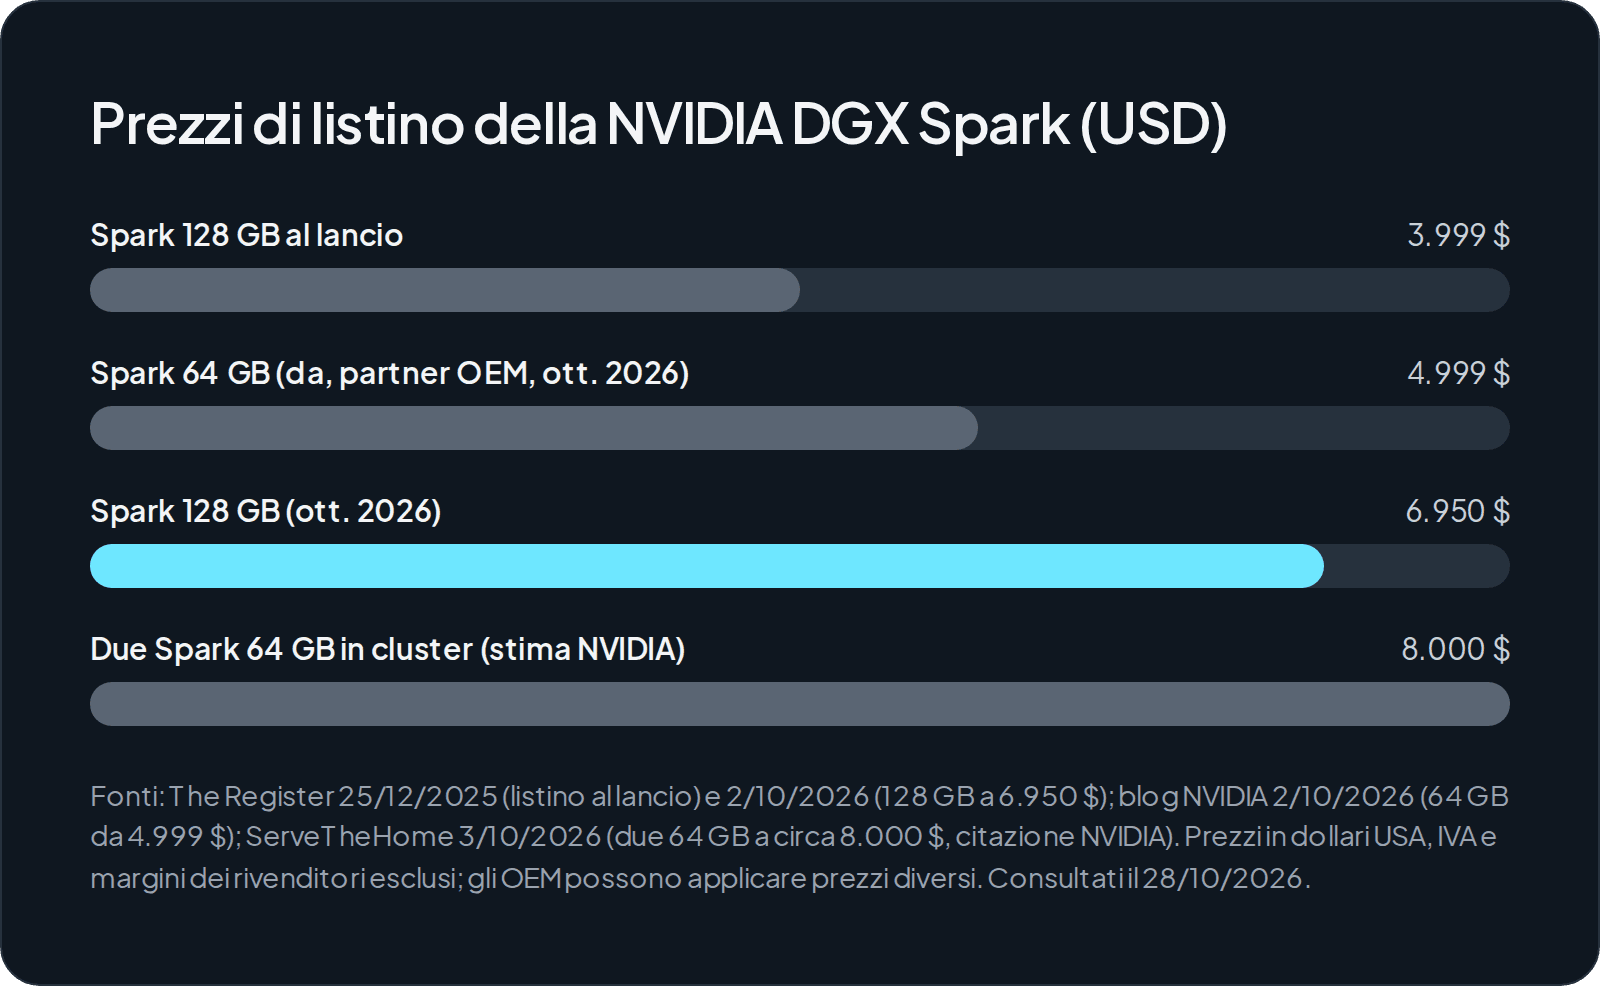
La versione da 128 GB costa 6.950 $. A dicembre 2025 il listino era di 3.999 $ (The Register, 25 dicembre 2025), e The Register attribuisce il rincaro all'aumento dei prezzi della memoria (The Register, 2 ottobre 2026).
La novità è la versione da 64 GB, con metà della memoria e metà dello storage. Parte da 4.999 $ e dal 23 ottobre si compra solo tramite Acer, ASUS, Dell, Gigabyte, HP e MSI (blog NVIDIA). Costa quindi il 25% in più della 128 GB al momento del lancio (The Register).
Restano alcuni punti aperti. La pagina prodotto di NVIDIA non riporta prezzi (NVIDIA). ServeTheHome non sa se i 4.999 $ si riferiscano alla configurazione con 1 TB o con 4 TB di storage, e non indica i prezzi che i partner applicano alla 128 GB (ServeTheHome).
| Versione | Memoria | Prezzo indicato dalle fonti | Indicativo in euro | Dove si compra |
|---|---|---|---|---|
| DGX Spark 128 GB | 128 GB | 6.950 $ (The Register) | circa 6.233 € | anche tramite OEM, con prezzi propri (ServeTheHome) |
| DGX Spark 64 GB | 64 GB | da 4.999 $ (NVIDIA) | circa 4.483 € | solo Acer, ASUS, Dell, Gigabyte, HP, MSI |
| Due 64 GB in cluster | 128 GB totali | circa 8.000 $, stima NVIDIA (ServeTheHome) | circa 7.175 € | due unità dagli stessi partner |
Sono prezzi in dollari riportati dalle fonti consultate il 28 ottobre 2026, e possono cambiare. Per la conversione ho usato il cambio di riferimento BCE del 27 ottobre 2026, pari a 1,1150 dollari per euro (BCE). IVA, eventuali dazi e margine dei rivenditori sono esclusi: il prezzo reale va chiesto con un preventivo.
Perché il prezzo è salito, e cosa aspettarsi per i prossimi acquisti di hardware?
Il rincaro dipende dalla memoria, e chi la produce non prevede un riequilibrio a breve. A gennaio TrendForce stimava per la DRAM server un aumento di oltre il 60% nel primo trimestre 2026, e secondo IDC la carenza poteva durare fino al 2027 (The Register, 6 gennaio 2026).
Micron ora sposta l'orizzonte più avanti. L'amministratore delegato Sanjay Mehrotra prevede condizioni "much tighter in calendar 2027 and 2028 than they were in 2026", e oltre il 75% della produzione 2027 è già impegnato (CIO.com). Lo stesso articolo segnala che altre fonti riportano queste dichiarazioni in anni fiscali e non solari. Nel quarto trimestre fiscale 2026 Micron ha registrato ricavi per 54,23 miliardi di dollari, contro gli 11,32 di un anno prima (comunicato Micron alla SEC).
Nessuna di queste fonti dice quanto costerà la Spark tra sei mesi. Le indicazioni pratiche sono tre: mettere a budget un margine sul listino, chiedere preventivi scritti con prezzo bloccato e decidere in base al caso d'uso, senza aspettare un calo che le fonti non prevedono a breve. Le altre voci di costo sono trattate in quanto costa un'AI privata in azienda.
Quali modelli regge davvero una DGX Spark, e per quante persone?
La capienza è dichiarata, la velocità con più utenti collegati no. Secondo NVIDIA un'unità da 64 GB carica modelli fino a 100 miliardi di parametri. Una da 128 GB, oppure due da 64 GB, arrivano a 200 miliardi; due da 128 GB a 400 (NVIDIA).
Caricare un modello non significa usarlo comodamente ogni giorno. Per l'inferenza locale NVIDIA suggerisce modelli da 26 a 35 miliardi di parametri, per esempio Qwen 3.8 27B (The Register). La banda di memoria è di 273 GB/s, mentre il valore di 1 PFLOP in FP4 è teorico e calcolato con la sparsity (NVIDIA).
Due aspetti contano più degli altri:
- la velocità di scrittura della risposta dipende soprattutto dalla banda di memoria. Nel test di The Register la Spark e un sistema AMD Strix Halo, con 273 contro 256 GB/s, generano i token a velocità simile (The Register);
- il tempo prima della risposta dipende dall'elaborazione del prompt. Qui la Spark è 2-3 volte più veloce (The Register), e la differenza si sente quando le domande includono lunghi brani di documenti.
NVIDIA non pubblica né i token al secondo né il numero di utenti contemporanei (blog NVIDIA, NVIDIA Developer). Per saperlo bisogna fare un test con i propri prompt, i propri documenti e più persone collegate.
Anche il software cambia i numeri: secondo NVIDIA il formato NVFP4 occupa circa il 40% di memoria in meno rispetto a FP8 (NVIDIA Developer). La Spark è compatibile con Ollama, vLLM, llama.cpp, LM Studio e PyTorch (blog NVIDIA). Per farla lavorare senza contattare servizi esterni c'è la guida sull'intelligenza artificiale offline.
Due DGX Spark da 64 GB o una da 128 GB: cosa conviene a un'azienda?
In genere conviene una sola unità da 128 GB. Lo consiglia anche ServeTheHome: "a single 128GB node instead of two 64GB nodes" (ServeTheHome).
Due unità da 64 GB costano circa 8.000 $ secondo la stima NVIDIA (ServeTheHome) e si collegano con un cavo QSFP tramite ConnectX-7 a 200 Gb/s (NVIDIA). Su Qwen 3.8 27B rendono "fino a 1,7x" rispetto a una sola, ma NVIDIA non dichiara le condizioni del test (blog NVIDIA). Va preso come un massimo, non come il risultato da aspettarsi.
Il cluster costa più di una 128 GB, che carica gli stessi 200 miliardi di parametri (NVIDIA). In più la 64 GB è meno adatta al fine-tuning (The Register). Con due macchine raddoppiano anche i punti di guasto e gli aggiornamenti. Per un'azienda senza un reparto IT dedicato all'AI è un costo concreto, anche se non compare in fattura.
Quanto costano le API e gli abbonamenti che una DGX Spark potrebbe sostituire?
Con pochi utenti e volumi bassi, spesso le API costano meno della macchina. Il conto cambia quando crescono le persone, l'uso e i listini. Questi sono i prezzi per milione di token che ho consultato il 28 ottobre 2026 sulle pagine ufficiali. I listini cambiano spesso, e quello di OpenAI non riporta una data di aggiornamento:
| Modello | Input | Output | Fonte |
|---|---|---|---|
| Claude Fable 5.1 | 10 $ | 50 $ | Anthropic |
| Claude Sonnet 5.5 | 2 $ | 10 $ | Anthropic |
| Claude Haiku 5.5 (fino a 100K token) | 0,10 $ | 0,50 $ | Anthropic |
| gpt-6-astra | 10 $ | 50 $ | OpenAI |
| gpt-6-sol | 2 $ | 10 $ | OpenAI |
| gpt-6-luna | 0,10 $ | 0,50 $ | OpenAI |
| Gemini 3.8 Flash | 0,75 $, poi 1,50 $ dal 1/1/2027 | 3,75 $, poi 7,50 $ | |
| Gemini 4 Argon | 2 $, poi 4 $ dal 1/12/2026 | 10 $, poi 20 $ |
I rincari di Google sono analizzati in prezzi delle API di Gemini. Claude Team Standard costa 20 $ per utente al mese con fatturazione annuale e 25 $ con quella mensile. Ha limiti d'uso su finestre di 5 ore e un tetto settimanale, e oltre il limite si paga a tariffa API (Anthropic). L'add-on Microsoft 365 Copilot Business costa 21 $ per utente al mese a listino. Fino al 31 dicembre 2026 è in promozione a 18 $ per il primo anno, con impegno annuale (Microsoft).
Il confronto completo su più anni è nella pagina sui costi dell'AI in locale. Se usi già le API in produzione, puoi partire dalla pagina sulla migrazione dalle API.
Dove restano i dati con una DGX Spark, e dove finiscono con le API?
Con la Spark, se l'installazione non contatta servizi esterni, prompt, documenti e risposte restano sulla macchina, che ha fino a 4 TB di storage NVMe con autocrittografia (NVIDIA). Accessi, registri d'uso, backup e regole interne restano però a carico dell'azienda.
Con le API, i dati passano dal fornitore e vi restano secondo le sue regole. Anthropic cancella input e output delle API entro 30 giorni. In caso di violazione delle policy, però, li conserva fino a 2 anni (Anthropic Privacy Center). Google usa i dati per migliorare i prodotti nel livello gratuito di Gemini, ma non in quello a pagamento (Google).
Anche la residenza dei dati si paga. OpenAI applica un sovrapprezzo del 10% agli endpoint con data residency per i modelli rilasciati dal 5 marzo 2026 (OpenAI). Anthropic fa pagare 1,1 volte il prezzo standard l'inferenza limitata agli Stati Uniti (Anthropic). La regione dove stanno i dati, però, non dice a quale giurisdizione è soggetto il fornitore: è il tema di sovereign AI. Avere la macchina in ufficio non basta a rendere l'azienda conforme: gli obblighi restano, come spiego nella pagina su AI e GDPR.
Quando le API o un server più grande convengono più di una DGX Spark?
NVIDIA colloca la Spark tra le workstation (NVIDIA). Da quello che è pubblico, la vedo adatta a sviluppo, prototipi e piccoli gruppi di lavoro, non come server per tutta l'azienda. Le API convengono quando servono modelli di frontiera per compiti complessi, l'uso è saltuario, nessuno ha il tempo di gestire una macchina o serve alta disponibilità. Un server più grande conviene con molti utenti contemporanei, un servizio continuo o più modelli in parallelo: la pagina sull'AI on-premise spiega come si valuta.
Ci sono anche alternative più economiche. I sistemi con AMD Gorgon Halo, con memoria da circa 32 a 192 GB, costano meno della Spark da 128 GB. La GPU GB10 però va meglio nei compiti di AI (The Register). Nel fine-tuning QLoRA di Llama 3.1 70B, la Spark ha impiegato circa 20 minuti. Un sistema HP con AMD Strix Halo ne ha impiegati più di 50 (The Register).
Da dove partire per valutare una DGX Spark in azienda?
- Scegli un caso d'uso circoscritto, per esempio un assistente sui documenti di un reparto come quello descritto in AI sui documenti aziendali, e stima utenti e volumi.
- Misura per un mese quanto spendi oggi in token, API o abbonamenti.
- Prova i modelli da 26-35B sui tuoi documenti, con più persone collegate contemporaneamente.
- Chiedi preventivi scritti in euro, con storage, garanzia e assistenza specificati.
- Definisci le regole prima di accendere la macchina: chi accede, cosa si registra, quali dati si inseriscono e come si formano le persone.
Se vuoi un parere esterno, puoi chiedere una valutazione indipendente. Non vendo hardware né licenze. Ti aiuto a capire se per il tuo caso conviene una Spark, un server più grande o le API.
Domande frequenti
Con una DGX Spark si può fare fine-tuning dei modelli?
Sì, entro certi limiti. In un test di The Register il fine-tuning QLoRA di Llama 3.1 70B ha richiesto circa 20 minuti sulla Spark, contro oltre 50 su un sistema AMD Strix Halo di HP. La versione da 64 GB è meno adatta al fine-tuning: per questo uso conviene la 128 GB.
Quali software si usano sulla DGX Spark per far girare i modelli?
Secondo NVIDIA la Spark è compatibile con Ollama, vLLM, llama.cpp, LM Studio e PyTorch, cioè gli strumenti più diffusi per l'inferenza locale di modelli open-weight. Per un uso aziendale servono anche un'interfaccia di chat, la gestione degli accessi e i registri d'uso.
Esistono alternative più economiche alla DGX Spark?
Sì. I sistemi basati su AMD Gorgon Halo, con memoria da circa 32 a 192 GB, costano meno della Spark da 128 GB. Per un singolo utente la velocità di generazione è simile, perché dipende soprattutto dalla banda di memoria. La Spark però elabora i prompt 2-3 volte più in fretta ed è più forte nei compiti AI.
Il prezzo in dollari della DGX Spark corrisponde a quello che pagherò in Italia?
No. I prezzi pubblicati sono listini in dollari, e la 64 GB si compra solo tramite partner OEM che applicano prezzi propri. Al prezzo convertito al cambio BCE vanno aggiunti IVA, eventuali dazi e il margine del rivenditore. Serve un preventivo scritto che specifichi storage e garanzia.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
Prezzi delle API di Gemini per le aziende: quanto costano davvero e quando conviene un modello open-weight
Le API di Gemini raddoppiano i prezzi di Argon a dicembre 2026 e di Flash a gennaio 2027. Vediamo i listini ufficiali, quanto pesano batch, cache e priorità, dove restano i dati e quando un modello open-weight in azienda conviene davvero.
Costi e TCO12 min
Intelligenza artificiale offline: come utilizzare un LLM senza connessione Internet
Un LLM può funzionare senza connessione Internet, su server o PC aziendali. Spieghiamo cosa serve, come evitare che un'installazione "locale" contatti comunque servizi esterni, quanto costa rispetto alle API e quando conviene restare in cloud.
AI offline e industria8 min