Intelligenza artificiale e GDPR: quando scegliere un modello AI on-premise?
Il GDPR non vieta l'AI in cloud e non premia automaticamente quella in casa. Una guida agli obblighi reali (ruoli, DPIA, sicurezza, trasferimenti, AI Act) e ai criteri per capire quando l'on-premise riduce davvero il rischio.
Pubblicato il
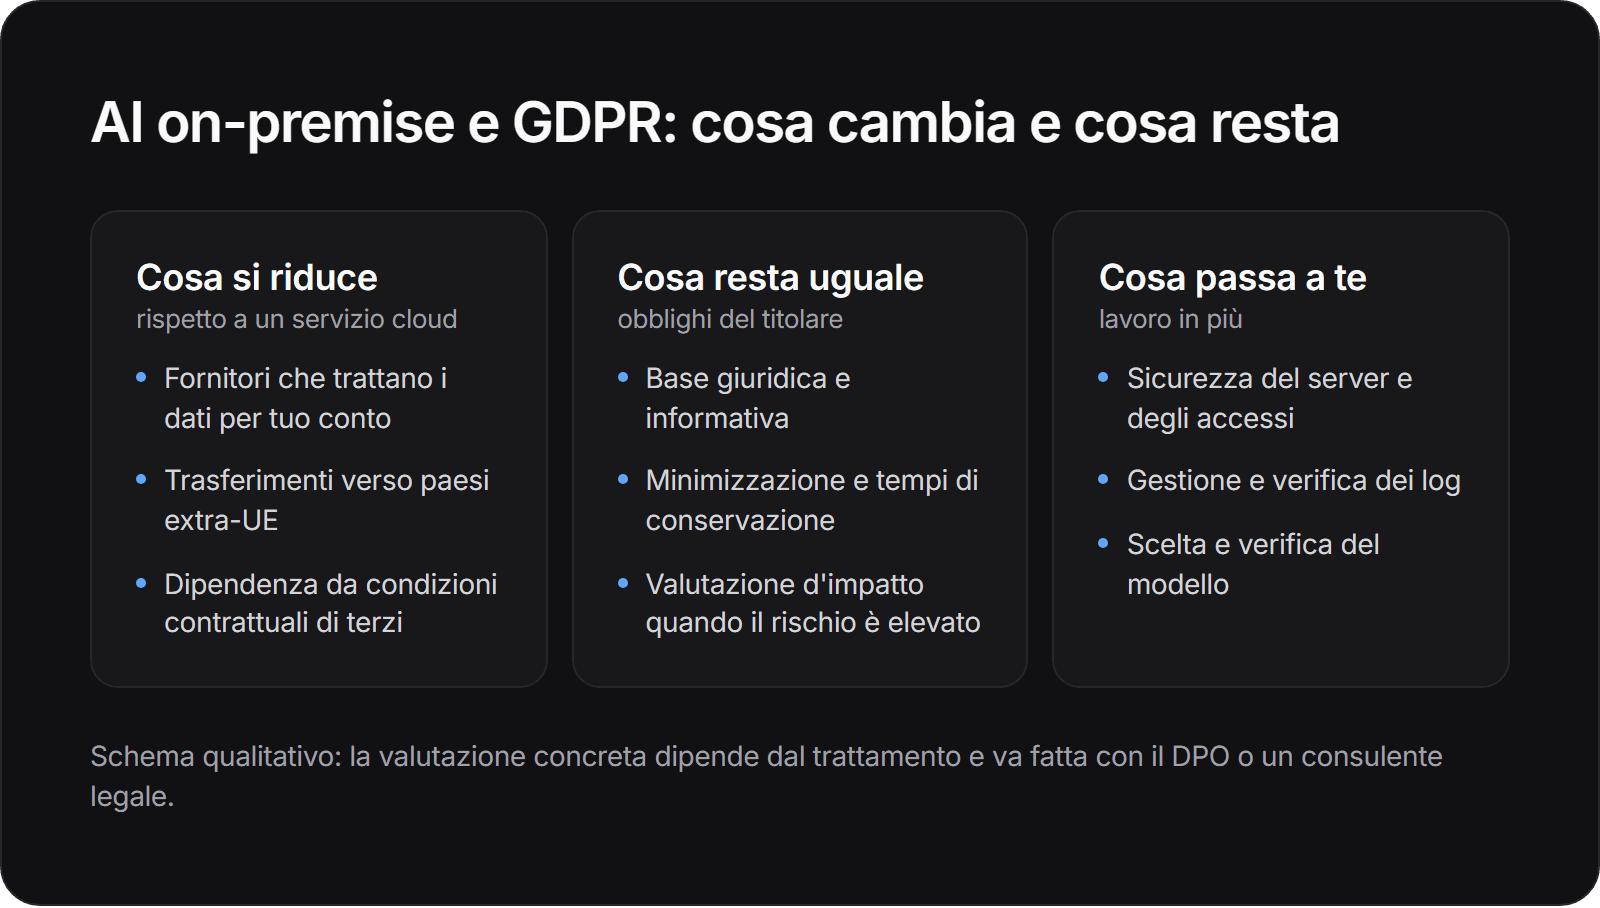
Sul rapporto tra intelligenza artificiale e GDPR il punto di partenza è semplice: il regolamento non vieta l'AI in cloud e non premia automaticamente quella installata in casa. Chiede che l'azienda sappia quali dati personali entrano nel sistema, con quale base giuridica, chi li tratta e con quali misure di sicurezza. Un modello AI on-premise ha senso quando riduce rischi concreti, come dati particolari, vincoli di riservatezza o trasferimenti extra-UE, ma non sostituisce nessuno di questi obblighi.
Cosa chiede il GDPR a chi usa l'intelligenza artificiale in azienda?
Chiede le stesse cose che chiede per qualsiasi altro trattamento di dati personali: l'AI non ha un capitolo a parte nel regolamento. Quello che cambia è la facilità con cui un dipendente può incollare in una chat un contratto, un elenco clienti o una cartella del personale, spesso senza rendersene conto.
Gli obblighi che contano di più in un progetto AI, nel testo del Regolamento UE 2016/679 pubblicato dal Garante Privacy, sono questi:
- Base giuridica (articolo 6): ogni trattamento deve poggiare su una delle condizioni di liceità previste. Usare l'AI per riassumere le email dei clienti è un trattamento nuovo, non un dettaglio tecnico.
- Minimizzazione (articolo 5): i dati devono essere "adeguati, pertinenti e limitati a quanto necessario" rispetto alle finalità. Tradotto: nella chat entra solo ciò che serve al compito.
- Protezione fin dalla progettazione (articolo 25): le misure tecniche e organizzative vanno decise già quando si scelgono i mezzi del trattamento, non dopo il lancio.
- Registro dei trattamenti (articolo 30): il nuovo uso va descritto nel registro, con finalità, categorie di dati e destinatari.
- Sicurezza (articolo 32): misure adeguate al rischio, tra cui cifratura, capacità di ripristino e una procedura per verificare regolarmente che le misure funzionino.
Nessuno di questi punti dipende da dove gira il modello. Dipendono da cosa ci si fa e da quali dati ci passano.
Chi è titolare e chi è responsabile quando l'AI è in cloud?
L'azienda che decide di usare lo strumento resta titolare del trattamento; il fornitore del servizio AI, quando tratta i dati per suo conto, è di norma responsabile del trattamento. L'articolo 28 del GDPR impone di ricorrere solo a responsabili che presentino "garanzie sufficienti" e di regolare il rapporto con un contratto che fissi oggetto, durata, natura e finalità del trattamento (GDPR, testo sul sito del Garante).
Qui nasce la questione che molti associano a "ChatGPT e GDPR". Con un piano aziendale di un grande fornitore il contratto di trattamento dei dati (DPA) di solito esiste e va letto con attenzione: dove sono i server, per quanto tempo restano le conversazioni, quali sub-responsabili intervengono. Con gli account personali dei dipendenti, invece, quel contratto manca del tutto, e l'azienda perde traccia di cosa è uscito.
E i trasferimenti di dati fuori dall'UE?
Se il fornitore elabora i dati fuori dallo Spazio economico europeo si applicano le regole sui trasferimenti del Capo V. L'articolo 45 ammette il trasferimento verso un paese per cui la Commissione ha adottato una decisione di adeguatezza; in mancanza, servono garanzie adeguate come quelle dell'articolo 46 (GDPR, testo sul sito del Garante).
Per gli Stati Uniti la Commissione ha adottato il 10 luglio 2023 la decisione di adeguatezza sul Data Privacy Framework: i dati possono circolare liberamente verso le aziende statunitensi che aderiscono al quadro (Commissione europea, EU-US data transfers). È un'opzione legittima, ma richiede di verificare che il fornitore sia effettivamente aderente e di seguire l'evoluzione del quadro, che in passato è già stato messo in discussione con gli accordi precedenti. È uno dei punti in cui un trattamento interamente on-premise semplifica davvero le cose: se i dati non lasciano l'azienda, il problema del trasferimento non si pone.
Quando serve una valutazione d'impatto per un progetto AI?
Serve quando il trattamento, in particolare se usa nuove tecnologie, può presentare un rischio elevato per i diritti e le libertà delle persone: in quel caso l'articolo 35 chiede di effettuarla prima di iniziare (GDPR, testo sul sito del Garante). L'AI rientra quasi sempre nella categoria delle nuove tecnologie; resta da valutare il rischio.
Il Garante Privacy, nella pagina dedicata alla DPIA, richiama i criteri per riconoscere i trattamenti a rischio elevato, tra cui il monitoraggio sistematico e il trattamento di dati sensibili su larga scala, e ricorda che l'Autorità ha pubblicato un elenco di trattamenti per cui la valutazione è obbligatoria. Se dopo la valutazione il rischio residuo resta alto, prima di partire va consultata l'autorità di controllo.
Nella pratica, alcuni segnali dovrebbero far partire la DPIA senza troppe discussioni:
- l'AI analizza dati di dipendenti, per esempio valutazioni, presenze o comunicazioni interne;
- l'AI lavora su dati sanitari, giudiziari o altre categorie particolari;
- l'output dell'AI influisce su decisioni che riguardano persone, come selezione, credito o assistenza;
- i documenti indicizzati coprono archivi interi, senza una selezione a monte.
Un consiglio da chi accompagna questi progetti: la DPIA è anche il momento migliore per decidere tra cloud e on-premise, perché costringe a scrivere quali dati entrano nel sistema e cosa succederebbe se ne uscissero.
Cosa aggiunge l'AI Act agli obblighi del GDPR?
Aggiunge obblighi che riguardano il sistema di AI in quanto tale, accanto a quelli sui dati personali, che restano invariati. Per un'azienda che usa strumenti AI, il ruolo rilevante è quello di deployer, definito come chi utilizza un sistema di AI sotto la propria autorità, salvo l'uso personale non professionale (AI Act, articolo 3).
Il primo obbligo che tocca quasi tutti è l'alfabetizzazione. Nel testo modificato, l'articolo 4 chiede a fornitori e deployer di adottare misure per sostenere lo sviluppo delle competenze sull'AI del personale che usa questi sistemi, tenendo conto delle conoscenze tecniche e del contesto d'uso, senza dover assicurare un livello specifico per ogni singola persona (AI Act, articolo 4).
Sui tempi, secondo la Commissione europea la legge è entrata in vigore il 1° agosto 2024 ed è diventata applicabile il 2 agosto 2026, con eccezioni: divieti e alfabetizzazione dal 2 febbraio 2025, regole sui modelli per finalità generali dal 2 agosto 2025, norme sui casi ad alto rischio in settori sensibili prorogate al 2 dicembre 2027 dopo l'accordo sulla semplificazione (Commissione europea, quadro normativo sull'IA).
Per chi usa sistemi ad alto rischio, l'articolo 26 prevede obblighi più pesanti: sorveglianza umana affidata a persone competenti, conservazione dei log generati automaticamente, se sono sotto il controllo del deployer, per almeno sei mesi, e uso delle informazioni del fornitore per svolgere la valutazione d'impatto prevista dal GDPR (AI Act, articolo 26). Un assistente per riassumere documenti di solito non è un sistema ad alto rischio; uno strumento che seleziona candidati può esserlo. La classificazione va fatta caso per caso.
Cosa dice l'EDPB sui modelli AI e perché riguarda anche chi li usa?
Dice che il problema non si esaurisce in chi addestra il modello. Con il parere 28/2024 del 18 dicembre 2024, il Comitato europeo per la protezione dei dati ha affrontato tre questioni: quando un modello può dirsi anonimo, se l'interesse legittimo può essere una base giuridica per sviluppo e uso, e cosa succede se il modello è stato addestrato con dati trattati illecitamente (EDPB, parere sui modelli AI).
Tre passaggi del comunicato sono utili a un'azienda che sceglie un modello:
- Anonimato: un modello è anonimo solo se è "molto improbabile" identificare, direttamente o indirettamente, le persone i cui dati sono stati usati, ed estrarre quei dati con delle interrogazioni. Va valutato caso per caso.
- Interesse legittimo: si applica un test in tre fasi. Tra gli esempi c'è proprio un agente conversazionale che assiste gli utenti, ammesso solo se il trattamento è strettamente necessario e il bilanciamento dei diritti è rispettato.
- Dati illeciti a monte: se un modello è stato sviluppato con dati trattati in modo illecito, questo può incidere sulla liceità del suo utilizzo, a meno che il modello sia stato debitamente anonimizzato.
Il terzo punto vale per un servizio cloud come per un modello open-weight scaricato e installato sui propri server (EDPB, parere sui modelli AI). Portare il modello in casa non cambia la sua storia: cambia solo chi lo esegue.
Quando un modello AI on-premise riduce davvero il rischio GDPR?
Lo riduce quando il rischio principale sta nel passaggio dei dati a terzi. Se invece il rischio sta nell'uso che si fa dei dati, la collocazione del server conta poco. Questi sono i casi in cui, nel mio lavoro, vedo l'on-premise portare un beneficio concreto:
| Situazione | Perché l'on-premise aiuta | Cosa resta da fare |
|---|---|---|
| Dati sanitari, giudiziari o altre categorie particolari | Nessun fornitore esterno li elabora: meno soggetti coinvolti | Base giuridica specifica, DPIA, accessi ristretti |
| Clausole di riservatezza con clienti o partner | I documenti non escono dal perimetro concordato | Verificare che il contratto non chieda altro |
| Trasferimenti extra-UE da evitare | I dati restano nell'infrastruttura aziendale | Controllare anche backup, assistenza e telemetria |
| Necessità di dimostrare cosa è successo (audit, contestazioni) | I log sono sotto il tuo controllo, con tempi di conservazione decisi da te | Definire chi li legge e per quanto si conservano |
| Uso di un modello fisso e documentato | La versione cambia solo quando lo decidi tu | Valutare l'origine del modello e la licenza |
La base normativa di questa tabella è nei principi già visti: minimizzazione, sicurezza e regole sui trasferimenti del GDPR. L'articolo 9, in particolare, vieta in via generale il trattamento delle categorie particolari di dati, salvo le eccezioni previste: è il caso in cui ridurre il numero di soggetti che li toccano ha più peso.
Per la parte infrastrutturale, cioè cosa serve per far girare un modello in casa, rimando alla guida completa all'AI on-premise e alla pagina sull'AI on-premise per le aziende.
In quali casi l'on-premise non risolve nulla?
Non risolve nulla quando il problema è organizzativo. Un server in sala macchine con accessi condivisi, password deboli e nessun registro di chi interroga cosa è un rischio, non una tutela. L'articolo 32 chiede la capacità di assicurare riservatezza, integrità e disponibilità dei sistemi e di ripristinarli dopo un incidente (GDPR, testo sul sito del Garante): in casa questo lavoro passa interamente all'azienda.
Gli errori che rendono inutile la scelta sono quasi sempre gli stessi:
- permessi piatti: l'assistente indicizza tutte le cartelle e risponde a chiunque, anche su documenti che quella persona non potrebbe aprire;
- log senza regole: le conversazioni si accumulano senza una scadenza, diventando un archivio di dati personali non previsto;
- nessuna base giuridica rivista: si usano dati raccolti per uno scopo in un trattamento nuovo, senza chiedersi se è compatibile;
- informative ferme: dipendenti e clienti non sanno che i loro dati passano da un sistema AI;
- assistenza remota non governata: il partner tecnico accede al server da fuori, e il trasferimento che si voleva evitare rientra dalla finestra.
Il confronto con il cloud va fatto quindi su controlli equivalenti. Un servizio cloud con contratto aziendale, residenza dei dati nell'UE e permessi ben configurati può essere più sicuro di un'installazione interna trascurata. Ne ho parlato, dal punto di vista dello strumento, nell'articolo sul ChatGPT aziendale privato.
Da dove partire
Prima della tecnologia viene la mappa dei dati. Un percorso ragionevole, da fare con il DPO o con un consulente legale:
- Elenca i casi d'uso dell'AI già attivi o previsti, compresi quelli spontanei dei dipendenti.
- Classifica i dati che ciascun caso d'uso tocca: nessun dato personale, dati comuni, categorie particolari, informazioni coperte da riservatezza contrattuale.
- Individua i ruoli: chi è titolare, chi tratta i dati per tuo conto, dove vengono elaborati.
- Decidi se serve una DPIA e, se sì, usala per confrontare cloud e on-premise sugli stessi rischi.
- Scrivi le regole d'uso e organizza la formazione del personale.
- Scegli l'infrastruttura per ultima, caso d'uso per caso d'uso: spesso il risultato è misto.
Se vuoi un quadro degli aspetti di protezione dei dati legati al progetto, c'è la pagina su AI aziendale e GDPR; due casi concreti sono ChatGPT e i dati riservati e l'AI negli studi legali; altri approfondimenti sono nella categoria privacy e GDPR del blog. Se invece vuoi capire quale strada ha senso per la tua azienda, puoi partire dalla valutazione iniziale.
Domande frequenti
Posso usare ChatGPT in azienda senza violare il GDPR?
In linea di principio sì, se il trattamento ha una base giuridica, i dati inseriti sono limitati al necessario, c'è un contratto di trattamento dei dati con il fornitore e i dipendenti sanno cosa possono incollare nella chat. Il problema tipico non è lo strumento in sé, ma l'uso con account personali, fuori da qualsiasi accordo aziendale.
I prompt e le conversazioni con un assistente AI sono dati personali?
Lo sono ogni volta che contengono informazioni riferibili a una persona: un nome, un'email, una pratica di un cliente, una valutazione su un dipendente. Vanno quindi trattati come gli altri dati personali, con tempi di conservazione definiti e accessi limitati, anche quando il sistema gira sui server aziendali.
Chi deve occuparsi della conformità di un progetto AI in azienda?
La responsabilità resta del titolare del trattamento, cioè dell'azienda. In pratica conviene coinvolgere fin dall'inizio il DPO, se nominato, il responsabile IT e un legale, e affiancare a loro chi conosce i processi che l'AI andrà a toccare. Il mio ruolo è aiutare a impostare il progetto e a fare le domande giuste, non sostituire il parere legale.
Un modello open-weight scaricato da Internet può contenere dati personali?
Può succedere, perché i modelli sono addestrati su grandi quantità di testi. Per questo le autorità europee chiedono di valutare caso per caso se un modello possa considerarsi anonimo. Prima di adottarlo conviene leggere la documentazione del fornitore su dati di addestramento e licenza.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
È sicuro utilizzare ChatGPT con i dati riservati della propria azienda?
Usare ChatGPT con dati riservati dipende dal piano, dal contratto e dalle regole interne. Una risposta onesta per chi guida un'azienda: account personali, piani business, GDPR e casi in cui conviene un'AI sui propri server.
Privacy, GDPR e sovranità dei dati8 min
AI per studi legali: come utilizzare l'intelligenza artificiale mantenendo riservati i documenti
Segreto professionale, GDPR, legge italiana sull'AI e linee guida CCBE: cosa considerare prima di usare l'intelligenza artificiale sui documenti di uno studio legale, e come scegliere tra servizio cloud e ambiente dedicato.
Privacy, GDPR e sovranità dei dati10 min
AI on-premise: guida completa per installare l'intelligenza artificiale sui server aziendali
Cosa significa installare l'intelligenza artificiale sui server aziendali: differenze con il cloud, componenti dello stack, fasi del progetto, limiti reali e per chi ha senso.
AI in locale e on-premise9 min