Fine-tuning o RAG: addestrare un modello sui documenti aziendali o collegarlo?
Il fine-tuning cambia il modo in cui un modello risponde, il RAG cambia le informazioni da cui parte la risposta. Vediamo costi e date della chiusura del fine-tuning OpenAI, dove finiscono i dati di addestramento, cosa dice il Garante e quando addestrare ha ancora senso.
 Giulio PessioneAI sui documenti aziendali10 min
Pubblicato il
Fine-tuning o RAG: per un assistente che risponde su procedure, manuali e archivi interni, di solito la strada giusta è il RAG. A ogni domanda passa al modello i brani pertinenti dei documenti e permette di citarli. Il fine-tuning modifica invece il comportamento del modello con degli esempi: serve per compiti ripetitivi di formato o di classificazione e, sui listini cloud, costa di più a ogni richiesta (OpenAI, listino). Su OpenAI, poi, è in chiusura: dal 6 gennaio 2027 nemmeno i clienti attivi potranno creare nuovi addestramenti (OpenAI, Deprecations).
Fine-tuning o RAG: cosa cambia davvero quando si parla di documenti aziendali?
Il fine-tuning cambia come il modello risponde, il RAG cambia da cosa parte la risposta. Nel fine-tuning si modificano i parametri del modello con esempi di domanda e risposta: il modello impara un formato, un tono, uno schema di classificazione. Nel RAG (retrieval-augmented generation) il modello resta com'è: a ogni domanda un sistema di ricerca recupera i passaggi più pertinenti dei documenti e li inserisce nella richiesta.
Già il paper che ha introdotto il RAG osservava che la capacità dei modelli di accedere con precisione alla conoscenza nei parametri "è ancora limitata", e che indicare la provenienza delle risposte e aggiornare ciò che il modello sa restavano "problemi di ricerca aperti" (Lewis et al., 2020). Per un'azienda sono proprio le due cose che contano.
| Fine-tuning | RAG | |
|---|---|---|
| Cosa cambia | Il comportamento del modello (formato, tono, classificazione) | Le informazioni che il modello riceve a ogni domanda |
| Aggiornare un documento | Serve un nuovo addestramento | Si reindicizza il documento |
| Citare la fonte | Non previsto: ciò che ha imparato sta nei parametri | I brani usati si possono mostrare a chi legge |
| Permessi per utente | Un solo modello, uguale per tutti | La ricerca filtra i documenti in base a chi chiede |
| Rimuovere un dato | Riaddestrare, e non è detto che basti | Correggere o togliere il documento dall'indice |
| Costo iniziale | Esempi etichettati, valutazioni, addestramento | Preparazione dei documenti, indicizzazione, permessi |
| Costo per richiesta | Sui listini cloud, più alto del modello base | Più token in ingresso per i brani recuperati |
Come si costruisce un RAG sui documenti interni l'ho spiegato nella guida sul cervello aziendale. Qui mi concentro sulla scelta e sui suoi costi.
Per quali compiti serve davvero il fine-tuning, e per quali no?
Il fine-tuning serve per compiti ben definiti e ripetitivi, in cui contano il formato dell'uscita o la classificazione, non per far "conoscere" al modello le procedure interne. OpenAI lo indica per classificazione, traduzioni con sfumature, contenuti in un formato preciso e correzione di istruzioni che il modello non rispetta. Servono almeno 10 esempi, i miglioramenti si vedono di solito con 50–100, e "se 50 esempi non hanno effetto" bisogna ripensare il compito o il prompt (OpenAI, Supervised fine-tuning). La stessa guida consiglia di preparare prima le valutazioni (eval): un insieme di casi con la risposta attesa su cui misurare il prima e il dopo.
Google descrive il fine-tuning supervisionato di Gemini come adatto a compiti ben definiti con dati etichettati: classificazione, riassunto, domande e risposte estrattive, chat (Google Cloud, aggiornata al 30/10/2026).
Quanto costa il fine-tuning con i fornitori cloud rispetto al modello base?
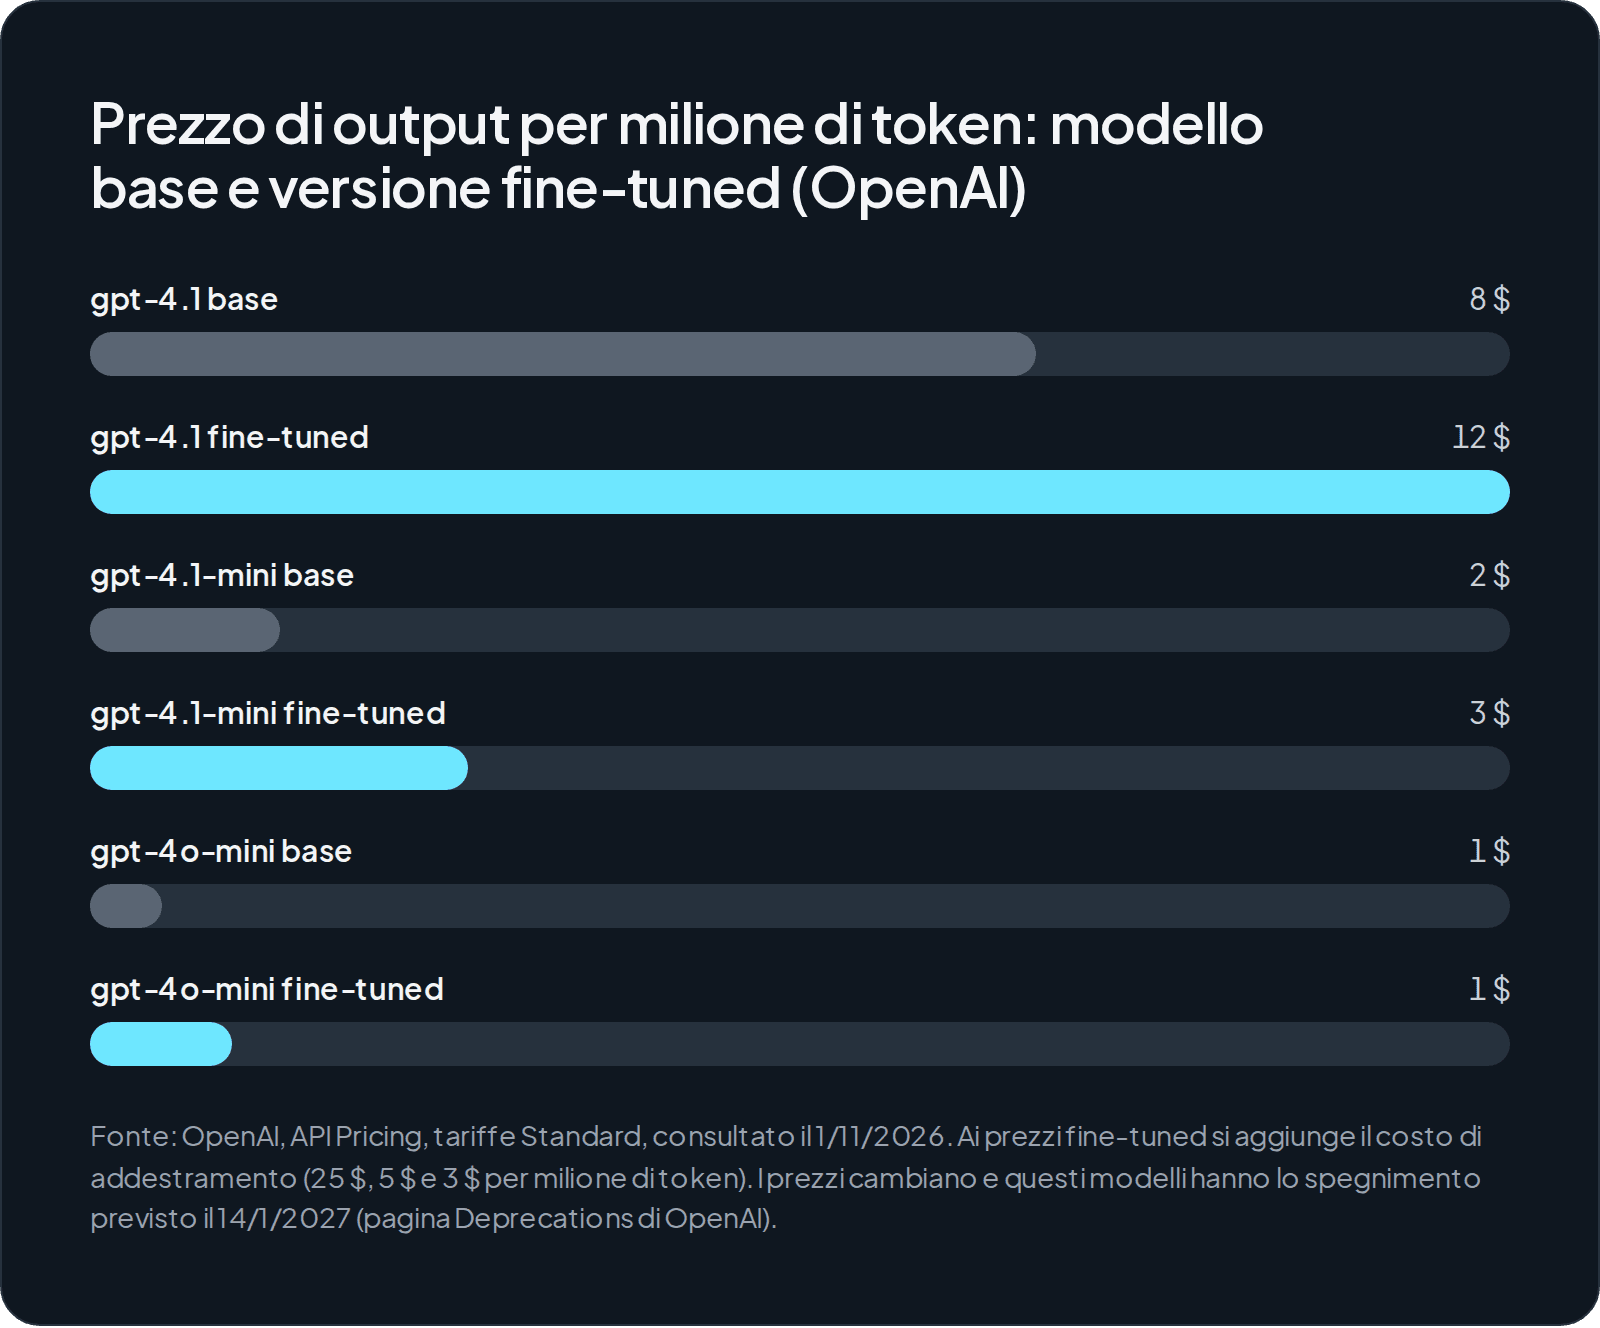
Si paga l'addestramento, e poi ogni richiesta al modello addestrato costa da 1,5 a 2 volte il modello base. Prezzi per milione di token dal listino OpenAI, consultato il 1° novembre 2026; i prezzi cambiano e vanno ricontrollati.
| Modello | Addestramento | Input fine-tuned | Output fine-tuned | Input base | Output base |
|---|---|---|---|---|---|
| gpt-4.1 | 25 $ | 3,00 $ | 12,00 $ | 2,00 $ | 8,00 $ |
| gpt-4.1-mini | 5 $ | 0,80 $ | 3,20 $ | 0,40 $ | 1,60 $ |
| gpt-4o-mini | 3 $ | 0,30 $ | 1,20 $ | 0,15 $ | 0,60 $ |
Il listino prevede anche sconti sull'inferenza "se si attiva la condivisione dei dati" quando si crea il lavoro di addestramento; l'unica riga esplicita è o4-mini, al 50% in meno (listino OpenAI). È uno scambio chiaro tra prezzo e dati, da valutare con attenzione perché gli esempi vengono spesso da materiale aziendale. Comunque o4-mini risulta già spento dal 23 ottobre 2026 (dismissioni).
Sullo stesso listino gpt-6-luna costa 0,10 $ in ingresso e 0,50 $ in uscita, gpt-6.1-terra 1 $ e 5 $ (listino OpenAI). Un modello base recente con un buon prompt e il RAG può quindi costare meno di un modello vecchio addestrato. Resta da verificare sulle proprie valutazioni se la qualità regge.
Cosa cambia con la chiusura della piattaforma di fine-tuning di OpenAI?
OpenAI sta chiudendo il fine-tuning self-service: "OpenAI is winding down the fine-tuning platform", e la piattaforma non è più accessibile ai nuovi utenti (listino OpenAI). Le date, dalla pagina delle dismissioni:
- 7 maggio 2026: stop per chi non l'aveva mai usato.
- 2 luglio 2026: stop per chi non aveva fatto inferenza su un modello fine-tuned negli ultimi 60 giorni.
- 23 ottobre 2026: spegnimento di gpt-4.1-nano e o4-mini, già avvenuto.
- 6 gennaio 2027: i clienti attivi non potranno più creare nuovi addestramenti.
- 14 gennaio 2027: spegnimento di gpt-4.1, gpt-4.1-mini e gpt-4o-mini, con gpt-6-luna come sostituto indicato.
Le versioni fine-tuned seguono lo stesso calendario dei modelli base (OpenAI), e oggi si può addestrare solo la famiglia gpt-4.1 (guida OpenAI). Il listino elenca ancora nano e o4-mini, dati per spenti dalle dismissioni: quando si pianifica conviene incrociare le due pagine.
La lezione va oltre OpenAI. Il lavoro di addestramento resta legato al modello del fornitore e va rifatto a ogni cambio. Con il RAG, i documenti preparati e indicizzati restano dell'azienda e si collegano a un altro modello ripetendo solo le valutazioni. Ne ho parlato nell'articolo sul vendor lock-in nell'AI e nella pagina sulla migrazione dalle API.
Dove finiscono i dati di addestramento quando si fa fine-tuning in cloud?
I file di addestramento restano sui server del fornitore finché non li cancelli, e non rientrano nella conservazione zero dei dati. Secondo la pagina Your data di OpenAI:
- Lavori di fine-tuning: i dati non addestrano i modelli di OpenAI, il monitoraggio degli abusi dura 30 giorni, lo stato del lavoro resta "until deleted" e l'endpoint non è idoneo alla Zero Data Retention.
- File caricati: restano "until deleted" e vanno cancellati a mano o con una scadenza (
expires_after). - Residenza in UE: disponibile per il fine-tuning di gpt-4o, gpt-4o-mini, gpt-4.1 e gpt-4.1-mini, con Zero Data Retention, Modified Abuse Monitoring o equivalente. I file sono conservati nell'UE, l'elaborazione no.
Su Vertex AI dataset e modello addestrato restano nella regione del lavoro, ma il calcolo "potrebbe essere spostato" su altre regioni US o EU (Google Cloud).
Il RAG non azzera il tema: se il modello è in cloud, i brani recuperati passano dal fornitore a ogni richiesta. Le verifiche da fare sono nell'articolo sulle impostazioni privacy delle API AI.
Cosa succede ai dati personali finiti dentro un modello già addestrato?
Toglierli dal documento di partenza potrebbe non bastare a toglierli dal modello. Lo ha scritto il Garante Privacy nel provvedimento n. 760 del 7 ottobre 2026, il parere favorevole con condizioni sullo schema di regolamento della Provincia autonoma di Trento per l'uso dell'IA nell'attività amministrativa (Garante Privacy). Il Garante osserva che "correggere o cancellare un dato alla fonte non significa necessariamente modificarne gli effetti" su un modello addestrato, e chiede misure per l'esercizio effettivo dei diritti "indipendentemente dal sistema o dal modello di intelligenza artificiale utilizzato". Il caso è pubblico, ma la prima applicazione prevista, la gestione documentale, è vicina a quella di molte aziende.
Il parere 28/2024 dell'EDPB considera un modello anonimo solo se è "molto improbabile" identificare le persone o estrarne i dati interrogandolo, e aggiunge che dati trattati illecitamente nello sviluppo possono incidere sulla liceità dell'uso del modello (EDPB).
Con il RAG un documento si corregge, si rimuove o si rende invisibile a chi non ha i permessi; con il fine-tuning bisogna riaddestrare. Il RAG però non rende conformi in automatico: restano valutazione d'impatto quando serve, permessi, registri e regole d'uso. Ne parlo nelle pagine su AI e GDPR e su quando scegliere un modello on-premise.
Si può fare fine-tuning in locale su un modello open-weight, e con quale hardware?
Sì, e così esempi e modello addestrato restano in azienda. LoRA addestra solo piccole matrici aggiuntive: su GPT-3 175B gli autori riportano 10.000 volte meno parametri da addestrare e 3 volte meno memoria GPU (Hu et al., 2021). QLoRA applica lo stesso approccio a un modello quantizzato e permette il fine-tuning di un modello da 65 miliardi di parametri su una singola GPU da 48 GB (Dettmers et al., 2023).
Requisiti di memoria video dichiarati come "minimo assoluto" da Unsloth, azienda che vende strumenti per il fine-tuning, su una pagina senza data (Unsloth):
| Dimensione del modello | QLoRA 4-bit | LoRA 16-bit |
|---|---|---|
| 8 miliardi | 6 GB | 22 GB |
| 14 miliardi | 8,5 GB | 33 GB |
| 32 miliardi | 26 GB | 76 GB |
| 70 miliardi | 41 GB | 164 GB |
Anche in locale servono valutazioni, l'addestramento va ripetuto a ogni cambio di modello base e i dati personali entrati nel modello restano un problema. Cambia il controllo: la data di ritiro non la decide un fornitore. Le voci di costo sono nella pagina sui costi dell'AI in locale; se il caso lo giustifica, server e software si possono fornire già configurati. Per molte aziende, però, il primo passo resta un RAG in locale senza alcun fine-tuning.
Da dove partire per scegliere tra fine-tuning e RAG?
Si parte dalla domanda a cui l'AI deve rispondere, non dalla tecnica:
- Cosa dice un documento o come deve rispondere il modello? Nel primo caso RAG, nel secondo può servire il fine-tuning.
- Quanto spesso cambiano i documenti? Se cambiano ogni settimana, un modello addestrato invecchia subito.
- Servono citazioni e permessi per utente? Il RAG li permette, il solo fine-tuning no.
- Ci sono dati personali negli archivi o negli esempi? Allora poterli correggere e rimuovere pesa molto.
Nel mio lavoro consiglio questo ordine: prima prompt e valutazioni, poi RAG; il fine-tuning solo se resta un problema misurabile di formato o classificazione. Chi ha già modelli fine-tuned su OpenAI dovrebbe:
- fare l'inventario dei modelli addestrati e dei processi che li usano;
- verificare la data di spegnimento del modello base sulla pagina delle dismissioni;
- controllare, sulle stesse valutazioni, se un modello attuale con il RAG ottiene risultati equivalenti.
Per chi valuta di uscire dalle API c'è la guida su come migrare dalle API OpenAI a un LLM locale.
Il cloud resta una scelta legittima: con documenti poco sensibili e le impostazioni corrette, un RAG con un modello di frontiera via API è spesso la soluzione più semplice da avviare. Se i documenti non devono uscire, la pagina sul cervello aziendale spiega come lo stesso approccio funziona sui server interni. Per capire quale strada ha senso per i tuoi archivi puoi partire dalla valutazione: ti aiuto a definire domande, dati coinvolti e prove da fare prima di spendere.
Domande frequenti
Fine-tuning e RAG si possono usare insieme?
Sì. Un modello può essere addestrato per rispettare un formato o classificare le richieste e, nello stesso flusso, ricevere i brani dei documenti tramite RAG. Conviene arrivarci solo dopo aver verificato con valutazioni misurabili che il RAG da solo non basta, perché ogni modello addestrato va mantenuto e rifatto quando cambia il modello base.
Il fine-tuning riduce le risposte inventate sui documenti interni?
Non è il suo scopo principale. Il fine-tuning migliora il modo in cui il modello risponde, ma non gli dà un accesso preciso ai contenuti né la possibilità di citare la fonte. Per le domande sui documenti è più utile un RAG che mostri i passaggi usati, così chi legge può verificarli.
Cosa succede a un modello fine-tuned su OpenAI quando il modello base viene spento?
Secondo la documentazione di OpenAI, i modelli fine-tuned restano utilizzabili finché esiste il loro modello base e si spengono insieme a lui. Per gpt-4.1, gpt-4.1-mini e gpt-4o-mini la data indicata è il 14 gennaio 2027. Dal 6 gennaio 2027, poi, i clienti attivi non potranno più creare nuovi lavori di addestramento: chi dipende da un modello addestrato deve programmare per tempo un'alternativa.
Chi in azienda deve decidere tra fine-tuning e RAG?
La scelta tecnica va presa insieme a chi conosce il processo e a chi si occupa di privacy. Il responsabile del reparto sa quali domande arrivano e quali errori costano. Il referente privacy o il DPO valuta i dati personali presenti nei documenti e negli esempi di addestramento. Chi gestisce i sistemi verifica permessi, conservazione e registri.
Chi scrive
Consulente AI per PMI
Lavoro da circa due anni nel settore dell'intelligenza artificiale in ambito commerciale: processi di vendita, assistenza clienti, qualificazione dei contatti e automazione. Aiuto le aziende a capire dove l'AI crea valore e fornisco quello che serve per portarla nei processi: server per l'AI in locale, già configurati, e software come assistenti sui documenti, agenti e integrazioni con i programmi aziendali.
Da leggere dopo
Come creare un'intelligenza artificiale che conosce tutti i documenti aziendali
Un'AI che risponde su procedure, manuali e archivi interni non si addestra: si collega ai documenti con il RAG. Vediamo come si costruisce, quanto costa in cloud, dove finiscono i dati e quando conviene tenerla sui server aziendali.
AI sui documenti aziendali12 min
Migrare dalle API OpenAI a un LLM locale: guida tecnica, costi e rischi
OpenAI spegne gpt-4o e gpt-4.1 il 14 gennaio 2027. Ecco cosa cambia nel codice quando si passa a Ollama o vLLM, quali parametri si perdono, quanto costano i listini attuali, quali dati restano da OpenAI e in quali casi conviene restare in cloud.
Integrazione con ERP, CRM e migrazione API10 min
Intelligenza artificiale e GDPR: quando scegliere un modello AI on-premise?
Il GDPR non vieta l'AI in cloud e non premia automaticamente quella in casa. Una guida agli obblighi reali (ruoli, DPIA, sicurezza, trasferimenti, AI Act) e ai criteri per capire quando l'on-premise riduce davvero il rischio.
Privacy, GDPR e sovranità dei dati10 min