Come creare un'intelligenza artificiale che conosce tutti i documenti aziendali
Un'AI che risponde su procedure, manuali e archivi interni non si addestra: si collega ai documenti con il RAG. Vediamo come si costruisce, quanto costa in cloud, dove finiscono i dati e quando conviene tenerla sui server aziendali.
Pubblicato il
Un'AI sui documenti aziendali non si addestra sui file. Li collega a un modello linguistico con il RAG: a ogni domanda recupera i passaggi pertinenti e risponde a partire da quelli, indicando da dove vengono. La qualità dipende soprattutto da tre cose: un archivio ordinato, permessi applicati prima che il testo arrivi al modello e regole d'uso chiare. La scelta tra cloud e server interni dipende da quanto sono riservati i documenti e da come crescono i costi con utenti e domande.
Come funziona un'AI sui documenti aziendali, e perché non serve addestrarla?
Il modello non impara i documenti. Con il RAG (Retrieval-Augmented Generation) il sistema cerca nell'archivio i passaggi più vicini alla domanda, li consegna al modello e chiede una risposta basata su quelli. L'approccio è stato descritto da Lewis e colleghi in un paper del 2020. Il paper combina una memoria "parametrica", cioè il modello, e una "non parametrica", cioè l'indice dei documenti.
Lo stesso paper indica due problemi aperti dei modelli linguistici: "providing provenance for their decisions and updating their world knowledge" (arXiv). Corrispondono ai due vantaggi pratici del RAG per un'azienda:
- mostrare la fonte: la risposta può indicare da quale documento proviene;
- aggiornare l'archivio senza riaddestrare: se cambia una procedura, si reindicizza il file e il modello resta lo stesso.
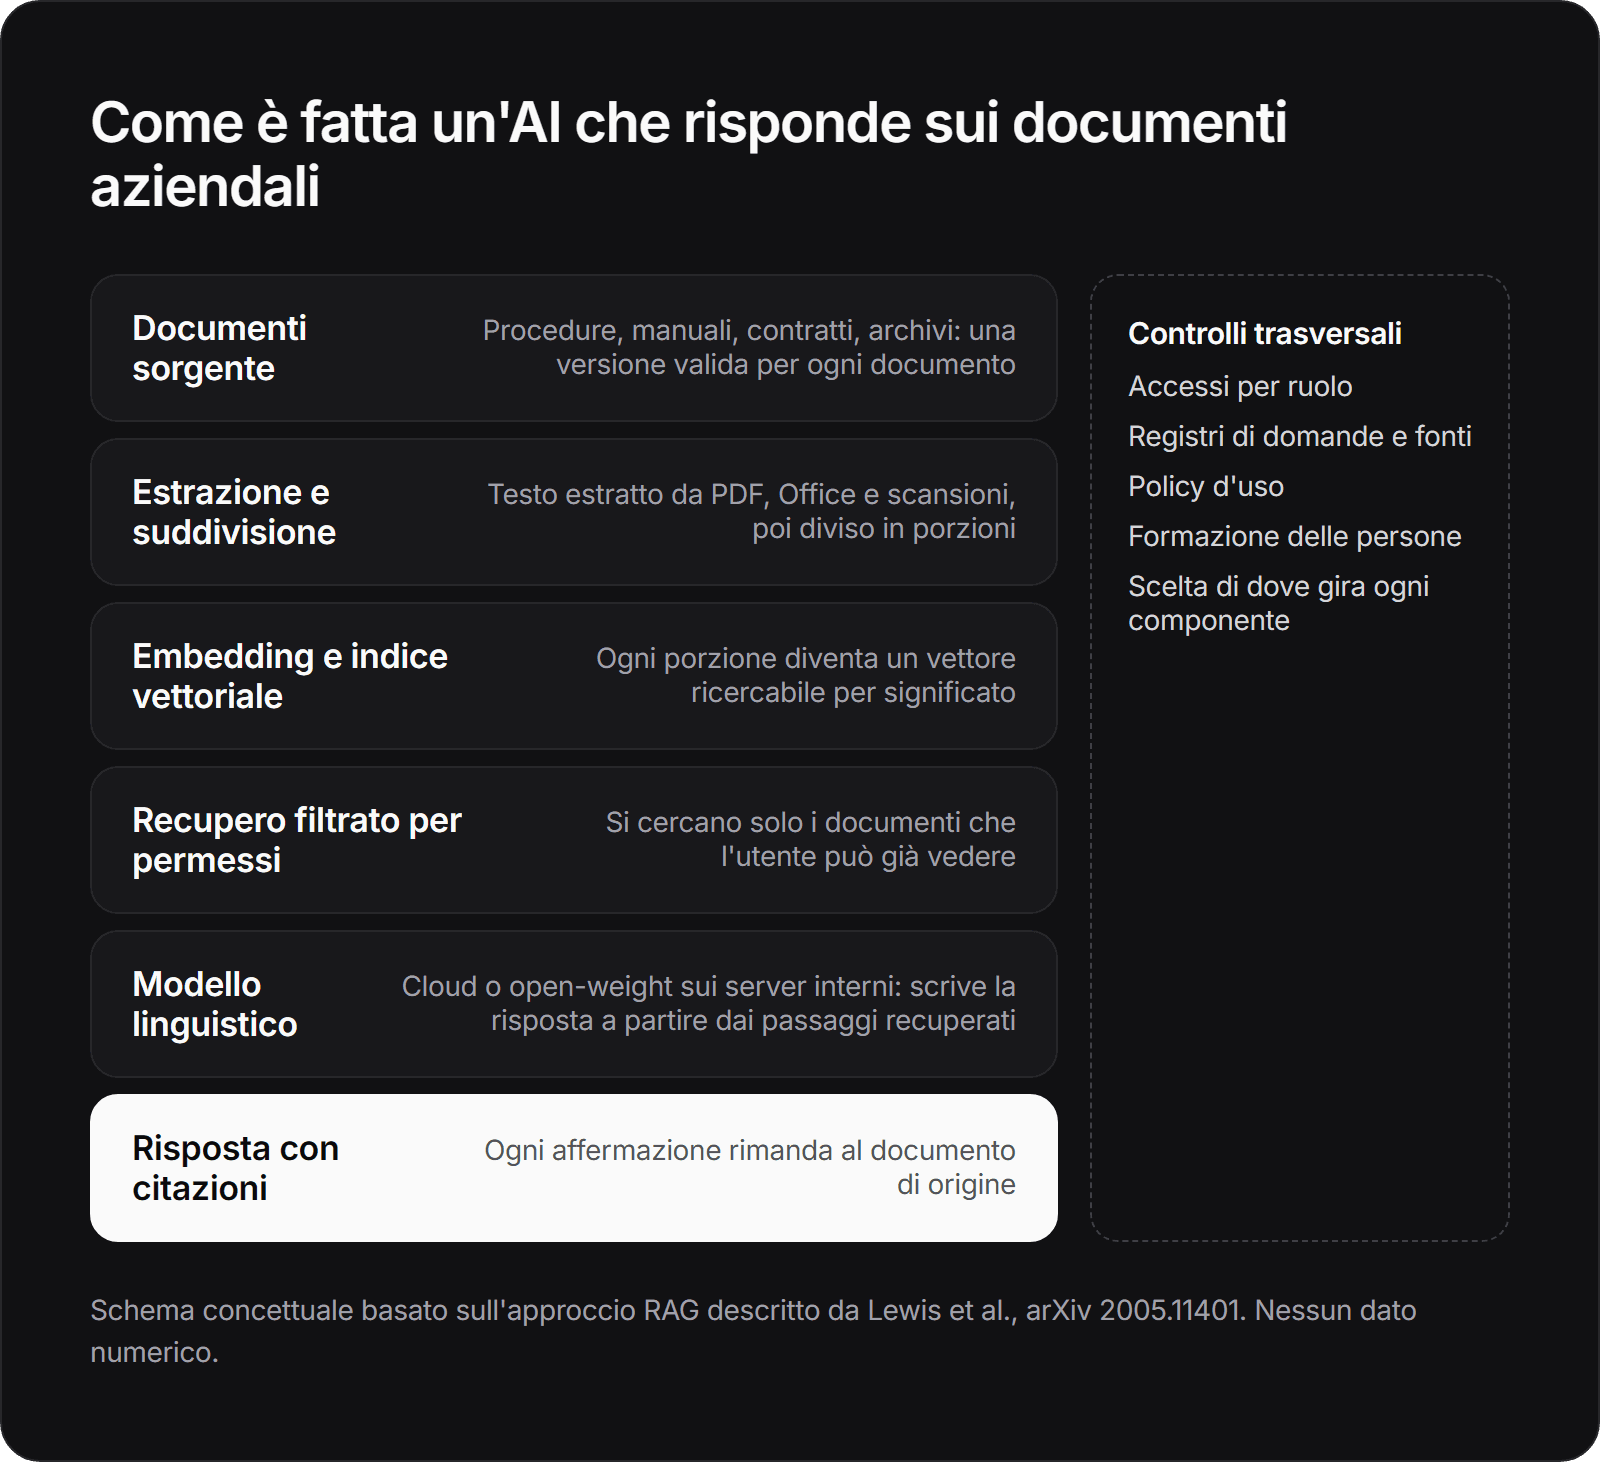
Le componenti di un cervello aziendale sono in genere queste:
- Estrazione del testo da PDF, documenti di testo, fogli di calcolo e pagine intranet.
- Suddivisione in porzioni di lunghezza gestibile.
- Embedding: ogni porzione viene trasformata in una sequenza di numeri che ne rappresenta il significato, così da poterla confrontare con la domanda.
- Indice vettoriale: il database che conserva queste sequenze e trova le più vicine alla domanda. È ciò che permette di cercare per concetto e non solo per parola esatta.
- Recupero: si selezionano i passaggi pertinenti, filtrati in base ai permessi di chi chiede.
- Modello linguistico: scrive la risposta a partire dai passaggi recuperati.
- Risposta con citazioni ai documenti di origine.
Una chat generica e un assistente sui documenti sono quindi due progetti diversi. La differenza è spiegata nell'articolo su come avere un ChatGPT aziendale privato sui propri server. La pagina sul cervello aziendale descrive come valuto questo tipo di progetto.
Quali documenti preparare prima di costruire il cervello aziendale?
La qualità delle risposte dipende dall'archivio più che dal modello. Documenti duplicati, versioni superate e scansioni illeggibili producono risposte sbagliate. Le citazioni non bastano a correggerle: la risposta cita la fonte, ma la fonte è quella sbagliata.
Prima di indicizzare conviene fissare alcuni criteri:
- Perimetro iniziale ristretto: una sola funzione aziendale, per esempio l'assistenza clienti o la qualità.
- Un responsabile per ogni gruppo di documenti, che decide cosa entra e cosa esce.
- Una sola versione valida per ogni procedura o manuale. Le versioni storiche restano fuori dall'indice.
- Formati leggibili: testo selezionabile, titoli e sezioni riconoscibili.
- Classificazione per riservatezza: i documenti con dati personali o informazioni riservate vanno separati fin da subito. Sono questi a decidere dove può girare il sistema e con quali garanzie. Per gli aspetti privacy rimando alla pagina su AI e GDPR.
| Tipo di documento | Problema tipico | Cosa fare prima dell'indicizzazione |
|---|---|---|
| Procedure e istruzioni operative | Più versioni in circolazione | Tenere solo la versione in vigore, con data e responsabile |
| Manuali in PDF scansionato | Testo non selezionabile | Riconoscimento del testo e controllo a campione |
| Fogli di calcolo e tabelle | La struttura si perde nell'estrazione | Convertire o accompagnare con una descrizione testuale |
| Presentazioni | Testo frammentato, senza contesto | Preferire il documento di origine, se esiste |
| Contratti, documenti del personale | Dati personali e informazioni riservate | Classificare, definire chi può vederli, valutare dove elaborarli |
| Email e chat esportate | Dati personali e molto "rumore" | Escluderle dal primo perimetro |
Come si fa in modo che ognuno veda solo i documenti a cui ha accesso?
I permessi vanno applicati nella fase di recupero, prima che il testo arrivi al modello. Chiedere al modello di "non rivelare" certe informazioni non basta: se un passaggio riservato è stato recuperato, può finire nella risposta.
Il rischio è descritto anche nel materiale formativo pubblicato su code.europa.eu. Il capitolo 11 di Fundamentals of Secure AI Systems with Personal Data si basa sul TechSonar dell'EDPS di novembre 2024. Avverte che, se la fonte contiene dati personali, questi "could be retrieved inadvertently e.g. via prompt injection attacks techniques", con il rischio di "data leakage in the AI responses". È materiale didattico, non un atto ufficiale dell'EDPS, ma descrive bene il punto: il filtro deve stare a monte.
In pratica servono tre elementi:
- Recupero filtrato per utente o ruolo, allineato ai permessi già esistenti sulle cartelle e sui sistemi aziendali.
- Citazioni obbligatorie in ogni risposta. Permettono di verificare e aiutano a non fidarsi alla cieca. Quando non trova nulla di pertinente, l'assistente deve poter rispondere «non trovato».
- Registri: chi ha chiesto cosa e quali documenti sono stati recuperati. Servono a migliorare il sistema e a sostenere i controlli interni.
Per impostare l'analisi dei rischi è utile il rapporto AI Privacy Risks & Mitigations – Large Language Models. È stato pubblicato il 10/04/2025 nell'ambito del Support Pool of Experts dell'EDPB e redatto da un'esperta esterna, Isabel Barbera. Propone "a comprehensive risk management methodology for LLM systems" e include tre casi d'uso, tra cui un chatbot per le domande dei clienti.
Quanto costa un'AI sui documenti aziendali con i servizi cloud?
In cloud si paga in tre modi che si sommano: abbonamenti per utente, token del modello e, se si usano strumenti gestiti, archiviazione e ricerche. Le cifre che seguono vengono dalle pagine prezzi ufficiali consultate il 26/10/2026. I listini cambiano: vanno ricontrollati prima di qualsiasi stima.
OpenAI (pricing API):
- File Search: archiviazione a 0,10 $ per GB al giorno, con 1 GB gratuito, più 2,50 $ ogni 1.000 chiamate.
- Embedding: 0,02 $ per 1M token con text-embedding-3-small, 0,13 $ con text-embedding-3-large.
- Modelli: da 0,10 $ in input e 0,50 $ in output per 1M token (gpt-6-luna) a 10 $ e 50 $ (gpt-6-astra).
- Residenza dei dati: sugli endpoint regionali si paga il 10% in più, per i modelli usciti dal 5 marzo 2026 in poi.
Anthropic (pricing Claude):
- Team: 25 $ per posto al mese con fatturazione mensile, 20 $ con fatturazione annuale. Il posto premium costa 125 $ (mensile) o 100 $ (annuale).
- Enterprise: 20 $ per posto al mese con fatturazione annuale e minimo 20 posti. A questo si aggiunge un costo d'uso che "scales with model and task".
- Limiti d'uso: si azzerano su finestre mobili di cinque ore, e i piani a pagamento aggiungono limiti settimanali.
Le voci non crescono tutte con lo stesso fattore:
| Voce | Unità di prezzo | Cresce con |
|---|---|---|
| Abbonamenti per utente | Per posto al mese (Anthropic) | Numero di persone |
| Token del modello | Per 1M token in input e output (OpenAI) | Numero di domande e lunghezza dei passaggi inviati al modello |
| Embedding | Per 1M token (OpenAI) | Volume dei documenti e frequenza degli aggiornamenti |
| Archiviazione dell'indice | Per GB al giorno (OpenAI) | Dimensione dell'archivio |
| Ricerche | Per 1.000 chiamate (OpenAI) | Numero di domande |
Nel RAG i passaggi recuperati si aggiungono alla domanda come testo in input, e l'input si paga a token (OpenAI). Più testo si recupera per risposta, più token si pagano.
Il punto da tenere presente è la crescita. Gli abbonamenti aumentano con le persone, archiviazione e ricerche aumentano con l'archivio e con l'uso. Per confrontare queste voci con hardware, energia e assistenza di un'installazione interna c'è la pagina sui costi dell'AI in locale. Il calcolo del costo complessivo su più anni è nell'articolo su quanto costa un'intelligenza artificiale privata.
Dove finiscono i documenti quando passano da un servizio esterno?
Dipende dal fornitore, dal piano e dal contratto. Due elementi però vanno sempre verificati. Il primo sono le eccezioni alla cancellazione. Il secondo è l'archivio indicizzato: nei servizi gestiti di ricerca sui file resta conservato presso il fornitore, che infatti lo fattura per GB al giorno (OpenAI).
Un esempio concreto è la pagina del Privacy Center di Anthropic sulla conservazione dei dati delle organizzazioni, aggiornata al 01/07/2026:
- API: input e output vengono cancellati dal backend entro 30 giorni, salvo eccezioni.
- Claude for Work ed Enterprise: le conversazioni restano salvate finché l'utente non le cancella. Dopo la cancellazione spariscono dal backend entro 30 giorni.
- Violazioni delle policy: input e output si conservano fino a 2 anni, i punteggi di sicurezza fino a 7 anni.
- Feedback degli utenti: conservati 5 anni. Gli obblighi di legge possono estendere la conservazione.
- Conservazione zero: richiede accordi specifici. Il piano Enterprise ha controlli di conservazione personalizzati.
Conta anche chi gestisce davvero il servizio. Il 23/10/2026 Tech Times UK ha riportato un'indagine di Cybernews su 302.ai, un servizio di AI gestito da Univerads Technology Limited, società di Hong Kong fondata nel 2020. Su uno spazio Azure pubblico si trovavano 17,6 milioni di file, pari a 22,72 TB, con oltre 144.000 registri di chat. L'esposizione è stata scoperta il 02/08, segnalata l'11/08 e risultava chiusa l'08/09/2026. Non va generalizzato a tutti i fornitori. Mostra però quanto conta sapere chi gestisce il servizio, dove conserva i dati e in quale giurisdizione opera.
Per un archivio documentale il tema pesa più che per una chat. In una chat si invia una domanda alla volta. In una knowledge base si carica una parte consistente del patrimonio informativo dell'azienda. Per i rischi legati agli account personali rimando all'articolo su ChatGPT e dati riservati. Giurisdizioni extra UE e CLOUD Act sono trattati nell'articolo sulla sovereign AI.
Cosa serve per far girare l'AI sui documenti aziendali sui server interni?
Servono un modello open-weight, un modello di embedding, un indice vettoriale e un'interfaccia con autenticazione. Nelle ultime settimane sono arrivati diversi modelli nuovi eseguibili in locale, alcuni indicati per hardware contenuto.
Le release di Ollama di ottobre 2026 ne danno un'idea:
- v0.40.4 (12/10): embedding multimodali tramite llama-server.
- v0.40.5 (14/10): Nemotron 3.5 Super, descritto come "120B-parameter hybrid Mamba-2/Transformer" con contesto fino a 1M token. Nella stessa versione arriva Nemotron 3.5 Bolt da 74B con 9B parametri attivi, indicato per GPU da 24 GB.
- v0.40.8 e v0.40.9 (21/10 e 22/10): Recursive Flint, un modello MoE da 40B con 2,5B parametri attivi per token. Disponibile prima su macOS, poi anche su Linux e Windows.
- v0.40.10 (23/10): Nemotron 3.5 Bolt E4B, con una finestra di contesto di 128K token.
Per il RAG questi sviluppi possono aiutare. Una finestra di contesto più ampia, come quelle indicate nelle note di rilascio di Ollama, consente di passare al modello più passaggi recuperati. Anche le indicazioni sull'hardware riportate nelle stesse note di rilascio sono un punto di partenza per ragionare sui requisiti. Le prestazioni reali però vanno misurate sui propri documenti e sulle proprie domande: una nota di rilascio non sostituisce una prova.
Il cloud resta la scelta più sensata in alcuni casi:
- pochi utenti e volumi bassi;
- documenti non riservati;
- nessuna risorsa interna per la manutenzione;
- bisogno dei modelli di frontiera più capaci, per esempio su ragionamenti complessi.
I casi d'uso, i limiti e le alternative sono descritti nella pagina sull'AI on-premise.
Quali regole e quale formazione servono per usarla in modo conforme?
Lo strumento, da solo, non rende conforme l'azienda. Servono una policy d'uso, ruoli chiari, registri e formazione delle persone, in cloud come in locale.
Il quadro italiano ha da poco un nuovo tassello. Il D.Lgs. 179/2026 è stato pubblicato nella Gazzetta Ufficiale n. 234 dell'08/10/2026 ed è in vigore dal 23/10/2026. Indica AgID e ACN come autorità nazionali per l'AI e affida compiti di vigilanza del mercato anche a Banca d'Italia, CONSOB e IVASS. Restano ferme le competenze del Garante privacy. Le sanzioni sono agli artt. 19-25, con rinvio all'art. 99 dell'AI Act.
Tra i criteri di delega della L. 132/2025, l'art. 24, comma 2, lett. e) richiama i "percorsi di alfabetizzazione e formazione in materia di utilizzo dei sistemi di intelligenza artificiale" (Normattiva). La formazione è quindi un tema esplicito anche per il legislatore, non solo una buona pratica.
Una checklist minima per un assistente sui documenti:
- Chi può caricare documenti nell'archivio indicizzato, e da quali cartelle.
- Chi approva le nuove fonti prima che diventino consultabili.
- Cosa non si chiede all'assistente: per esempio decisioni sul personale o valutazioni su singole persone.
- Come si segnala una risposta sbagliata e chi corregge il documento o la configurazione.
- Chi consulta i registri, con quale frequenza e per quali finalità.
- Quale formazione ricevono gli utenti: come leggere le citazioni, quando verificare, cosa fare con un «non trovato».
Gli obblighi privacy che restano in capo all'azienda, qualunque sia l'infrastruttura, sono descritti nella pagina su AI e GDPR.
Da dove partire con un progetto pilota sui documenti?
Si parte da un pilota piccolo e misurabile, non da tutto l'archivio. Il percorso che propongo di solito è questo:
- Scegliere un caso d'uso circoscritto, con domande frequenti e documenti già abbastanza ordinati. L'assistenza clienti interna e le procedure di qualità sono buoni candidati.
- Mappare i documenti per livello di riservatezza. È questa mappa a orientare la scelta tra cloud, soluzione ibrida e server interni.
- Stimare i costi cloud con i listini ufficiali sul volume reale di utenti e domande, e confrontarli con l'alternativa locale, voce per voce.
- Definire prima come si misura la qualità: un insieme di domande di prova con le risposte corrette e i documenti che dovrebbero essere citati. Lo stesso insieme serve a confrontare modelli diversi, anche cloud contro open-weight.
- Decidere permessi, registri e regole d'uso prima di aprire l'accesso alle persone, non dopo.
Se vuoi capire quale configurazione ha senso per il tuo archivio, puoi richiedere una valutazione oppure scrivermi dalla pagina contatti.
Domande frequenti
Quando si aggiorna un documento, bisogna rifare tutto da capo?
No. Con il RAG basta reindicizzare il documento modificato: il modello linguistico resta lo stesso. Conviene però stabilire chi aggiorna l'archivio e ogni quanto, e rimuovere le versioni superate, altrimenti l'assistente può citare procedure non più valide.
L'assistente può leggere PDF scansionati, tabelle e immagini?
Sì, ma con risultati variabili. Le scansioni richiedono un passaggio di riconoscimento del testo, e le tabelle complesse spesso perdono la loro struttura. Prima di estendere il progetto è utile provare un campione di documenti reali. Alcuni strumenti locali stanno aggiungendo embedding multimodali, ma la resa va verificata caso per caso.
Con il RAG l'AI smette di inventare le risposte?
Riduce il problema, ma non lo elimina. Il modello può comunque interpretare male un passaggio o rispondere quando i documenti recuperati non sono pertinenti. Per questo sono utili le citazioni obbligatorie, la possibilità di rispondere «non trovato» e un insieme di domande di prova con cui controllare la qualità nel tempo.
Meglio il RAG o il fine-tuning di un modello sui documenti aziendali?
Per rispondere su contenuti che cambiano e mostrarne la fonte, il RAG è di solito la scelta più pratica: si aggiorna senza riaddestrare e permette di applicare i permessi. Il fine-tuning serve piuttosto a modificare lo stile o il formato delle risposte, e non sostituisce il collegamento ai documenti.
Si può partire in cloud e passare in locale più avanti?
Sì, se lo si progetta fin dall'inizio: documenti preparati in modo indipendente dal fornitore, permessi gestiti nel proprio sistema e domande di prova riutilizzabili. In questo modo si può confrontare un modello open-weight con quello cloud sugli stessi casi prima di decidere.
Chi scrive
Lilium AI
AI privata e on-premise per aziende di ogni dimensione, con i dati sotto controllo
Da leggere dopo
ChatGPT aziendale privato: come avere un assistente AI sui propri server
ChatGPT è un servizio cloud di OpenAI: per un assistente sui server aziendali servono modelli open-weight e un'interfaccia di chat. Confronto onesto tra piani business, soluzione interna e approccio ibrido.
AI in locale e on-premise10 min
Quanto costa installare un'intelligenza artificiale privata in azienda?
Le voci di costo di un'AI privata aziendale, il confronto con API e abbonamenti per utente, un metodo per calcolare il TCO su tre anni e i casi in cui il locale non conviene.
Costi e TCO9 min
È sicuro utilizzare ChatGPT con i dati riservati della propria azienda?
Usare ChatGPT con dati riservati dipende dal piano, dal contratto e dalle regole interne. Una risposta onesta per chi guida un'azienda: account personali, piani business, GDPR e casi in cui conviene un'AI sui propri server.
Privacy, GDPR e sovranità dei dati8 min