Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6 Astra: quanto costa davvero ogni compito aziendale
Nel benchmark agentico GDPx Gemini 4 Carbon costa un terzo di Claude Opus 5.5 per compito, con un punteggio vicino. Vediamo cosa misurano davvero questi costi, quanto cambiano con il tipo di compito e quali dati passano da ciascun fornitore.
 Giulio PessioneCosti e TCO10 min
Pubblicato il
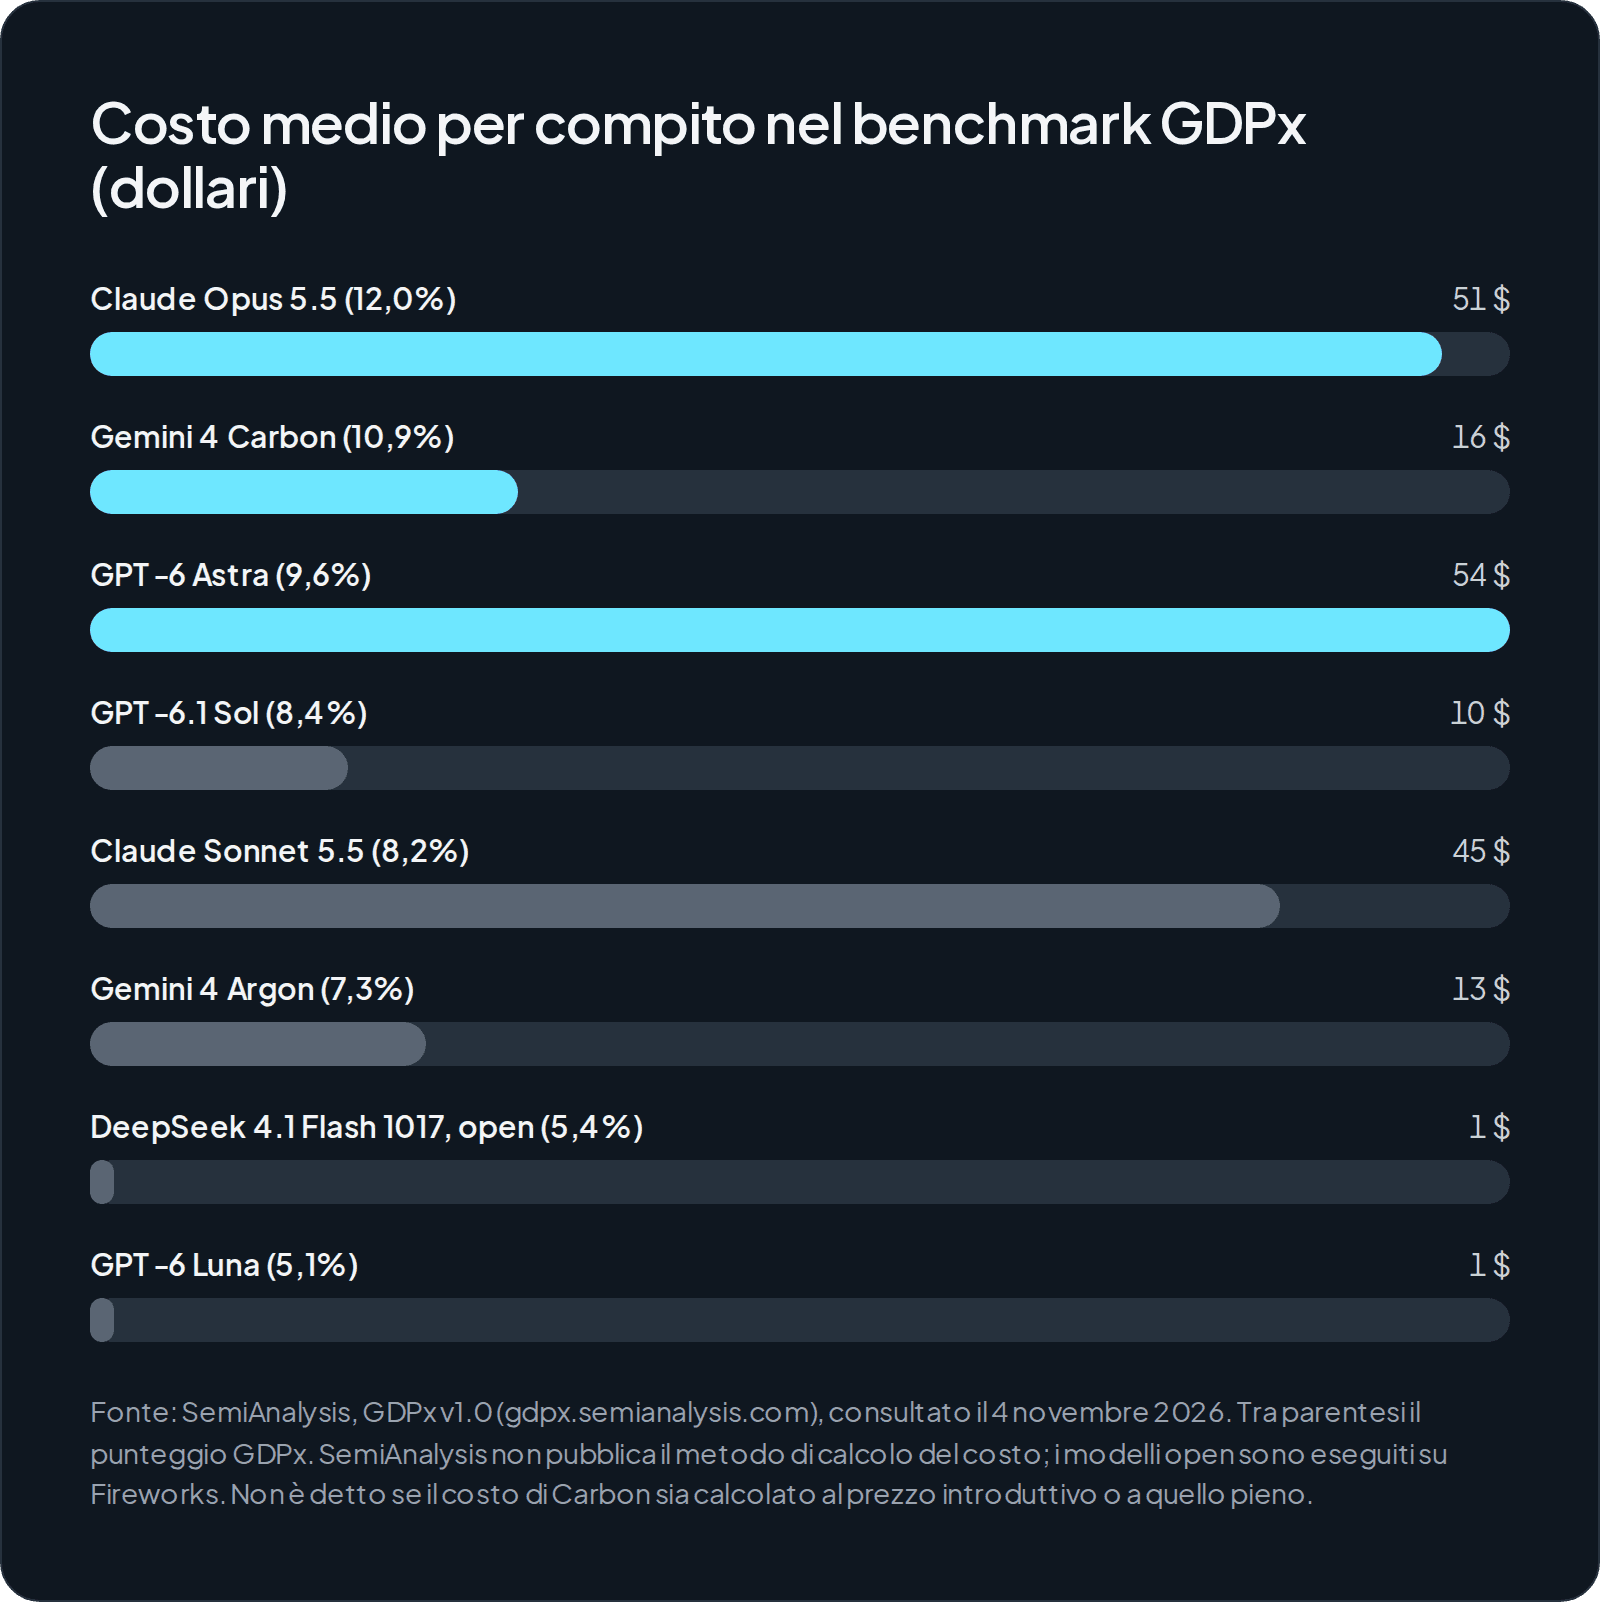
Nel confronto Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6 Astra sul benchmark agentico GDPx di SemiAnalysis, Opus 5.5 ha il punteggio più alto (12,0%) a 51,41 $ per compito. Carbon arriva al 10,9% con 16,29 $, Astra al 9,6% con 53,99 $ (dati consultati il 4 novembre 2026). Carbon però non si può ancora acquistare, e la pagina del benchmark non spiega come calcola il costo. Per un'azienda contano il costo per compito riuscito sui propri processi e il luogo in cui finiscono i dati.
Gemini 4 Carbon vs Claude Opus 5.5 vs GPT-6 Astra: quanto costa un compito secondo GDPx?
Secondo GDPx v1.0, Carbon ottiene un punteggio vicino a quello di Opus 5.5 spendendo circa un terzo per compito. GPT-6 Astra costa più di entrambi e ottiene un punteggio più basso.
GDPx è un benchmark agentico: il modello non risponde a una domanda, ma esegue un compito in più passaggi in un ambiente isolato. Secondo la pagina del benchmark i compiti sono 206, divisi in 11 ambiti tra cui finanza, legale, ingegneria del software, progettazione di chip e cybersicurezza. Ogni ambito pesa allo stesso modo e il punteggio è la media di 3 tentativi. I modelli open girano su Fireworks.
Questi sono i valori pubblicati da SemiAnalysis, consultati il 4 novembre 2026:
| Modello | Punteggio GDPx | Costo per compito | Token in output per compito |
|---|---|---|---|
| Claude Opus 5.5 | 12,0% | 51,41 $ | 548K |
| Gemini 4 Carbon | 10,9% | 16,29 $ | 594K |
| GPT-6 Astra | 9,6% | 53,99 $ | 275K |
| GPT-6.1 Sol | 8,4% | 9,80 $ | 352K |
| Claude Sonnet 5.5 | 8,2% | 45,27 $ | 967K |
| Gemini 4 Argon | 7,3% | 12,79 $ | 359K |
| DeepSeek 4.1 Flash 1017 (open) | 5,4% | 0,94 $ | 246K |
| GPT-6 Luna | 5,1% | 0,92 $ | 438K |
I punteggi assoluti sono bassi perché i compiti sono molto specialistici: un 12% non dice quanto il modello sbaglierebbe sulle email di un ufficio commerciale. Sulla pagina di GDPx mancano poi il metodo di calcolo del costo, i punteggi per ambito e le impostazioni di ragionamento usate per ciascun modello. Inoltre la pagina mostra 13 modelli su 20. I numeri servono a un confronto relativo, non come preventivo.
Perché il costo per compito non coincide con il prezzo a token?
Il costo di un compito dipende da quanti token il modello legge e scrive in tutti i passaggi, non solo dal listino. Astra scrive 275K token in output, contro i 548K di Opus e i 594K di Carbon, eppure costa di più per compito.
Questi sono i listini ufficiali, consultati il 4 novembre 2026 e soggetti a modifiche:
| Modello | Input (per milione di token) | Output (per milione di token) | Fonte |
|---|---|---|---|
| Claude Opus 5.5 | 4 $ | 20 $ | Anthropic |
| Claude Sonnet 5.5 | 2 $ | 10 $ | Anthropic |
| GPT-6 Astra (fino a 272K di contesto) | 10 $ | 50 $ | OpenAI |
| GPT-6 Astra (oltre 272K) | 20 $ | 75 $ | OpenAI |
| GPT-6.1 Sol | 2 $ | 10 $ | OpenAI |
| Gemini 4 Carbon (introduttivo, poi pieno) | 2 $ → 4 $ | 10 $ → 20 $ |
Per questo cache e batch possono pesare quanto il listino. Una lettura dalla cache costa 0,20 $ per milione di token con Opus 5.5 e 1 $ con Astra, e il batch costa la metà sia con Anthropic sia con OpenAI. Oltre i 272K token di contesto, invece, Astra raddoppia il prezzo in input e porta l'output a 75 $ (OpenAI): un agente che accumula documenti può superare la soglia senza che nessuno se ne accorga.
Non sappiamo nemmeno se i 16,29 $ di Carbon siano calcolati al prezzo introduttivo o pieno. Artificial Analysis, con test propri, gli attribuisce 7,76 $ a compito al prezzo pieno: misure diverse, non confrontabili. Per conoscere il costo nei tuoi flussi bisogna misurarlo, e in questo articolo sul monitoraggio dei costi AI spiego come organizzare chiavi, workspace ed etichette.
La classifica cambia se i compiti somigliano a quelli di un'azienda normale?
Sì. Secondo 9to5Google, escludendo cybersicurezza, biologia e allineamento GPT-6 Astra passa in testa, e GPT-6.1 Sol e Sonnet 5.5 superano Carbon. Questa classifica filtrata non è sulla pagina di GDPx: la testata la ricava da un post di SemiAnalysis su X, senza punteggi numerici.
Una parte del vantaggio di Carbon sembra quindi venire dalla sicurezza informatica. Google dichiara l'88,2% su SEC-bench Pro e il 71,0% su CWE-bench, e ha dato accesso al modello prima di tutto ai difensori informatici. Anche lì, però, secondo 9to5Google i modelli Muse di Meta vincono "con un margine significativo".
Per un'azienda che lavora soprattutto su finanza, contratti e software, GPT-6.1 Sol, a 9,80 $ a compito su GDPx, potrebbe offrire il rapporto migliore tra qualità e costo. È un'ipotesi da verificare sui propri compiti.
Quanto costa ogni punto di benchmark, e quale modello conviene per fascia di compito?
Dividendo il costo per compito per il punteggio, Carbon e Sol costano molto meno per punto di Opus e Astra. DeepSeek 4.1 Flash e Luna costano ancora meno, ma con punteggi assoluti più bassi.
Da qui si ricava una prima ipotesi di lavoro, da confermare con test sui propri dati:
| Fascia di compito | Esempi | Modelli da provare |
|---|---|---|
| Agentici lunghi e ad alto valore | analisi legali o finanziarie complesse, revisione di codice | Opus 5.5, GPT-6 Astra, Carbon quando sarà disponibile |
| Intermedi | sintesi di pratiche, bozze di risposte, ricerche nei documenti | GPT-6.1 Sol, Sonnet 5.5, Argon |
| Ripetitivi | classificare richieste, estrarre campi da ordini, instradare email | GPT-6 Luna o modelli piccoli, anche in locale |
Alcune opzioni aggiungono costi. Con Anthropic l'inferenza solo negli Stati Uniti costa 1,1 volte il prezzo e la modalità veloce di Opus 5.5 il doppio (Anthropic). Con OpenAI la residenza dei dati costa il 10% in più per i modelli rilasciati dal 5 marzo 2026 (OpenAI). Il metodo per assegnare un modello a ogni passaggio è in modelli AI piccoli o di frontiera.
Chi può usare Gemini 4 Carbon oggi, e cosa succede al prezzo dopo il lancio?
Per ora quasi nessuno. Google dà accesso a "un sottoinsieme di difensori informatici" e ai partner del programma Fairwind; per gli altri l'accesso arriverà "il prima possibile", senza date, come conferma anche The Register. Carbon non compare nel listino delle API di Gemini (consultato il 4 novembre 2026), e il post di lancio non dice nulla su Vertex AI, regioni o Unione europea.
Il prezzo introduttivo è di 2/10 $ per milione di token, con uno sconto del 95% sull'input in cache. Dopo un periodo di durata non indicata si passa a 4/20 $ (Google), cioè quanto Opus 5.5. Google ha già seguito lo stesso schema con Argon, che passa a 4/20 $ dal 1° dicembre 2026 (Google). Un budget su Carbon va fatto al prezzo pieno.
Nell'Artificial Analysis Intelligence Index Carbon (High) ottiene 60 contro il 59 di Opus 5.5 (Max). Le differenze con Argon le ho trattate in Gemini 4 Carbon per le aziende.
Quali dati aziendali passano da Google, Anthropic e OpenAI con questi modelli?
Dipende da fornitore e canale. Anthropic sull'API diretta non offre un'inferenza solo in UE, OpenAI la offre a precise condizioni, per Carbon Google non ha pubblicato informazioni.
| Fornitore e canale | Dove si elaborano i dati | Conservazione e addestramento |
|---|---|---|
| Anthropic, API diretta | inferenza solo "us" o "global", workspace solo "us" (Anthropic) | da verificare nel contratto |
| Anthropic su Bedrock o Vertex AI | dipende dall'endpoint scelto (Anthropic) | secondo le condizioni del cloud scelto |
| OpenAI, API | SEE e Svizzera solo con ZDR, MAM, Private Retention o Safety Retention, più approvazione ed emendamento del contratto (OpenAI) | registri anti-abuso fino a 30 giorni, niente addestramento salvo consenso (OpenAI) |
| Google, Gemini API (Argon a pagamento) | non indicato nella pagina prezzi | dati non usati per migliorare i prodotti (Google) |
| Google, Carbon | nessuna informazione pubblica | nessuna informazione pubblica |
Per Astra, in modalità Ultrafast è supportata solo l'elaborazione negli Stati Uniti o globale, e in Fast la residenza UE non è prevista (OpenAI).
Conta anche il volume. Un agente manda al fornitore molto contesto: documenti, email, estratti del gestionale. Su GDPx i modelli producono da 246K a 967K token solo in output per compito, ed è plausibile che il contesto letto sia più ampio. Le impostazioni da controllare sono in impostazioni privacy delle API AI, gli obblighi nella pagina su AI e GDPR. Nessun fornitore rende un trattamento conforme da solo: valutazione d'impatto, contratto e regole interne restano a carico dell'azienda.
Un modello open-weight in locale può sostituire questi tre su alcuni compiti?
Su alcuni passaggi può bastare, sui compiti agentici difficili oggi resta indietro. DeepSeek 4.1 Flash 1017 fa il 5,4% su GDPx a 0,94 $ a compito, ma eseguito su Fireworks: quel costo non descrive un server aziendale.
Secondo la scheda su Hugging Face i pesi hanno licenza MIT, il modello ha 763 miliardi di parametri e un contesto da 1 milione di token e si usa con vLLM, SGLang e Transformers. Secondo la versione NVFP4 pubblicata da NVIDIA, i pesi originali occupano circa 475 GiB e quelli compressi circa 400 GiB.
Il locale tende a convenire con volumi alti e stabili, dati che non devono uscire e passaggi in cui un punteggio più basso è accettabile o controllato da una persona. Con pochi compiti complessi al mese, Sol o Carbon via API probabilmente costano meno di un server. Spesso ha senso una configurazione ibrida: il modello locale estrae e anonimizza i dati sensibili, quello di frontiera ragiona su dati già ripuliti. Per i conti su più anni ci sono le pagine sui costi dell'AI in locale, sull'AI on-premise e sui modelli di frontiera in azienda.
Da dove partire per confrontare il costo reale dei modelli sui propri compiti?
Dai propri compiti, non dai benchmark:
- Scegli 20-30 compiti reali di un processo: richieste clienti, ordini da leggere, pratiche da riassumere.
- Misura per ogni modello token in input e output, uso della cache e tempi, e fai controllare l'esito da chi conosce il processo.
- Calcola il costo per compito riuscito: un compito fallito e rifatto costa due volte, più il tempo di chi lo controlla.
- Fai il budget al prezzo pieno, 4/20 $ per Carbon (Google), con i rincari per la regione di elaborazione quando servono.
- Fai una tabella per passaggio con i dati che escono e la giurisdizione verso cui vanno.
- Annota la data dei listini: "Price and plans are subject to change at Anthropic's discretion" (Anthropic).
Se usi già Opus, prezzi e migrazione sono in Claude Opus 5.5 per le aziende. Costruisci l'integrazione in modo da poter cambiare modello senza riscrivere tutto: quando Carbon sarà accessibile, basterà ripetere il test.
Nel mio lavoro aiuto a impostare questo confronto sui processi reali, con modelli di frontiera via API, in locale o con entrambi: il servizio è descritto nella pagina sulla consulenza AI per i processi aziendali. Se una parte del lavoro conviene tenerla in casa, server e software si possono fornire già pronti; se convengono le API, te lo dico. Puoi partire dalla valutazione.
Domande frequenti
I prezzi di GDPx valgono anche per gli abbonamenti come Claude Pro o Team?
No. GDPx calcola il costo con i prezzi delle API. Gli abbonamenti hanno una tariffa fissa per utente (per esempio Team Standard di Anthropic a 25 $ al mese, 20 $ con pagamento annuale, secondo claude.com/pricing) e limiti di utilizzo, quindi il costo per compito non si traduce in una cifra per abbonamento.
Quanto è affidabile un benchmark agentico come GDPx per scegliere un fornitore?
È un buon riferimento per confrontare modelli sugli stessi compiti, ma la pagina non pubblica il metodo di calcolo del costo, i punteggi per ambito e le impostazioni di ragionamento. In più la classifica cambia se si escludono alcuni ambiti. Va usato per scegliere quali modelli provare, non come verdetto finale.
Si può usare Gemini 4 Carbon tramite Vertex AI in una regione europea?
Al 4 novembre 2026 Google non ha comunicato nulla su Vertex AI, sulle regioni o sull'UE per Carbon, e il modello non compare nel listino delle API. Prima di pianificare un uso con dati personali bisogna aspettare la documentazione ufficiale.
Conviene aspettare Carbon o partire subito con Opus 5.5 o GPT-6.1 Sol?
Se il processo è pronto, conviene partire con un modello disponibile e costruire l'integrazione in modo da poter cambiare modello in seguito. Così, quando Carbon sarà accessibile, basterà ripetere il test sugli stessi compiti e confrontare il costo per compito riuscito.
Chi scrive
AI engineer
Sono un AI engineer: progetto e realizzo sistemi di intelligenza artificiale per le aziende, soprattutto nei processi commerciali come vendite, assistenza clienti, qualificazione dei contatti e automazione. Seguo la parte tecnica dall'inizio alla fine: configuro i server per l'AI in locale, sviluppo assistenti sui documenti e agenti, e li integro con i programmi già in uso in azienda.
Da leggere dopo
Gemini 4 Carbon: cosa cambia rispetto a Gemini 4 Argon e cosa significa per le aziende
Gemini 4 Carbon è il nuovo modello di frontiera di Google, primo negli indici indipendenti, ma per ora è riservato a pochi partner. Vediamo cosa cambia rispetto ad Argon, quanto costerà, quali dati passerebbero da Google e per quali processi ha senso aspettarlo.
AI nei processi aziendali9 min
Claude Opus 5.5 per le aziende: prezzi, migrazione da Opus 4.8 e quando serve davvero
Claude Opus 5.5 costa il 20% in meno di Opus 4.8 a token, ma ragiona sempre e cambia alcune regole delle API. Ecco prezzi, scadenze, cosa si rompe nel codice, quali dati passano da Anthropic e quando bastano Sonnet o Haiku.
AI nei processi aziendali10 min
Modelli AI piccoli o di frontiera: quale usare per ogni passaggio dei processi aziendali
Non ogni passaggio di un processo ha bisogno di un modello di frontiera. Listini, benchmark indipendenti e licenze ci dicono dove bastano i modelli AI piccoli, anche in locale, e dove il modello grande vale quello che costa.
AI nei processi aziendali12 min