Prompt injection negli agenti AI: cosa insegnano le falle di Meta Muse su posta e browser
Il bug bounty di Meta Muse ha pagato circa 1,2 milioni di $ per 64 falle valide, tra cui una pagina web che ha fatto agire l'agente senza i controlli previsti. Cosa insegna sulla prompt injection e quali permessi dare agli agenti in azienda.
 Giulio PessionePrivacy, GDPR e sovranità dei dati8 min
Pubblicato il
La prompt injection negli agenti AI è un testo nascosto in una email, una pagina web o un documento che il modello prende per un'istruzione e mette in pratica. Il bug bounty di Meta Muse ha pagato circa 1,2 milioni di $ per 64 falle valide. Tra queste c'era una pagina web che ha fatto eseguire all'agente azioni che i controlli avrebbero dovuto fermare (SecurityWeek). Secondo il NCSC britannico le difese riducono il rischio ma non lo eliminano: per questo conta soprattutto cosa l'agente può fare.
Cos'è la prompt injection negli agenti AI, e perché non è un bug come gli altri?
È un testo che il modello tratta come un ordine invece che come un dato. OWASP ne distingue due forme (OWASP LLM01:2025): diretta, quando è l'utente a scrivere il prompt che altera il comportamento del modello, e indiretta, quando l'istruzione arriva da fonti esterne, "such as websites or files". Per un agente aziendale conta soprattutto la seconda: a chi attacca basta un'email o una pagina che l'agente prima o poi leggerà.
Non si corregge una volta per tutte. Il NCSC spiega che i modelli attuali "simply do not enforce a security boundary" tra istruzioni e dati, e definisce il modello un "inherently confusable deputy", un incaricato che per come è fatto si può confondere (NCSC). Il problema è documentato almeno dal febbraio 2023, quando alcuni ricercatori hanno attaccato Bing Chat inserendo istruzioni in contenuti che il sistema avrebbe recuperato (Greshake et al., arXiv).
Con gli agenti il problema pesa di più: un chatbot ingannato sbaglia una risposta, un agente ingannato compie un'azione. La scheda CVE-2025-32711 (EchoLeak) descrive una "AI command injection" in Microsoft 365 Copilot che permetteva di far uscire informazioni, con punteggio CVSS 9,3 e senza bisogno di privilegi né di interazione dell'utente (CVE-2025-32711).
Cosa ha rivelato il bug bounty di Meta Muse su posta, browser e app?
Ha trovato falle in più strati dell'agente. Il programma, privato da aprile e pubblico dal lancio dell'8 settembre, ha ricevuto oltre 630 segnalazioni, 64 delle quali valide, per circa 1,2 milioni di $ in premi (SecurityWeek; post di David Singleton).
| Area | Premio | Cosa succedeva | Rimedio dichiarato |
|---|---|---|---|
| Browser | 90.000 $ | Una pagina imitava i messaggi di stato dello strumento di navigazione e faceva eseguire azioni all'agente | Nuovi segnali di rilevamento; i classificatori riconoscono l'attacco e 100 varianti |
| Posta | 90.000 $ | Una certa formattazione faceva passare i codici OTP oltre i filtri | Filtri OTP migliorati |
| Infrastruttura | 300.000 $ | Un controllo di autenticazione si fidava di un header aggiunto da un proxy locale | Servizio spento, falla corretta |
| App Android | 50.000 $ | Un'app malevola passava un link a una web view privilegiata senza verifica dell'host | Verifica dei link corretta |
| App Mac | 1.000 $ | Chi aveva già accesso al computer poteva sfruttare l'aggiornamento automatico | Componente aggiornato |
Fonti: SecurityWeek e Meta.
Il caso del browser è il più istruttivo: l'attacco "got the agent to execute some actions which should have been caught". Quello degli OTP mostra che un filtro si aggira cambiando la forma del testo, come OWASP ricorda citando lingue diverse e codifiche come Base64 (OWASP LLM01:2025). La falla da 300.000 $ invece non è prompt injection: ricorda che un agente è anche software tradizionale, con gli errori di sempre. Le correzioni sono dichiarate da Meta e non ho modo di verificarle in modo indipendente.
Perché Meta non paga la sola iniezione ma ciò che l'agente riesce a fare dopo?
Perché un'iniezione senza conseguenze non vale un premio. Nella tabella dei premi di Muse, consultata il 5 novembre 2026, far dire qualcosa all'agente o fargli rivelare le istruzioni di sistema vale zero. Si paga l'effetto: 300.000 $ per l'accesso alla produzione di Meta, 130.000 $ per la compromissione dell'agente di un utente, 25.000 $ per la lettura di dati privati altrui, 5.000 $ per azioni senza approvazione (tabella dei premi Muse).
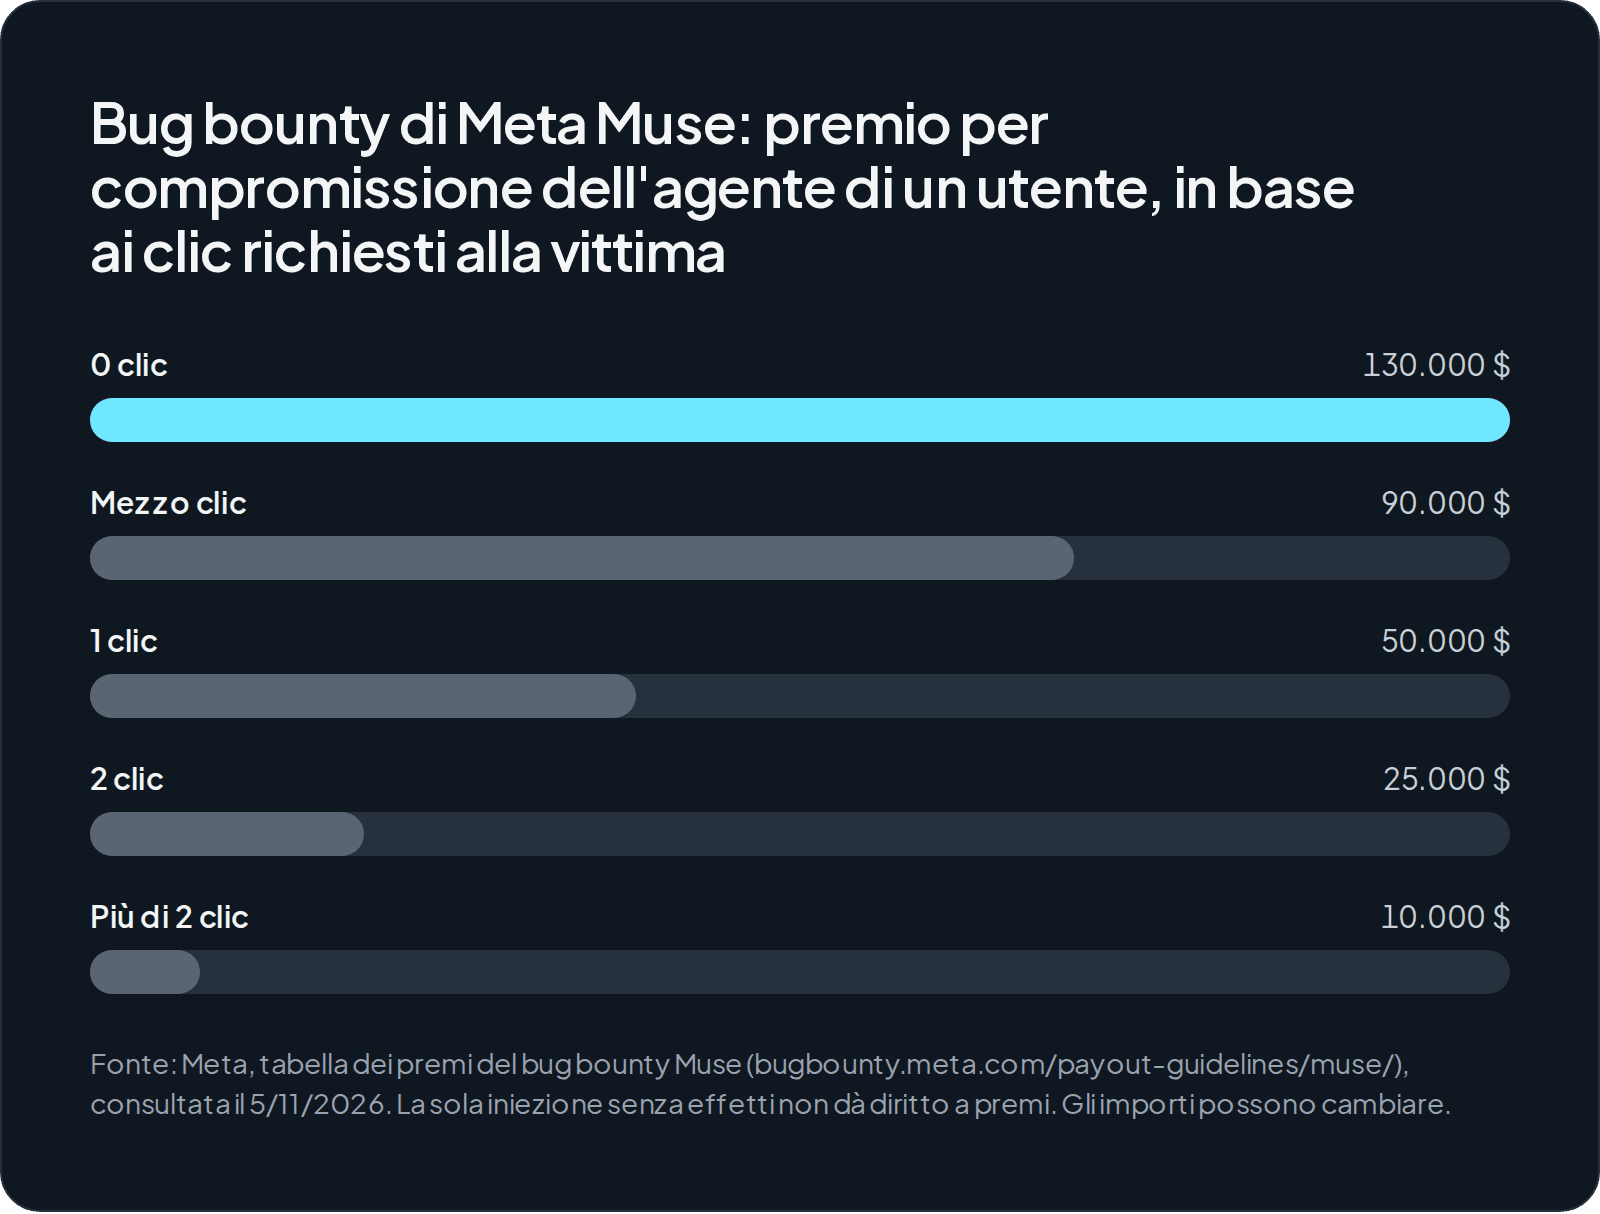
Il premio scende da 130.000 $ senza clic a 10.000 $ oltre i due clic (tabella dei premi Muse): l'attacco più grave è quello che non chiede nulla alla vittima. Un agente che legge da solo la posta in arrivo offre proprio questa possibilità.
La lezione per chi decide: il rischio si misura sui permessi. Un agente che può solo leggere e proporre bozze offre meno strade, anche se non zero; uno che può inviare, pagare o esportare ne offre molte di più.
Quanto funzionano davvero le difese, tra isolamento, classificatori e approvazioni?
Riducono molto il rischio, senza eliminarlo. Meta dichiara un'architettura articolata: una macchina virtuale dedicata per utente, un componente (Sentinel) che è "the sole permission authority" sulle azioni e sul traffico in uscita, approvazioni in una finestra separata dalla conversazione, processi che leggono dati dell'utente marcati come "tainted" e privati dell'approvazione automatica, credenziali mai mostrate all'agente (Meta). Eppure la falla del browser è passata, e i classificatori sono stati aggiornati solo dopo: le difese basate sul riconoscimento tendono a inseguire gli attacchi.
Anthropic ha pubblicato nel novembre 2025 misure sugli agenti browser dei suoi modelli di allora: con le difese migliorate gli attacchi riusciti scendevano all'1,4% per Opus 4.5, contro l'8–13,8% del solo modello senza difese aggiuntive. Aggiunge però che "No browser agent is immune to prompt injection" e che anche l'1% "still represents meaningful risk" (Anthropic). Il NCSC conclude che il rischio residuo "cannot be fully mitigated with a product or appliance" (NCSC): servono controlli a regole fisse, non elenchi di frasi vietate.
Quali dati aziendali sono esposti quando un agente legge posta esterna e naviga sul web?
Quelli che l'agente può leggere, attraverso i canali verso cui può scrivere. Un'email di un esterno diventa un canale di uscita se l'agente che la legge ha accesso ad altri dati e può spedire qualcosa fuori.
OWASP descrive altri due percorsi (OWASP LLM01:2025): il riassunto di una pagina che porta fuori la conversazione attraverso l'indirizzo di un'immagine, e un documento manipolato dentro un archivio RAG. Il secondo riguarda chi costruisce un assistente sui documenti aziendali: anche l'archivio interno è una fonte di istruzioni, se qualcuno può caricarvi file.
Sul fornitore: Meta dichiara che le conversazioni di Muse non vanno alla pubblicità, ma vengono usate per l'addestramento dopo aver rimosso le principali informazioni personali, con un'opzione per disattivarlo; non indica per quanto le conservi né dove (Meta). Muse in Italia non c'è ancora (ne ho parlato in come impostare Meta Muse), ma la lezione vale per Duet, Dots, Grok Bot e gli agenti costruiti in casa, confrontati in assistenti AI sempre attivi. Un modello open-weight sui server aziendali cambia dove finiscono i dati, non la vulnerabilità.
Cosa chiede l'AI Act sulla resistenza agli attacchi, e quando vale per un'azienda?
Per i sistemi ad alto rischio, l'articolo 15 chiede che siano "resilient against attempts by unauthorised third parties to alter their use", con misure contro input costruiti per far sbagliare il modello e attacchi alla riservatezza (AI Act, art. 15). Vale solo per l'alto rischio, che dipende dall'uso e non dalla tecnologia: un esempio è la selezione del personale. Fuori da quel perimetro restano gli obblighi di sicurezza sui dati personali (AI e GDPR). Nessuna scelta tecnica rende conformi in automatico; documentare permessi, test e registri aiuta a dimostrare di aver valutato il rischio.
Quali controlli impostare prima di lasciare un agente AI su posta, browser e gestionali?
Permessi minimi, separazione tra la parte che legge contenuti esterni e quella che agisce, approvazioni fuori dalla conversazione, registri completi. La regola del NCSC: "when an LLM processes information from a party, the privileges it has drops to that of the party" (NCSC). OWASP aggiunge contenuti esterni marcati come non attendibili, funzioni sensibili gestite nel codice e test di attacco simulato (OWASP LLM01:2025).
Gli assistenti commerciali scelgono diversamente: Muse ammette anche approvazioni permanenti (Meta), mentre secondo HackerNoon Duet "asks before it sends, pays, signs or deletes". L'approvazione permanente è comoda, ma per quell'azione toglie il controllo umano.
Una proposta di partenza, non uno standard:
| Azione dell'agente | Controllo consigliato |
|---|---|
| Leggere posta, pagine, documenti | Consentita, contenuti esterni marcati come non attendibili |
| Scrivere bozze | Consentita, la bozza resta in attesa |
| Inviare all'esterno | Approvazione per singola azione, fuori dalla chat |
| Pagare, firmare, confermare ordini | Approvazione per singola azione, mai permanente |
| Cancellare dati | Approvazione, oppure azione non concessa |
| Esportare file | Destinazioni ammesse a regole fisse, più approvazione |
I registri devono coprire input, output, strumenti e chiamate API, compresi i tentativi falliti (NCSC). Su come progettare questi limiti ho scritto in agenti AI personalizzati e agenti AI aziendali.
Da dove partire per valutare il rischio di prompt injection negli agenti che già usate?
Da un censimento, non da un prodotto: un agente collegato alla posta da un singolo dipendente ha gli stessi problemi di quelli ufficiali, ma nessuno ne conosce i permessi.
- Censite gli agenti attivi, anche quelli attivati dai dipendenti, e le fonti esterne che leggono.
- Elencate le azioni possibili: se un testo ostile prendesse il controllo, cosa farebbe senza passare da una persona?
- Togliete i permessi inutili e mettete le azioni irreversibili dietro un'approvazione fuori dalla chat.
- Verificate i registri e decidete chi li legge.
- Fate un test con email e pagine preparate apposta prima di estendere l'agente al team.
Nella valutazione iniziale si può progettare un agente con permessi minimi, con modelli di frontiera via API dove convengono, un modello in locale dove i dati non devono uscire, o entrambi; se serve, posso fornire server e software già configurati. La scelta del modello però non risolve da sola la prompt injection: a ridurla sono i permessi e i controlli attorno.
Domande frequenti
Un modello AI installato in locale è immune alla prompt injection?
No. Il NCSC spiega che i modelli linguistici attuali non separano istruzioni e dati, e questo vale anche per i modelli open-weight sui server aziendali. Il locale cambia dove finiscono i dati e chi li vede, ma un agente in locale che legge email esterne e ha permessi ampi resta attaccabile. Servono gli stessi controlli: permessi minimi, approvazioni e registri.
Si può bloccare la prompt injection con un elenco di frasi o parole vietate?
Il NCSC lo sconsiglia espressamente: gli attacchi cambiano forma, lingua o codifica, e OWASP cita anche Base64 e istruzioni nascoste nelle immagini per aggirare i filtri. Meglio controlli a regole fisse sulle azioni e sul traffico in uscita, che non dipendono da cosa c'è scritto nel testo.
Meta Muse si può usare da un'azienda italiana?
Oggi no: secondo HackerNoon (28 ottobre 2026) Muse è disponibile in Stati Uniti, Canada e Messico, con un piano gratuito a limite settimanale e piani da 20 e 100 $. Le lezioni del suo bug bounty valgono però per qualunque agente su posta e browser, compresi quelli disponibili in Italia.
Cosa fare se un agente ha eseguito un'azione che nessuno aveva chiesto?
Sospendere l'agente e revocare le autorizzazioni e i token collegati, conservare i registri di input, output e strumenti usati, e ricostruire quale contenuto esterno ha letto prima dell'azione. Se sono coinvolti dati personali va valutato con il DPO se si tratta di una violazione da notificare, come si fa per qualunque incidente sui dati.
I programmi di bug bounty dicono che un agente è sicuro?
Dicono che il fornitore cerca e corregge le falle, ed è un buon segnale. Non dicono che le falle sono finite: Muse ha avuto 64 segnalazioni valide in pochi mesi, e Anthropic scrive che nessun agente browser è immune. Vanno letti come un indizio di serietà, non come una garanzia.
Chi scrive
AI engineer
Sono un AI engineer: progetto e realizzo sistemi di intelligenza artificiale per le aziende, soprattutto nei processi commerciali come vendite, assistenza clienti, qualificazione dei contatti e automazione. Seguo la parte tecnica dall'inizio alla fine: configuro i server per l'AI in locale, sviluppo assistenti sui documenti e agenti, e li integro con i programmi già in uso in azienda.
Da leggere dopo
Come impostare Meta Muse: configurazione, Gmail e Calendar, e perché in Italia non c'è ancora
Meta Muse è un agente che lavora su Gmail, Calendar e altre app da un computer dedicato nel cloud. Ecco come si configura, quali impostazioni di privacy controllare, cosa ha insegnato il caso dei link condivisi e come un'azienda italiana si prepara mentre qui non è disponibile.
AI nei processi aziendali12 min
Assistenti AI sempre attivi: Duet vs Dots vs Grok Bot vs Muse
Claude Duet, OpenAI Dots, Grok Bot e Meta Muse lavorano in background su posta, calendario e app. Ecco cosa fanno davvero, a chi sono disponibili, quanto costano e quali dati aziendali passano dai fornitori.
AI nei processi aziendali9 min
Come creare un agente AI per l'azienda: dal processo da ottimizzare al primo flusso in produzione
Per creare un agente AI si parte dal processo, non dallo strumento. Vediamo come scegliere il primo flusso, quando basta un workflow, quale modello usare per ogni passaggio, quali dati escono dall'azienda e quali controlli servono prima della produzione.
AI nei processi aziendali10 min